
L’actualité tech du jour met en lumière un développement significatif.
Guide de programmation pour TypeSafe AI Jev : décisions typées, confiance calibrée et fan-out spéculatif avec un modèle d’IA « System One »
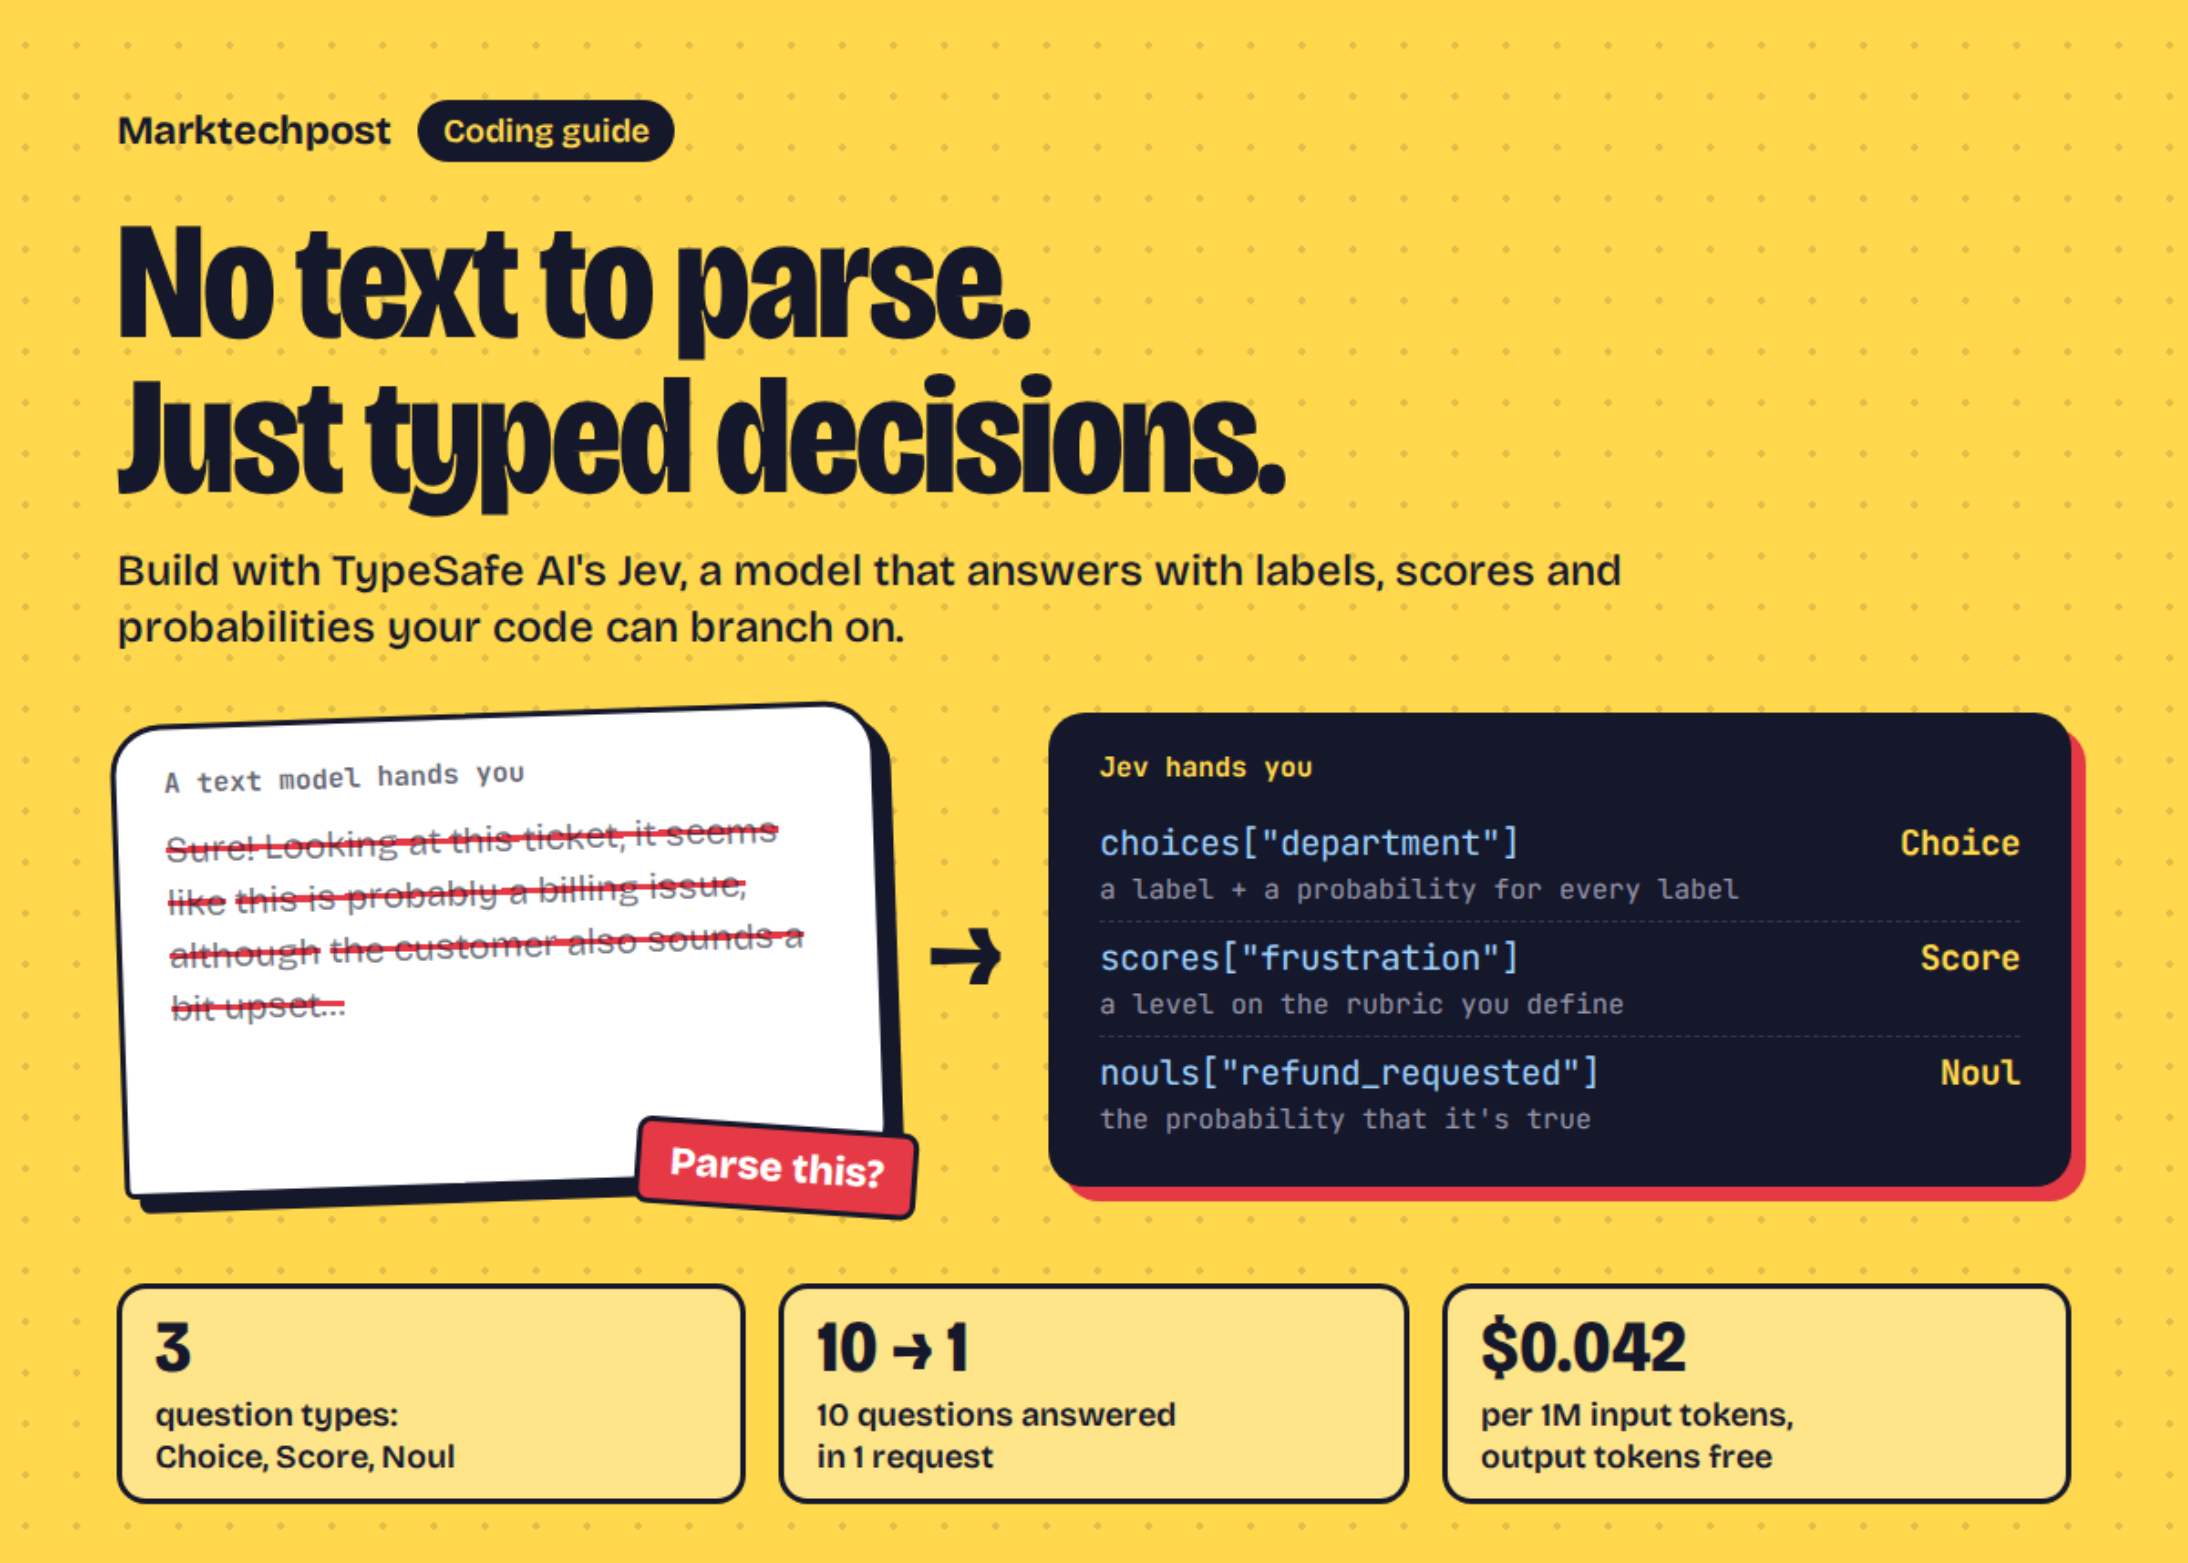
Dans ce tutoriel, nous utilisons Jev, le premier modèle « System One » de TypeSafe AI, qui ne génère aucun texte : nous lui transmettons un état du programme et un ensemble de questions typées, et il renvoie des choix, des scores et des probabilités « oui/non » sur lesquels notre code peut directement s’appuyer pour se ramifier. Nous installons le SDK officiel de Python, effectuons un premier appel utilisant simultanément les trois primitives de question, puis observons comment la structure de l’état modifie les informations dont dispose le système. Nous recalculons ensuite la statistique de confiance publiée à partir des probabilités renvoyées, nous évaluons les gains obtenus en regroupant dix questions en un seul appel par rapport à dix appels distincts, et nous mettons en place les mécanismes pour lesquels l’API a été conçue : routage basé sur la confiance, notation composite avec des pondérations définies dans le code, appels de fonctions typées, et comptage effectué selon la méthode propre au modèle. Nous terminons par la structure de production : des modèles de réponse Pydantic, un client asynchrone déployé via asyncio, des politiques de réessai, des erreurs typées et un registre actif qui évalue l’ensemble du notebook.
En complément, nous installons typesafe-sdk, en le fixant à la version utilisée lors de la rédaction de ce notebook, et chargeons la clé API à partir de l’environnement, de l’onglet « Secrets » de Colab ou d’une invite masquée, afin qu’elle n’apparaisse jamais dans le notebook. TypeSafeClient lit automatiquement la variable TYPESAFE_API_KEY et utilise par défaut l’alias « jev-latest » ; la liste des modèles indique les noms et les versions fixées que la clé peut utiliser. La petite fonction d’aide « ask » encapsule « system_one » de manière à ce que chaque appel effectué dans le reste du notebook soit chronométré et que sa consommation de jetons soit consignée dans un registre dont nous calculons le total à la fin.
Une requête System One comporte deux parties : l’état, qui peut être un texte, un objet JSON ou un tableau décrivant la situation, et un dictionnaire de questions nommées. La fonction « Choice » sélectionne une étiquette parmi les critères que nous définissons et renvoie une probabilité pour chaque étiquette ; la fonction « Score » classe l’état selon une grille d’évaluation ordonnée et renvoie le niveau pondéré par la probabilité, ce qui signifie qu’il peut se situer entre deux niveaux ; la fonction « Noul » renvoie une seule probabilité indiquant qu’une affirmation est vraie. Les noms des requêtes sont les nôtres et ne sont jamais transmis au système ; c’est pourquoi les instructions véhiculent tout le sens et peuvent pointer vers des champs imbriqués à l’aide de chemins entre guillemets inversés. Les quatre requêtes sont traitées en une seule requête, en parallèle et indépendamment les unes des autres, et la réponse indique la version du modèle épinglée qui a fourni la réponse ainsi que les jetons facturés.
Dans la foulée, l’état est la seule information dont dispose le modèle d’IA ; nous lui posons donc une seule question : le client a-t-il droit à un remboursement conformément à la politique écrite de l’entreprise ? Pour cela, nous utilisons trois types d’état différents. Une chaîne de caractères simple contient uniquement la réclamation ; un tableau ajoute la conversation ; l’objet JSON ajoute la commande avec ses deux montants enregistrés ainsi que la politique de remboursement elle-même. La question reste toujours la même ; par conséquent, toute différence observée dans la probabilité renvoyée est imputable à l’état, et la colonne « token » indique le coût supplémentaire lié au contexte. Les champs nommés constituent la recommandation officielle lorsque le contexte comporte plusieurs parties, car les instructions peuvent alors y faire référence par leur nom.
TypeSafe calcule la confiance sous forme d’une statistique dérivée de la distribution déjà contenue dans la réponse : le nombre d’options multiplié par la probabilité maximale, moins un, divisé par le nombre d’options moins un. Nous la recalculons à partir des probabilités d’un choix et la comparons au champ « Confiance », puis nous recalculons le score en additionnant chaque niveau multiplié par sa probabilité. Le fait de comparer un message direct et un message délibérément vague à travers ces deux mêmes questions montre comment la distribution, et donc le niveau de confiance, réagit à l’ambiguïté. Un « Noul » ne comporte aucun intervalle de confiance, puisque sa valeur correspond déjà à la probabilité d’un « oui », et une valeur proche de 0,5 signifie « indécis » plutôt que « modéré ».
Comme les questions d’une même requête ne se chevauchent pas, nous pouvons poser d’emblée toutes les questions dont nous pourrions avoir besoin, y compris celles qui ne concernent qu’une seule branche, puis ne lire que les réponses pertinentes par la suite. Nous regroupons dix questions concernant l’analyse rétrospective d’un incident — deux « Choices », deux « Scores » et six « Nouls » — dans un seul appel, puis nous posons chacune d’entre elles à nouveau dans un appel distinct, et nous comparons le temps d’exécution, les jetons d’entrée et les réponses. L’état est envoyé une seule fois au lieu de dix, ce qui explique à la fois la réduction de la latence et l’économie de jetons ; de plus, la colonne « accord » vérifie directement la déclaration d’isolation : une question devrait recevoir la même réponse, qu’elle soit transmise avec d’autres ou non.
Cette actualité s’inscrit dans une dynamique plus large qui mérite d’être suivie.
À lire également :
- Tables rondes : les défaillances mortelles du mur frontalier virtuel
- Le programme du Founder Summit dévoilé | TechCrunch
- « On mène déjà le combat d’hier » : le Premier ministre grec s’exprime sans détours sur l’IA | TechCrunch
Information publiée en premier lieu par MarkTechPost : MarkTechPost