Alibaba Qwen lance Qwen-Audio-3.1-Realtime : un modèle vocal en duplex intégral entraîné à réfléchir, agir et décider quand parler
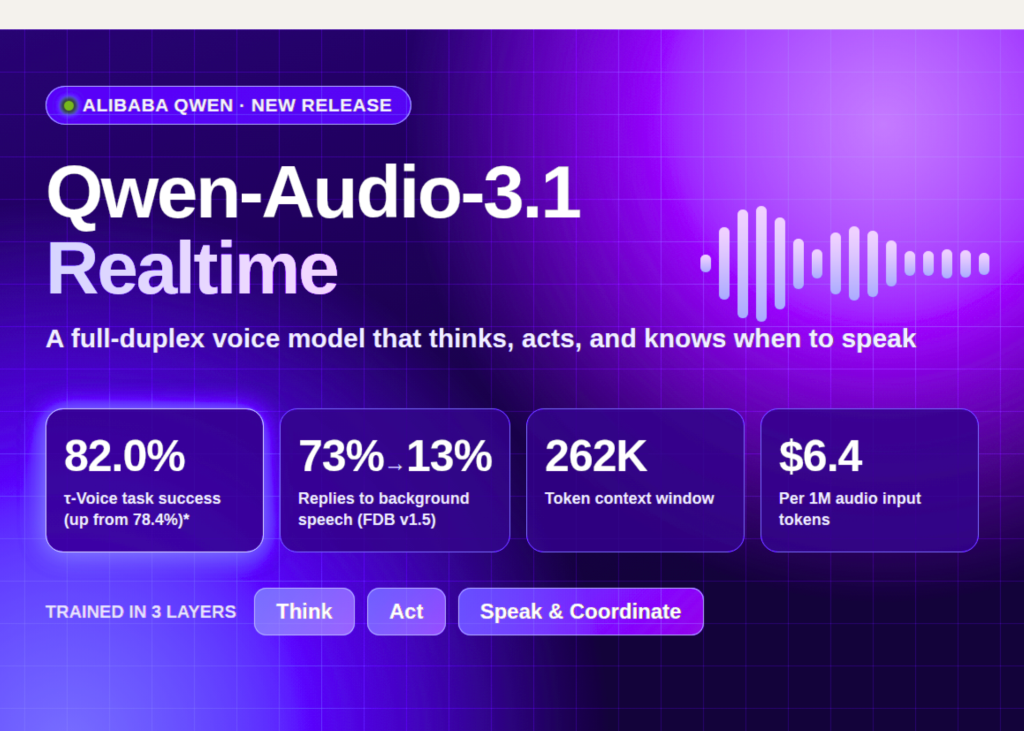
Alibaba Qwen lance Qwen-Audio-3.1-Realtime : un modèle vocal en duplex intégral entraîné à réfléchir, agir et décider quand parler

Nouvelle information marquante dans l’actualité IA. Alibaba Qwen lance Qwen-Audio-3.1-Realtime : un modèle vocal en duplex intégral entraîné à réfléchir, agir et décider quand parler L’équipe Qwen d’Alibaba a lancé Qwen-Audio-3.1, une pile audio composée de cinq modèles couvrant la reconnaissance vocale (ASR), la synthèse vocale (TTS) et l’interaction en temps réel. Le modèle principal … Lire la suite
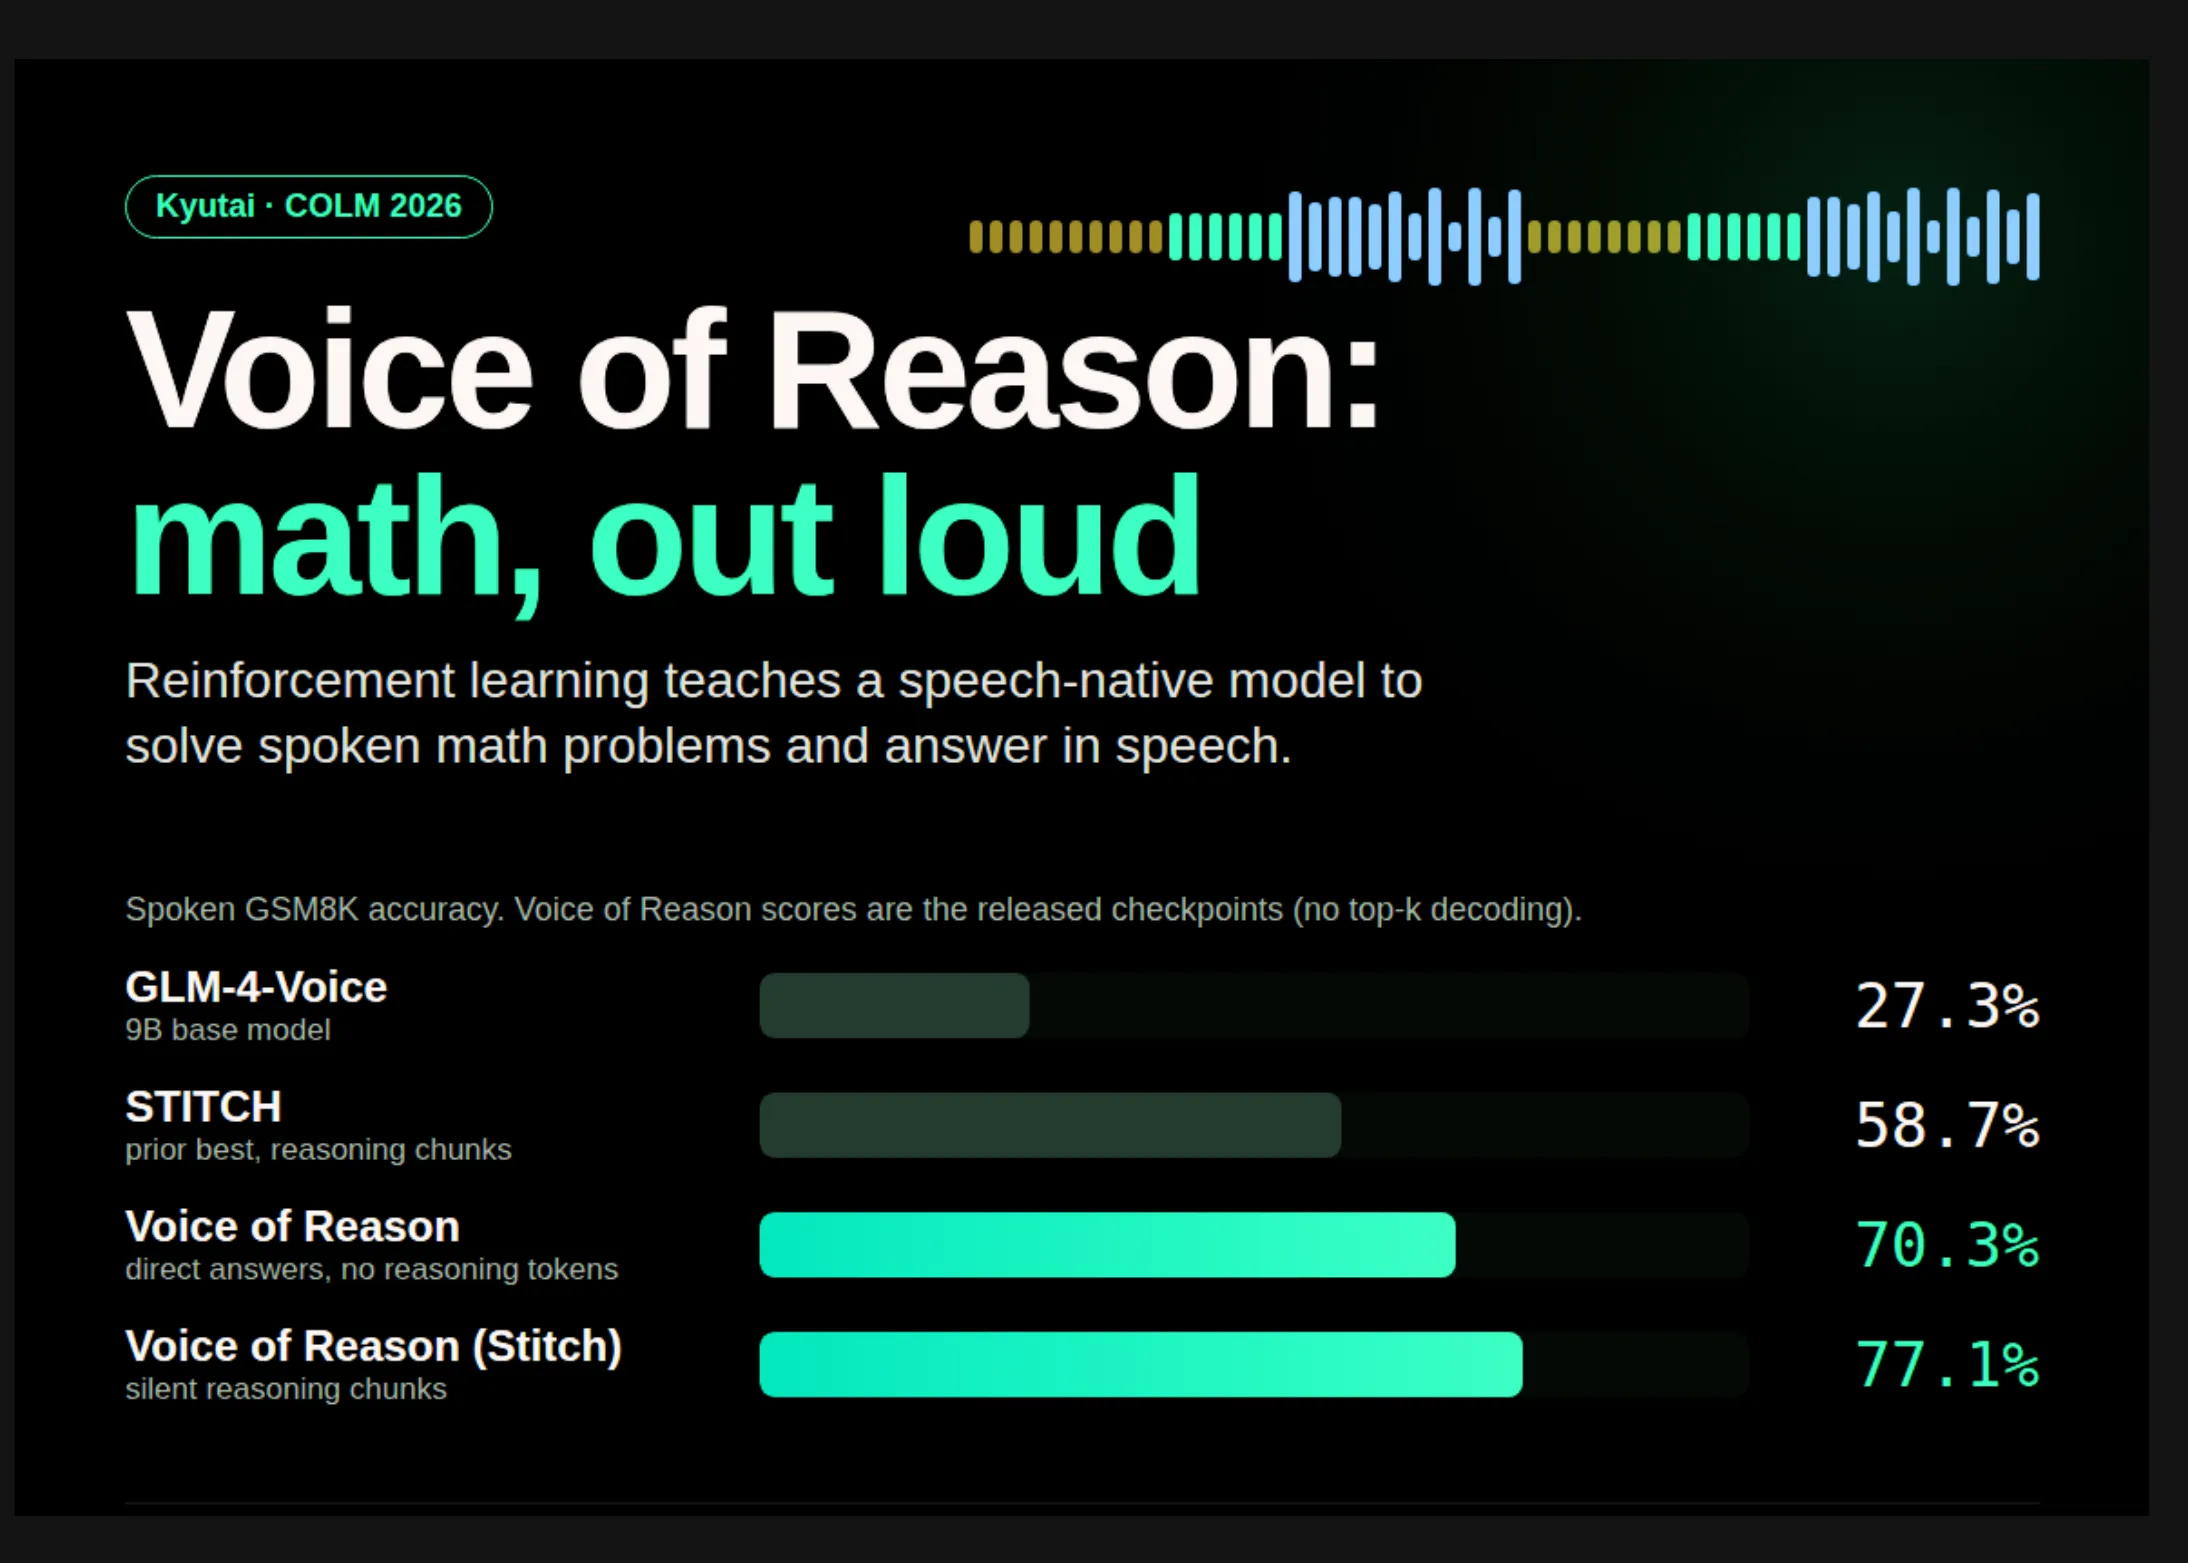
Kyutai lance « Voice of Reason » : un modèle « speech-native » capable de résoudre des problèmes mathématiques oraux grâce à l’apprentissage par renforcement

Kyutai lance « Voice of Reason » : un modèle « speech-native » capable de résoudre des problèmes mathématiques oraux grâce à l'apprentissage par renforcement

L’intelligence artificielle reste au cœur de toutes les attentions. Kyutai lance « Voice of Reason » : un modèle « speech-native » capable de résoudre des problèmes mathématiques oraux grâce à l’apprentissage par renforcement Kyutaihas a lancé « Voice of Reason », deux modèles de synthèse vocale de poids ouvert capables de résoudre des problèmes … Lire la suite

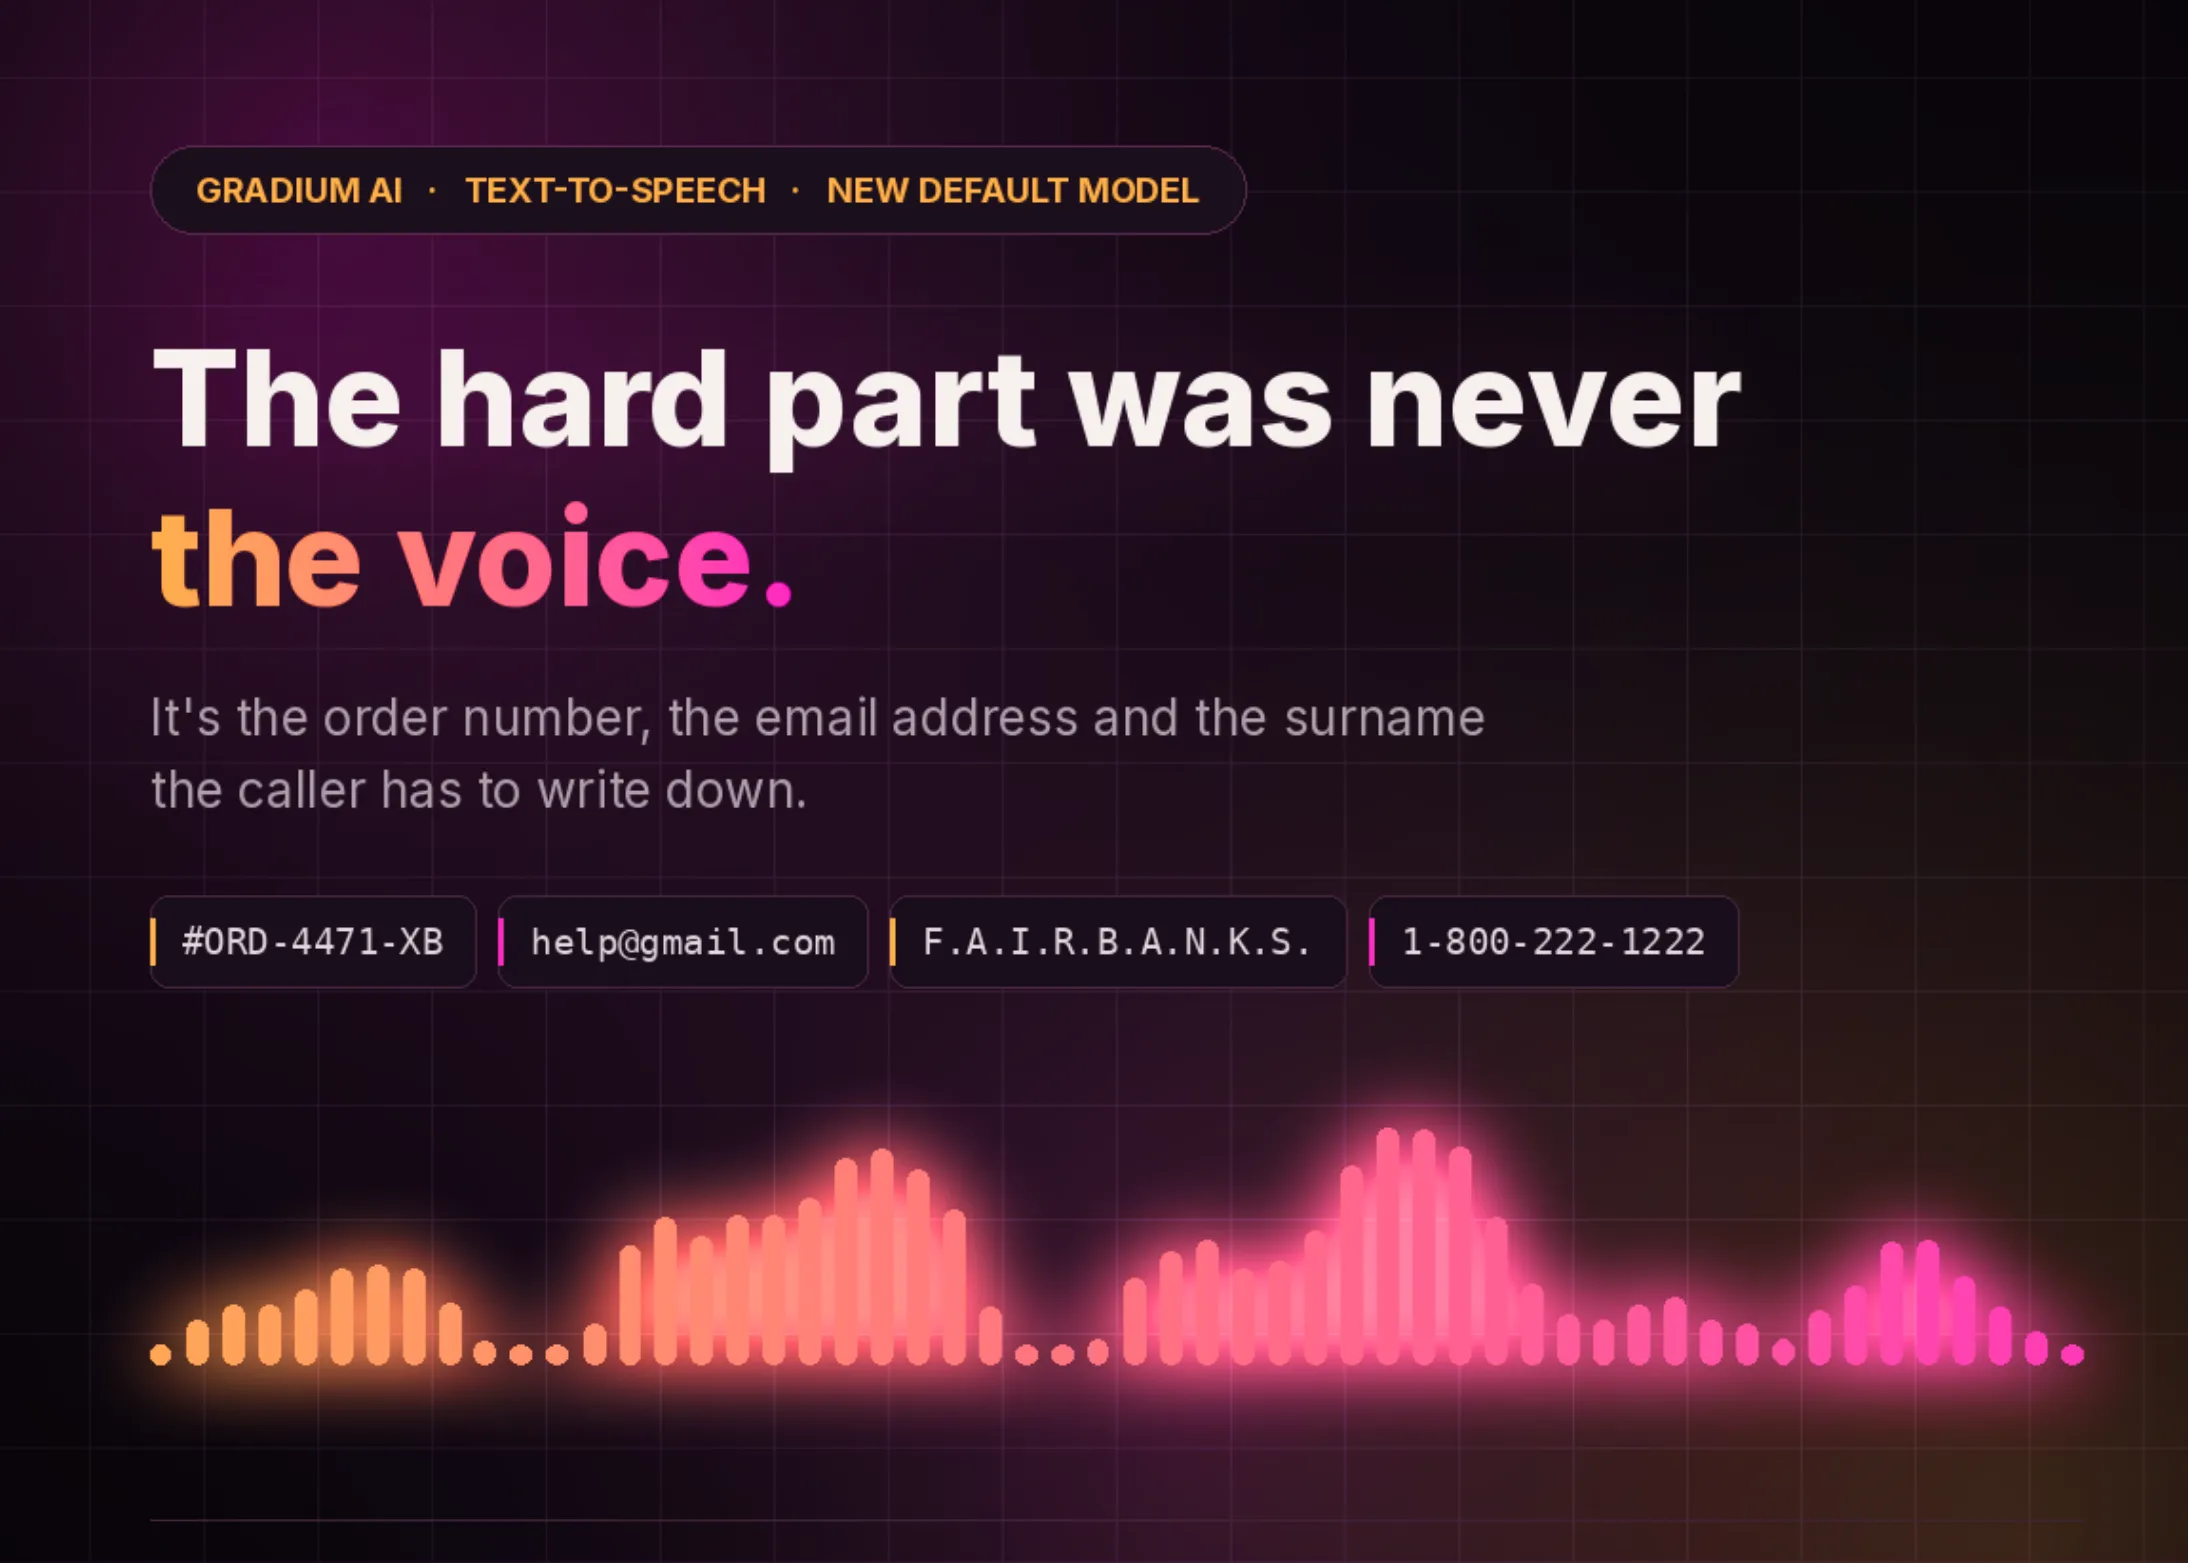
Gradium AI lance un nouveau modèle TTS par défaut : un taux de réussite de 81,0 % dans les cas difficiles avec un délai de 216 ms jusqu’au premier son

Gradium AI lance un nouveau modèle TTS par défaut : un taux de réussite de 81,0 % dans les cas difficiles avec un délai de 216 ms jusqu’au premier son

Un nouveau jalon vient d’être franchi dans l’univers de l’intelligence artificielle. Gradium AI lance un nouveau modèle TTS par défaut : un taux de réussite de 81,0 % dans les cas difficiles avec un délai de 216 ms jusqu’au premier son Les assistants vocaux échouent précisément sur les éléments les plus importants d’un appel : … Lire la suite

La société indienne Ringg bénéficie du soutien de Peak XV alors qu’elle étend l’IA vocale au-delà des appels téléphoniques | TechCrunch

La société indienne Ringg bénéficie du soutien de Peak XV alors qu'elle étend l'IA vocale au-delà des appels téléphoniques | TechCrunch

L’actualité du jour apporte un éclairage intéressant sur l’évolution du domaine. La société indienne Ringg bénéficie du soutien de Peak XV alors qu’elle étend l’IA vocale au-delà des appels téléphoniques | TechCrunch Selon une étude récente de Truecaller, plus de 76 % des consommateurs indiens préfèrent communiquer avec les entreprises par téléphone. La voix restant … Lire la suite

Cartesia lance Sonic-3.6 : un modèle d’IA de synthèse vocale en streaming qui domine désormais les deux principaux champs d’application de la synthèse vocale artificielle

Cartesia lance Sonic-3.6 : un modèle d'IA de synthèse vocale en streaming qui domine désormais les deux principaux champs d'application de la synthèse vocale artificielle

Le secteur technologique continue de livrer des avancées remarquables. Cartesia lance Sonic-3.6 : un modèle d’IA de synthèse vocale en streaming qui domine désormais les deux principaux champs d’application de la synthèse vocale artificielle Cartesia a lancé Sonic-3.6, la toute dernière version de son modèle de synthèse vocale en temps réel. Elle arrive environ trois … Lire la suite

Comment nous avons mis au point en six mois un système en temps réel pour une IA vocale réactive

Comment nous avons mis au point en six mois un système en temps réel pour une IA vocale réactive

Les dernières heures ont apporté leur lot d’informations dans l’écosystème IA. Comment nous avons mis au point en six mois un système en temps réel pour une IA vocale réactive Par Justin Uberti et Zahan Malkani, membres du personnel technique En matière d’IA vocale, savoir quand prendre la parole est plus difficile qu’il n’y paraît. … Lire la suite

PolyAI lance Dialog-RSN-1 : un modèle de dialogue natif audio qui intègre la gestion des tours de parole, la reconnaissance vocale, l’appel de fonctions et la réponse

PolyAI lance Dialog-RSN-1 : un modèle de dialogue natif audio qui intègre la gestion des tours de parole, la reconnaissance vocale, l'appel de fonctions et la réponse

Une évolution notable vient d’être rendue publique dans le domaine. PolyAI lance Dialog-RSN-1 : un modèle de dialogue natif audio qui intègre la gestion des tours de parole, la reconnaissance vocale, l’appel de fonctions et la réponse PolyAI a lancé Dialog-RSN-1, un système de dialogue qui perçoit directement le son de l’appelant au lieu de … Lire la suite

OpenAI lance GPT-Realtime-2.1 et GPT-Realtime-2.1-mini pour les agents vocaux à faible latence via son API

OpenAI lance GPT-Realtime-2.1 et GPT-Realtime-2.1-mini pour les agents vocaux à faible latence via son API

Le domaine de l’IA connaît encore aujourd’hui une évolution intéressante. OpenAI lance GPT-Realtime-2.1 et GPT-Realtime-2.1-mini pour les agents vocaux à faible latence via son API OpenAI a lancé deux nouveaux modèles « Realtime » via son API. Ils s’appellent « gpt-realtime-2.1 » et « gpt-realtime-2.1-mini ». Tous deux sont destinés aux expériences vocales et multimodales … Lire la suite

OpenClaw lance des applications compagnons pour iOS et Android permettant de connecter un téléphone à une passerelle d’agent IA auto-hébergée

OpenClaw lance des applications compagnons pour iOS et Android permettant de connecter un téléphone à une passerelle d'agent IA auto-hébergée

L’intelligence artificielle reste au cœur de toutes les attentions. OpenClaw lance des applications compagnons pour iOS et Android permettant de connecter un téléphone à une passerelle d’agent IA auto-hébergée Cet assistant open source connecte les téléphones à une passerelle auto-hébergée, ajoutant ainsi des fonctionnalités de caméra, de localisation, de commande vocale et de Canvas à … Lire la suite

Gradium lance « stt-translate » et « s2s-translate », des modèles de traduction vocale en temps réel qui surpassent « gpt-realtime-translate » en termes de précision et de latence

Gradium lance « stt-translate » et « s2s-translate », des modèles de traduction vocale en temps réel qui surpassent « gpt-realtime-translate » en termes de précision et de latence

Le secteur de l’IA vient d’être le théâtre d’un développement notable. Gradium lance « stt-translate » et « s2s-translate », des modèles de traduction vocale en temps réel qui surpassent « gpt-realtime-translate » en termes de précision et de latence Gradium a lancé aujourd’hui deux modèles de traduction vocale en temps réel : « stt-translate … Lire la suite