
L’intelligence artificielle reste au cœur de toutes les attentions.
Kyutai lance « Voice of Reason » : un modèle « speech-native » capable de résoudre des problèmes mathématiques oraux grâce à l’apprentissage par renforcement
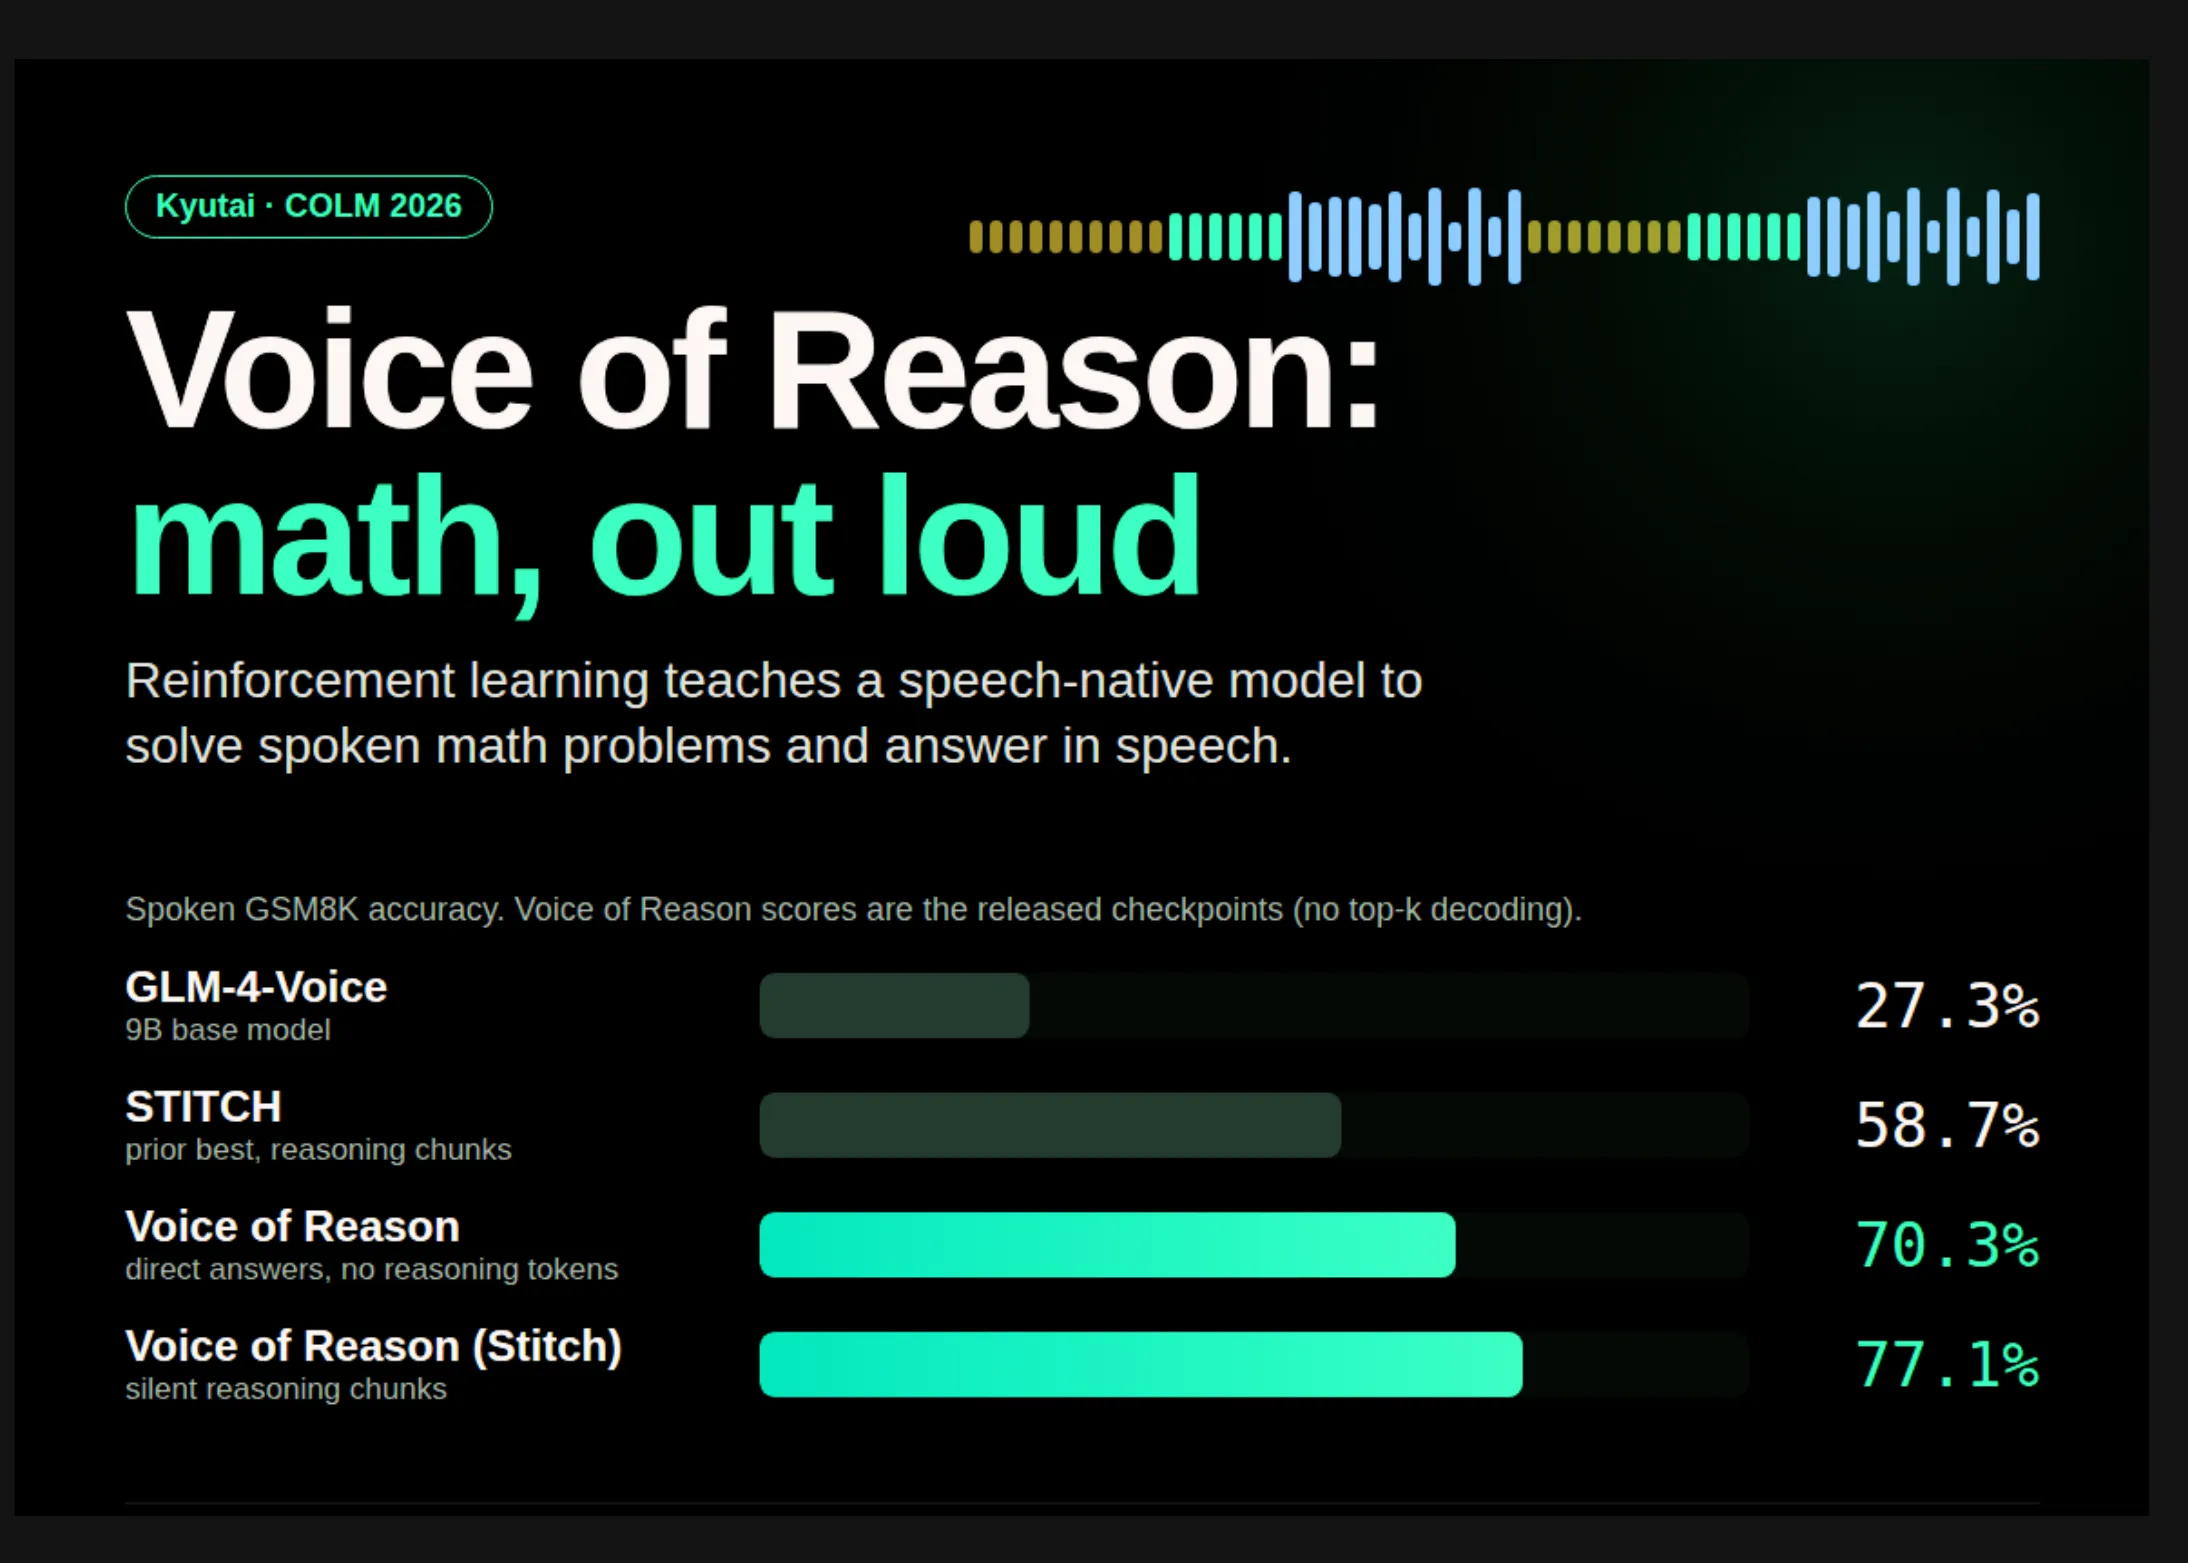
Kyutaihas a lancé « Voice of Reason », deux modèles de synthèse vocale de poids ouvert capables de résoudre des problèmes mathématiques à voix haute. Tous deux partent du modèle d’IA GLM-4-Voice-9 et intègrent un affinage supervisé (SFT) par conséquent qu’un apprentissage par renforcement (RL). Il n’y a pas d’étape de transcription ni de LLM textuel distinct dans la boucle. Sur le corpus GSM8K parlé, la précision passe de 27,3 % pour le modèle de base à 77,1 %.
Est-ce qu’il est déployable ? Oui, pour un hébergement autonome. Kyutai a exécuté les deux checkpoints BF16 sur un seul H100. Vous aurez également besoin du dépôt GLM-4-Voice pour son tokeniseur et son décodeur vocaux. Les poids héritent de la licence GLM-4-Voice, et aucun fournisseur d’inférence Hugging Face ne les héberge pour l’instant.
Si l’on supprime le « top-k », on obtient respectivement 70,3 % et 77,1 %.
Les chaînes de traitement en cascade (reconnaissance vocale, modèle de langage de grande envergure, synthèse vocale) restent les plus performantes en matière de raisonnement. Cependant, chaque étape ajoute de la latence, et la chaîne perd des indices paralinguistiques tels que le ton. Les modèles natifs pour la parole doivent émettre du son à intervalles réguliers pour rester interactifs. Cela limite le nombre de tokens de raisonnement cachés qu’ils peuvent se permettre.
Précisons, le modèle de base GLM-4-Voice obtient un score de 27,3 % sur GSM8K. La méthode STITCH, développée précédemment, a permis de porter ce score à 58,7 % grâce à l’ajout d’éléments de raisonnement. L’équipe de exploration présente ses travaux comme la première application de l’apprentissage par renforcement (RL) au raisonnement mathématique dans des modèles de traitement de la parole natifs.
GLM-4-Voice entrelace ses données de sortie : 13 tokens de texte, puis 26 tokens audio, et ainsi de suite.
Les récompenses sont centrées au sein de chaque groupe, formant ainsi un objectif REINFORCE relatif au groupe. Ce modèle est apparenté à GRPO, mais supprime l’écrêtage PPO et la régularisation KL. L’entraînement a été réalisé sur 16 GPU H100, avec 1 500 mises à jour d’apprentissage par renforcement.
Précisons, les résultats présentés dans l’article utilisent un décodage « top-k 50 », dont la moyenne est calculée sur 3 graines. Si l’on supprime le « top-k », on obtient respectivement 70,3 % et 77,1 %. Les points de contrôle publiés correspondent à ces exécutions. Les systèmes « omni » et « en cascade » sont représentés par des lignes supérieures plus épaisses ; il ne s’agit pas de comparaisons directes.
Les points essentiels à retenir :
- GLM-4-Voice entrelace ses données de sortie : 13 tokens de texte, puis 26 tokens audio, et ainsi de suite.
- Les récompenses sont centrées au sein de chaque groupe, formant ainsi un objectif REINFORCE relatif au groupe.
- Si l’on supprime le « top-k », on obtient respectivement 70,3 % et 77,1 %.
Reste à voir comment l’industrie va réagir à cette annonce.
Dans le même ordre d’idées :
- Nums AI lance Causilo : un système de base tabulaire qui arrive en tête du classement TabArena parmi les modèles individuels
- Comment Fyxer a mis au point un assistant exécutif basé sur l’IA qui inspire confiance
- Meta présente ZGateway : une couche de proxy sans état qui unifie le trafic ZippyDB et traite plus d’un milliard d’opérations par seconde
Via MarkTechPost : MarkTechPost