Une évolution notable vient d’être rendue publique dans le domaine.
Edge0 lance Audio8-TTS-Realistic, un modèle de synthèse vocale par clonage de voix de 0,6 milliard de paramètres
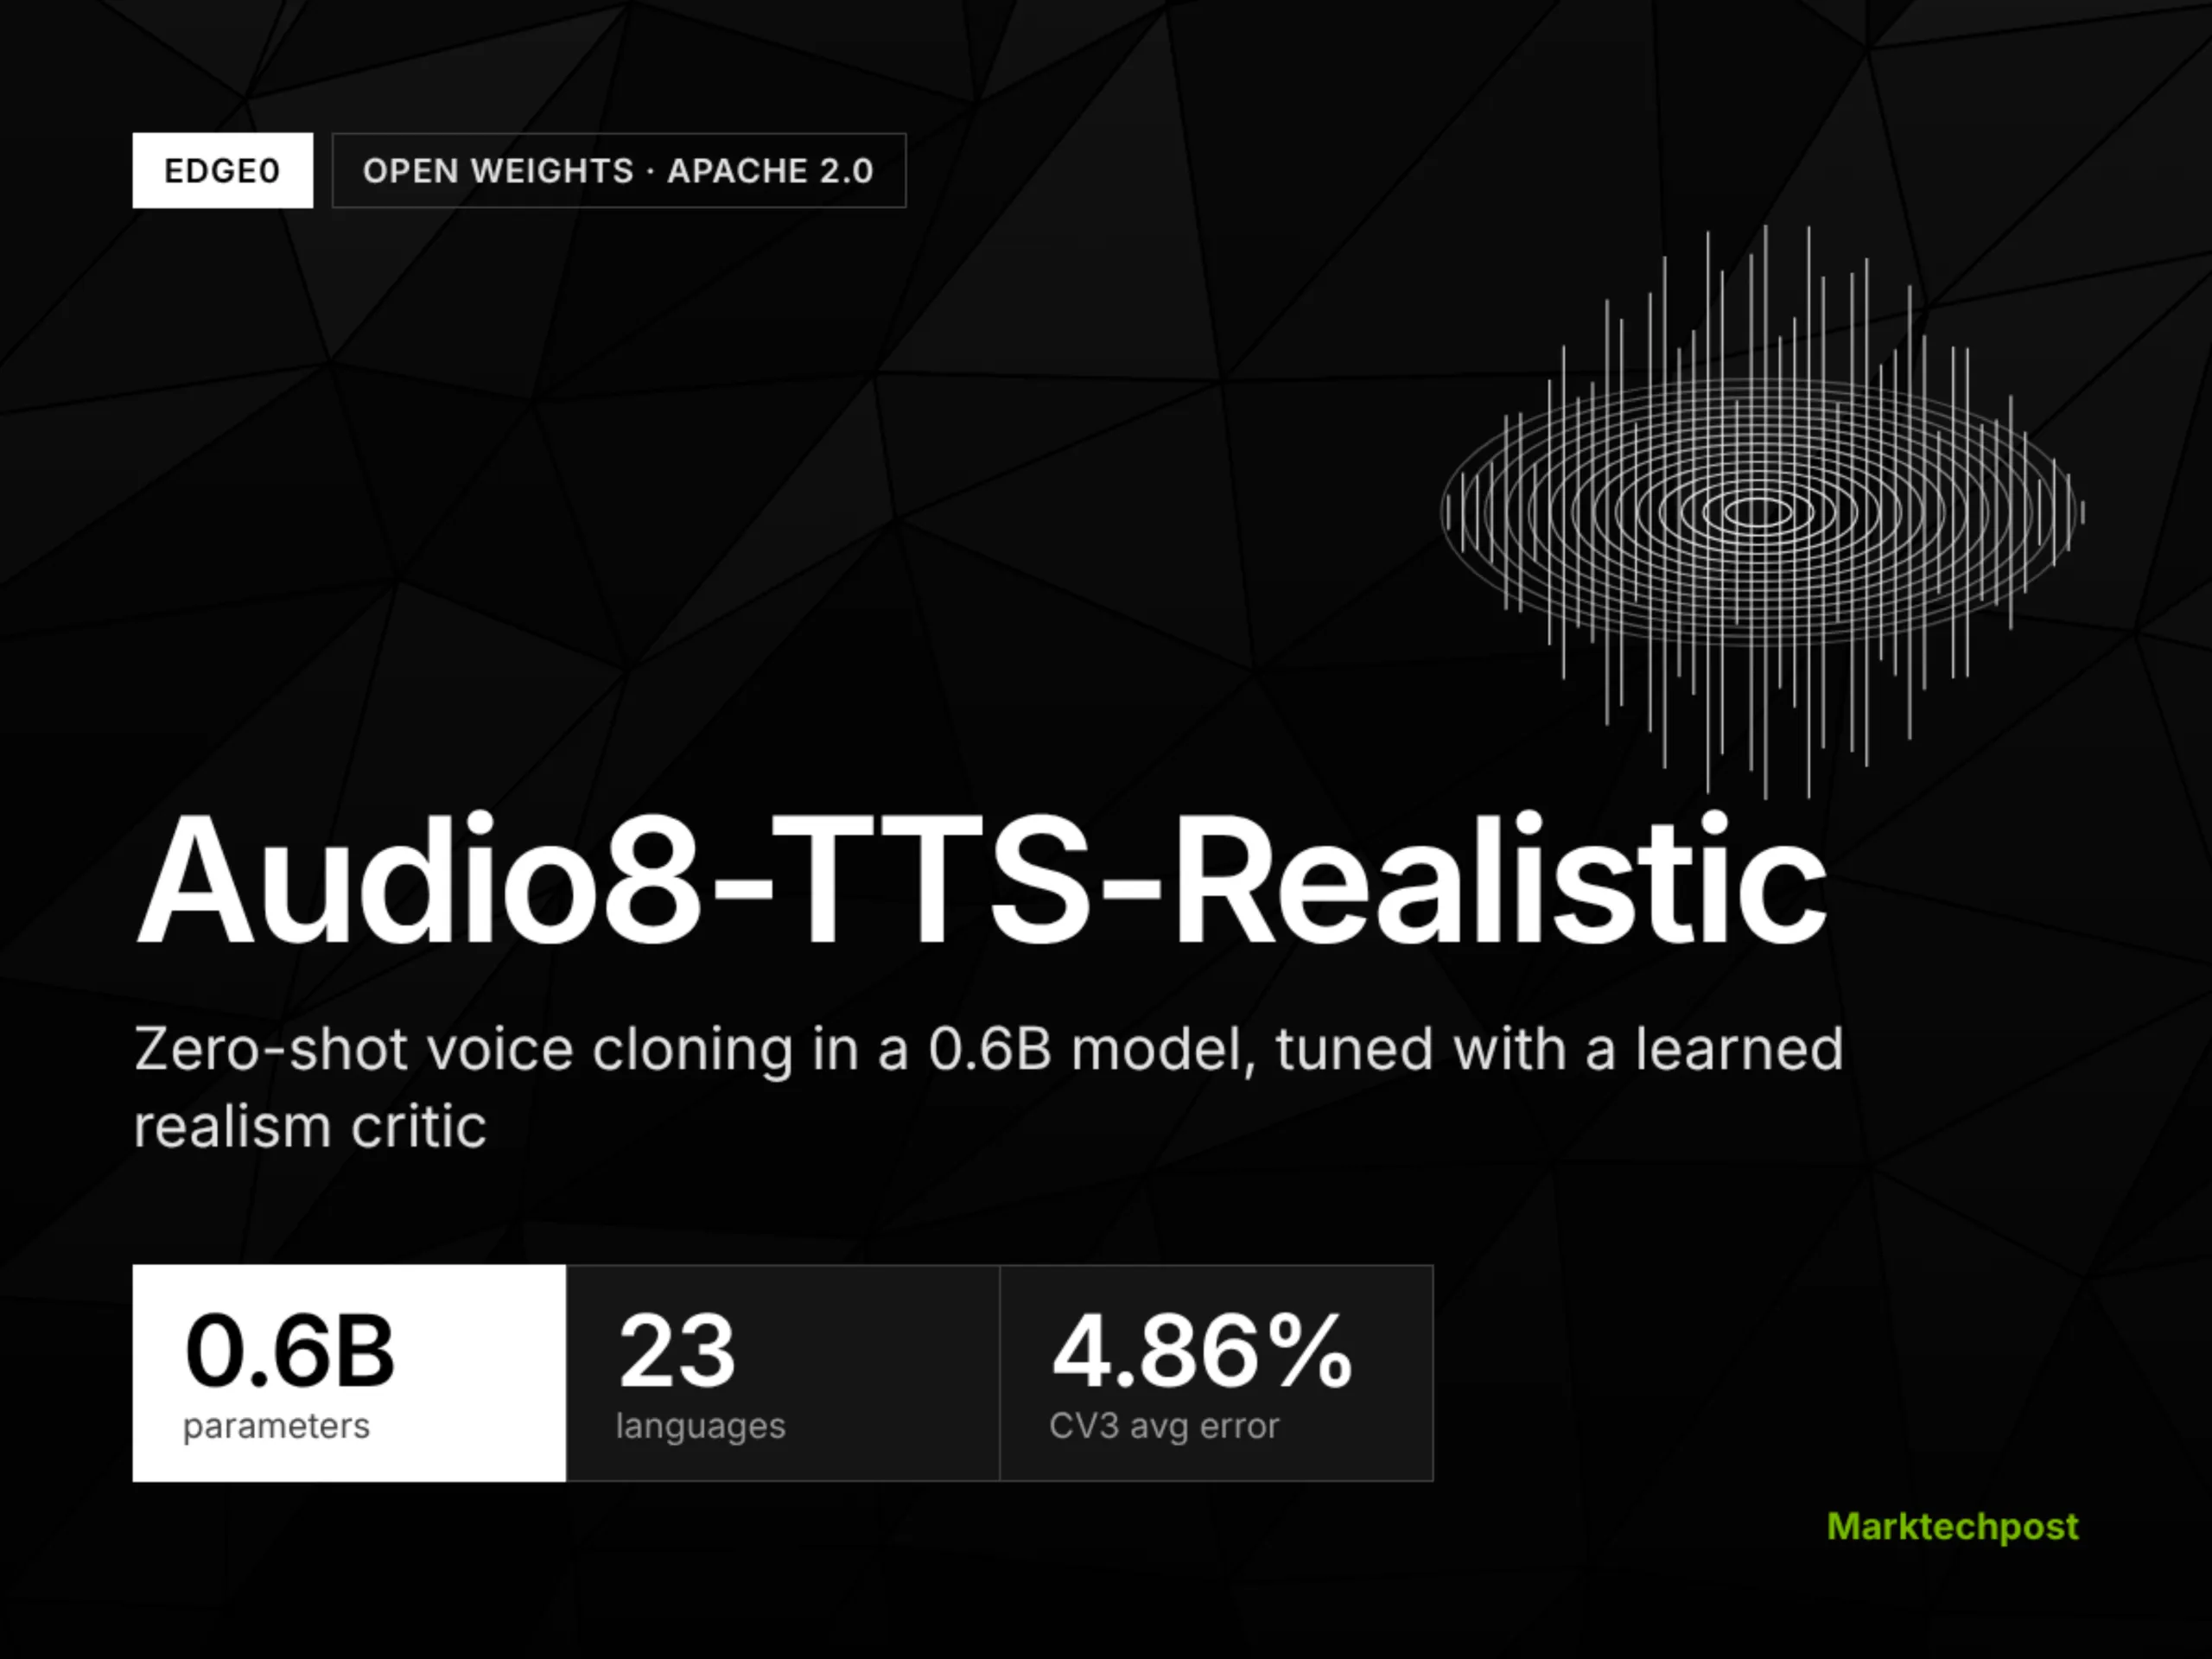
Edge0 a lancé Audio8-TTS-Realistic, un modèle de synthèse vocale à poids ouvert destiné au clonage vocal « zero-shot ». Audio8-TTS-Realistic est un modèle d’IA de 0,6 milliard de paramètres capable de cloner une voix à partir d’un seul extrait audio de référence et d’une transcription. Il prend en charge 23 langues, soit 12 de plus que son prédécesseur. Les poids et le code sont distribués sous licence Apache 2.0. Pour les développeurs, l’intérêt réside dans une précision multilingue compétitive, associée à une taille qui rend possible un réglage fin et une mise en service à moindre coût.
Il s’agit de la deuxième version 0.6B de la famille Audio8 TTS d’Edge0. Elle s’appuie sur Audio8-TTS-Preview-0.6b et conserve la même interface d’inférence Transformers. Le référentiel regroupe le point de contrôle, un codec audio neuronal à 44,1 kHz, un tokeniseur, un processeur et du code personnalisé. Il autorise également de générer de la parole sans voix de référence.
Le critique note chaque sortie en la comparant à un enregistrement humain correspondant de la même phrase.
Point notable, les nouvelles langues sont l’arabe, le finnois, l’hindi, l’indonésien, le malais, le norvégien, le portugais, le russe, le suédois, le thaï, le turc et le vietnamien.
En complément, le système utilise une architecture autorégressive double (DualAR) inspirée du Fish Audio S2 Pro. Selon le rapport de travaux de recherche technique, la branche lente repose sur Qwen2.5 0.5B. Elle comporte 24 couches d’une largeur de 896 et fonctionne à environ 21,5 images par seconde. À chaque étape, le modèle prédit des tokens de texte de cette manière que le premier livre de codes audio.
Une branche rapide à quatre couches peu profonde prédit ensuite les 9 codebooks restants en parallèle. Le calcul séquentiel n’intervient donc qu’au niveau de la trame.
L’équipe fait valoir que le taux d’erreur sur les mots (WER) et la similarité entre locuteurs (SIM) ne tiennent pas compte du rythme, des pauses et du timing. Un système peut obtenir de bons performances sur ces deux critères tout en donnant l’impression d’être synthétique.
Par ailleurs, le critique note chaque sortie en la comparant à un enregistrement humain correspondant de la même phrase. Le système a été entraîné à partir d’une échelle de qualité établie à partir de 6 systèmes de synthèse vocale open source. Ceux-ci ont été classés dans le cadre d’une étude d’écoute à l’aveugle privée, les enregistrements humains occupant les premières places. La compression synthétique des pauses ajoute des échelons plus fins à cette échelle.
Une perte liée à l’effacement d’identité empêche le critique de récompenser les empreintes du générateur. La tête du critique compte environ 3 millions de paramètres, en plus d’un encodeur WavLM-large figé. Une pénalité de durée s’applique également dès que la durée dépasse 1,35 fois celle de la référence. Cela empêche la politique de tromper le critique en utilisant une parole plus lente.
Cette nouvelle étape pose plusieurs questions qui restent ouvertes.
Pour aller plus loin :
- Découvrez LEANN : un index vectoriel open source qui réduit la taille d’un index RAG composé de 60 millions de blocs, passant de 201 Go à 6 Go
- Baidu met en open source « Unlimited OCR 2 » pour l’analyse de documents de cent pages
Article original : MarkTechPost : MarkTechPost