Un développement récent dans le monde de l’IA attire l’attention.
Découvrez LEANN : un index vectoriel open source qui réduit la taille d’un index RAG composé de 60 millions de blocs, passant de 201 Go à 6 Go
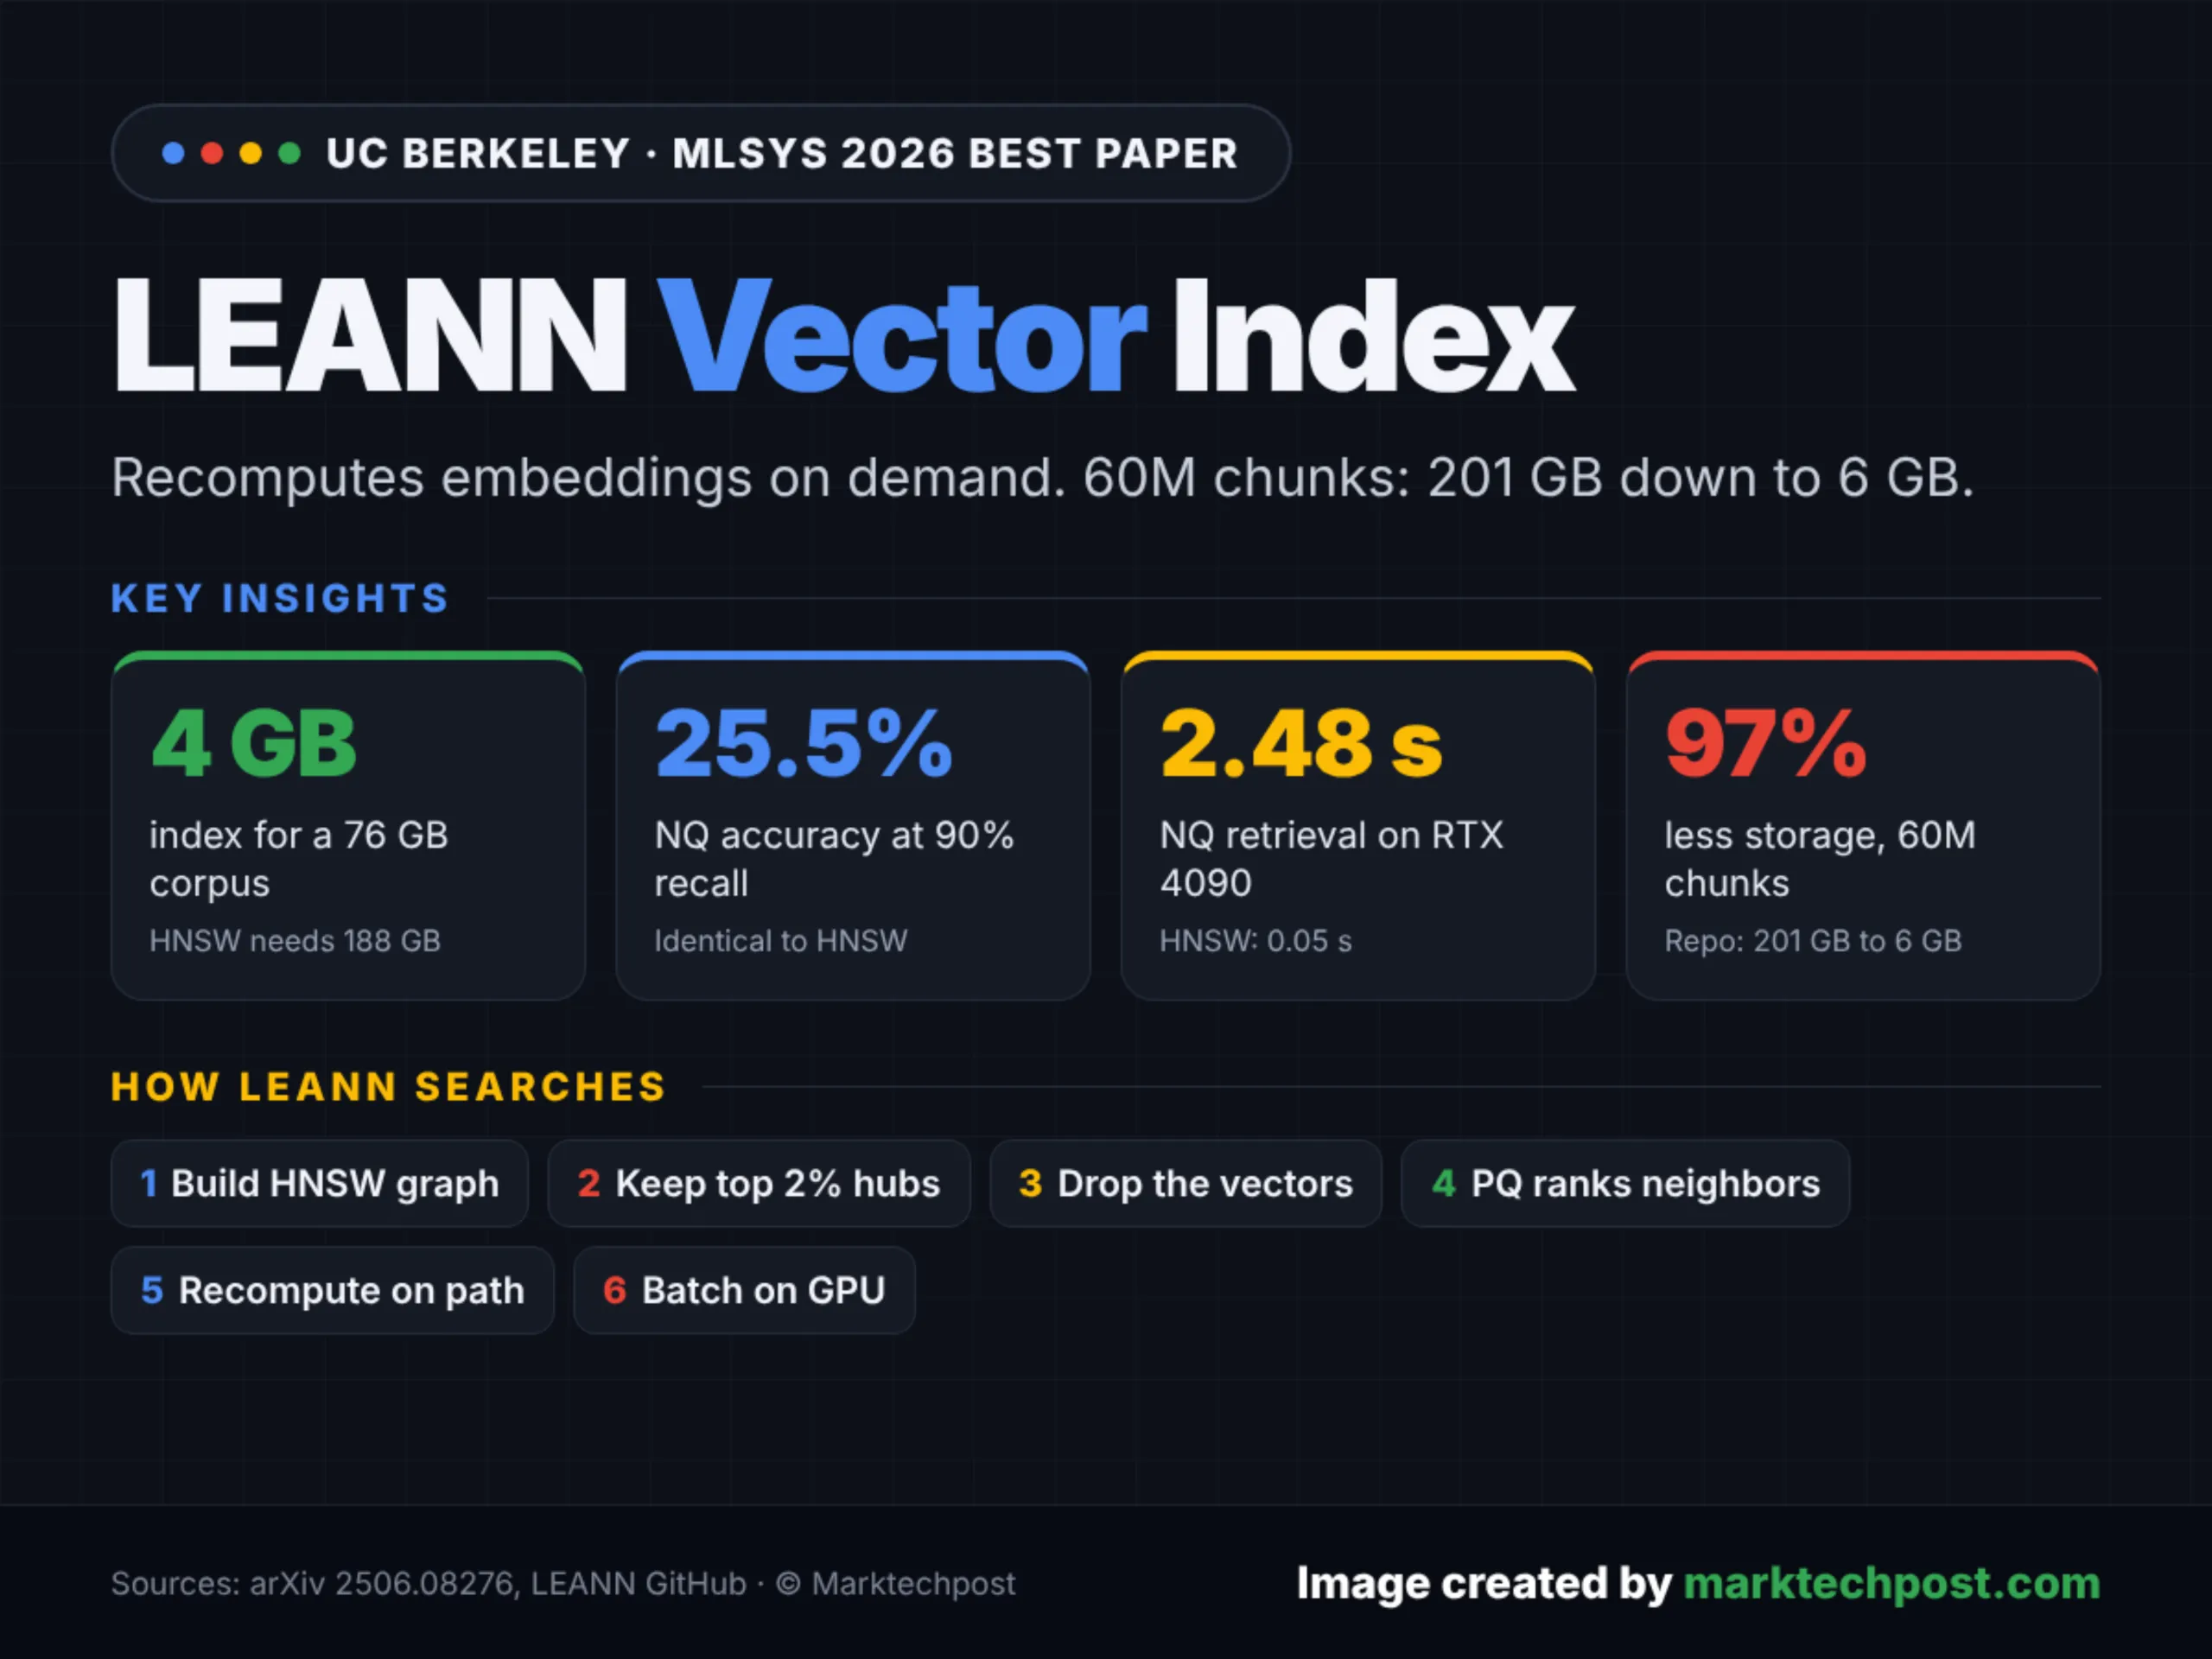
Le Sky Computing Lab de l’Université de Californie à Berkeley a développé LEANN, un index vectoriel open source qui ne stocke pratiquement aucune représentation vectorielle. L’index vectoriel LEANN recalcule les représentations vectorielles au moment de la requête, au lieu de les enregistrer sur le disque. Les tests de performance présentés dans le dépôt montrent qu’un index Wikipédia composé de 60 millions de blocs passe de 201 Go à 6 Go. L’article de exploration a remporté le prix du meilleur article de exploration lors de la conférence MLSys 2026. Il autorise de cette manière d’appliquer la recherche sémantique et la technologie RAG aux données personnelles, directement sur un ordinateur portable.
LEANN est un index « approximate nearest neighbor » (ANN) à faible encombrement, développé à partir de FAISS. Il vise à résoudre un problème précis : les index vectoriels sont souvent plus volumineux que les informations qu’ils indexent. L’article de recherche fait apparaître qu’un corpus de 76 Go nécessite 173 Go d’embeddings, auxquels s’ajoute un graphe HNSW de 15 Go. Cela représente plus du double du volume des données brutes.
L’article de recherche fait apparaître qu’un corpus de 76 Go nécessite 173 Go d’embeddings, auxquels s’ajoute un graphe HNSW de 15 Go.
À noter également, lEANN conserve un graphe allégé, supprime les vecteurs complets et les reconstruit à la demande. Le code est sous licence MIT et s’installe via `pip install leann`.
Les index de graphes tels que HNSW ne consultent qu’un petit ensemble de nœuds par requête. LEANN tire parti de cette caractéristique. Il stocke le graphe ainsi qu’une table compacte de quantification par produit (PQ). Au moment de la requête, il réintègre uniquement les nœuds situés sur le chemin de travaux de recherche.
Dans les opérations d’ablation, la recherche à deux niveaux permet un gain de vitesse moyen de 1,4 fois. L’ajout du traitement par lots porte ce gain à 1,8 fois. Le recalcul des embeddings représente toujours environ 76 % de la latence des requêtes.
L’équipe de recherche a testé NQ, TriviaQA, GPQA et HotpotQA sur un ensemble de données RPJ-Wiki comprenant 60 millions de passages. La latence est mesurée à un taux de rappel de 90 % @3. Tous les chiffres ci-dessous sont fournis par les auteurs eux-mêmes dans leur article de exploration.
Il faudra attendre les retours concrets pour juger de l’impact réel.
Dans le même ordre d’idées :
Source originale : MarkTechPost : MarkTechPost