
Les dernières heures ont apporté leur lot d’informations dans l’écosystème IA.
Guide du développeur sur Laya : décisions « zero-shot » et calibrage
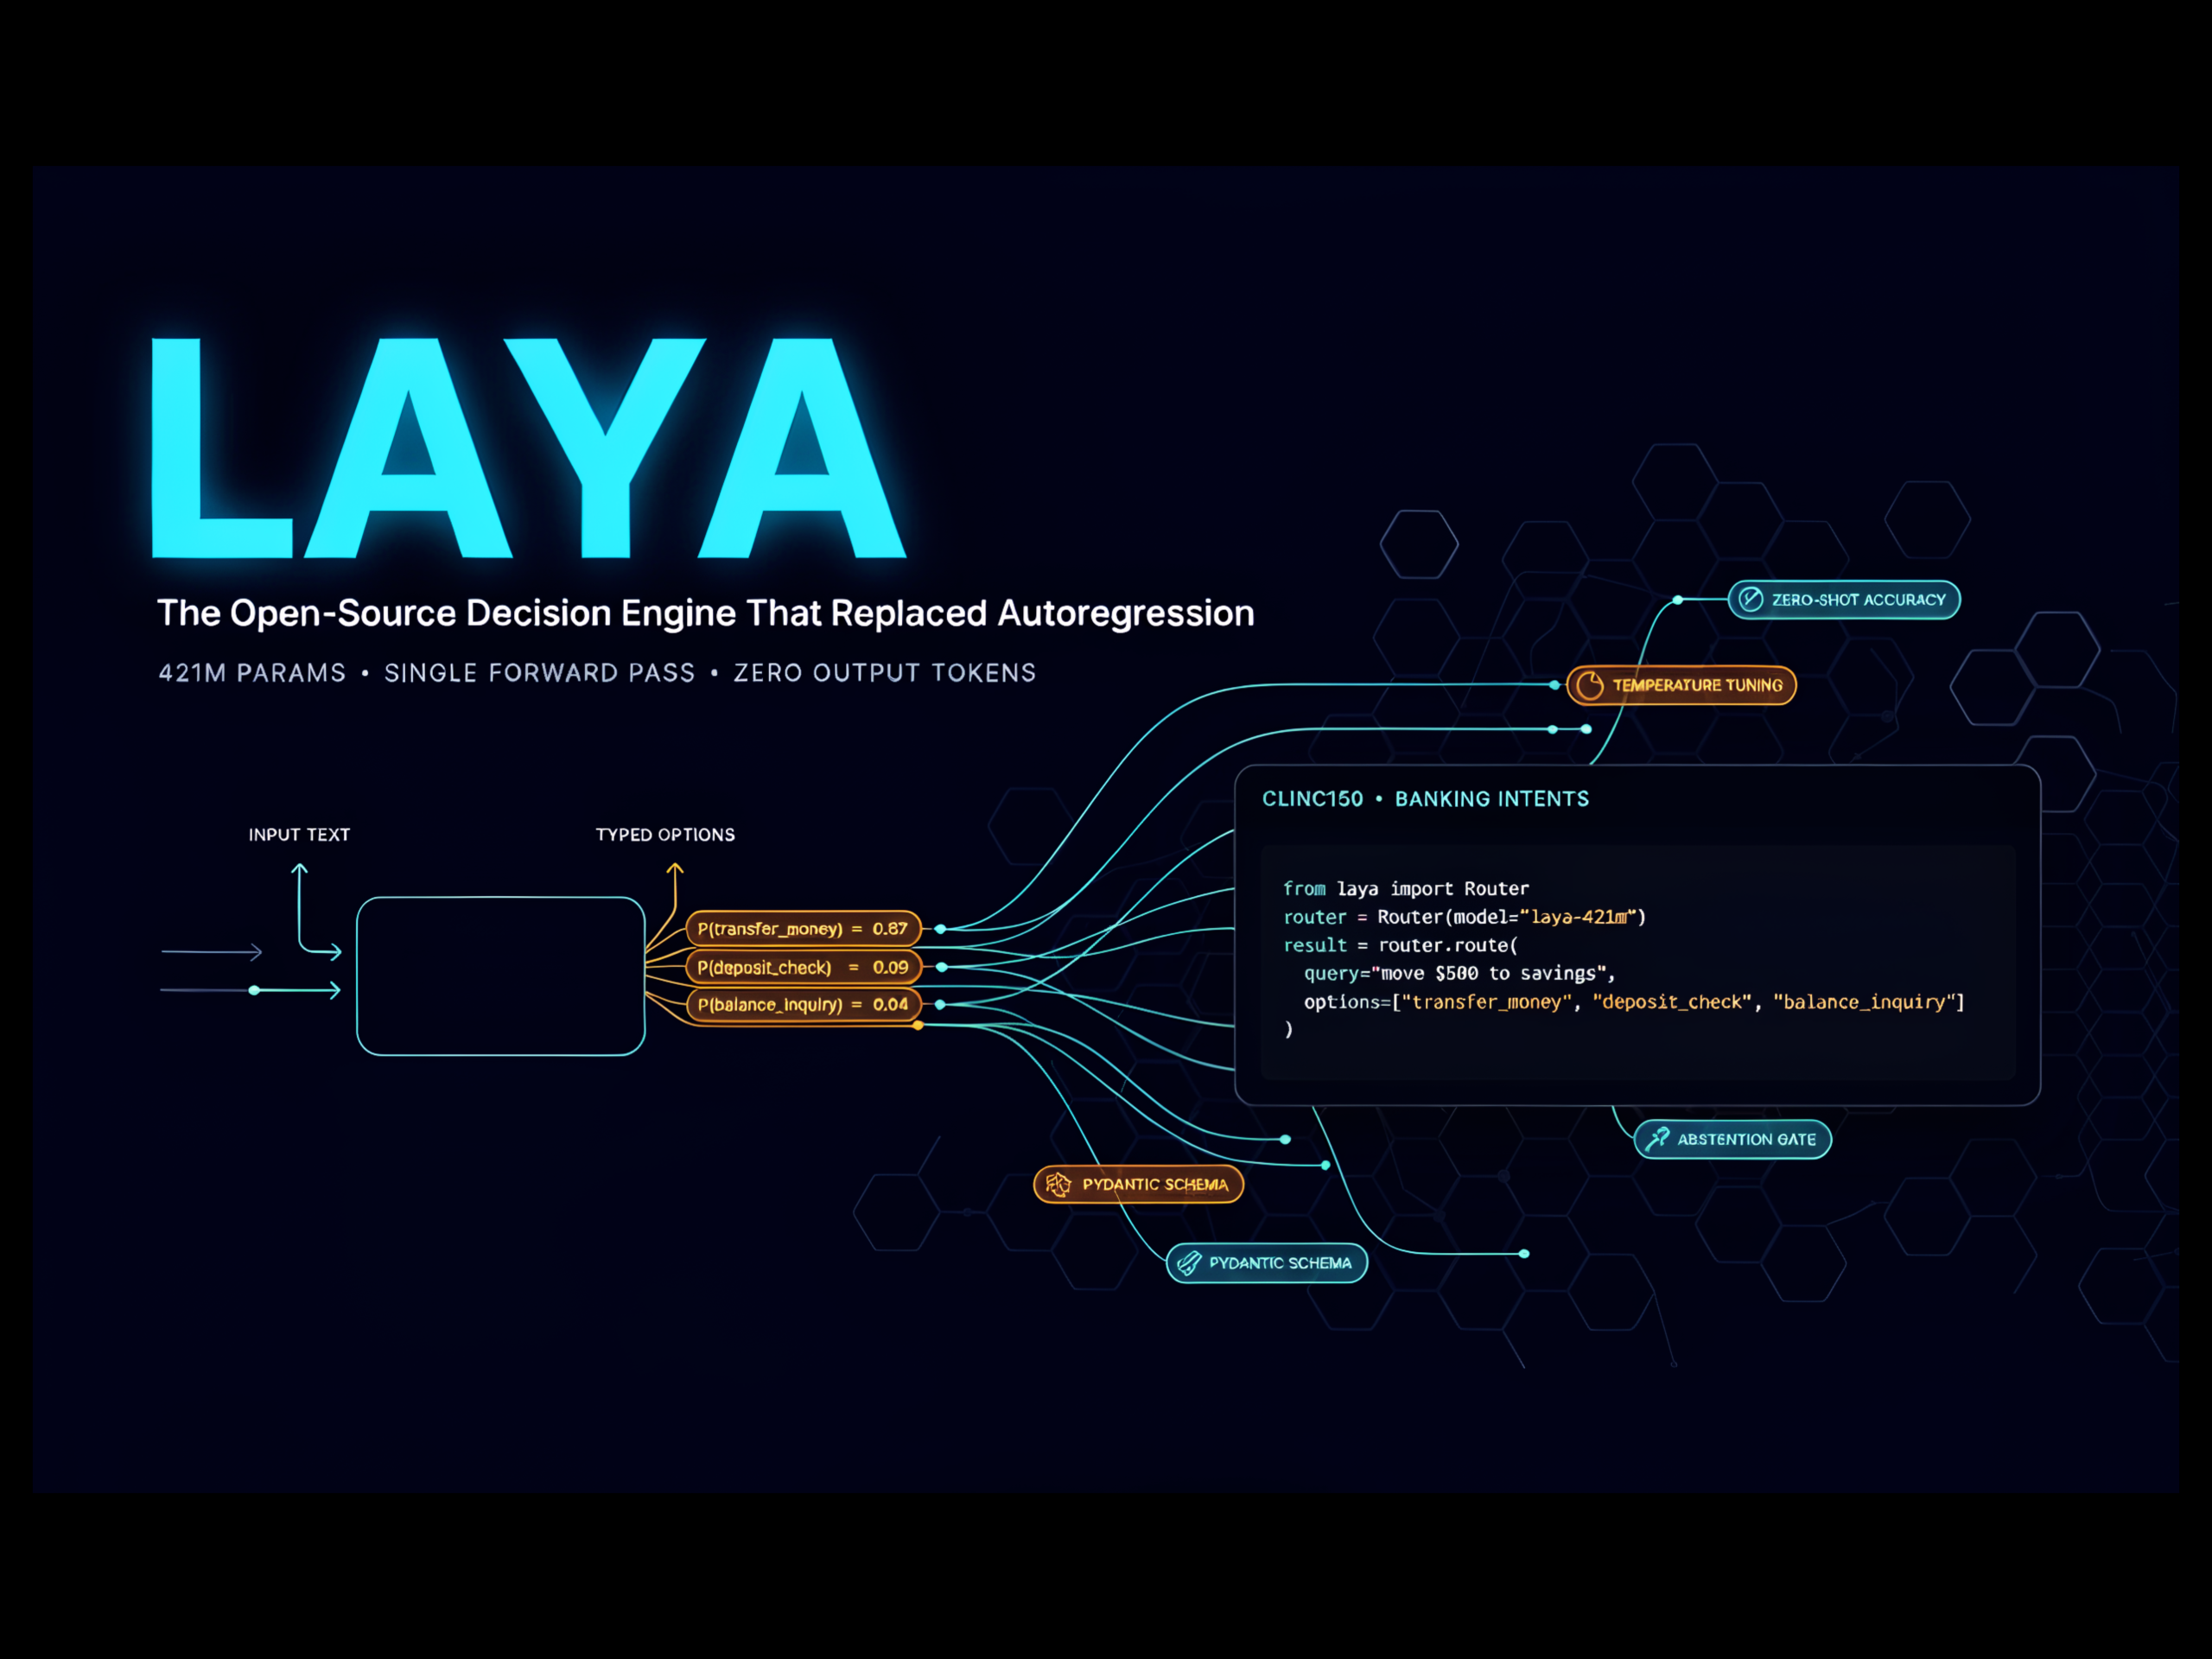
Dans ce tutoriel, nous allons utiliser Laya, le moteur de décision open source développé par Convai Innovations, qui est devenu l’un des dépôts de code liés à l’apprentissage automatique les plus « starés » en septembre 2026. Laya est un système « Mécanisme 1 » non autorégressif : au lieu de générer du texte, un encodeur de 421 millions de paramètres lit un extrait de texte et un ensemble de questions saisies, un choix entre des étiquettes, une note sur une échelle ou une réponse par oui ou par non, puis renvoie une probabilité pour chaque option en un seul passage avant, sans aucun token de sortie. Il se distingue par sa rapidité et ses probabilités calibrées, et constitue la réponse ouverte à Jev de TypeSafe. Plutôt que de reprendre les exemples du fichier README, nous avons mis ces promesses en pratique sur de véritables informations annotées dont les réponses sont connues, issues du domaine bancaire de l’ensemble de éléments d’intentions CLINC150, et nous avons mesuré les résultats réels obtenus par un routeur en production : précision « zero-shot » par rapport à un classificateur entraîné, l’importance de la formulation et de l’ordre des options, la fiabilité des probabilités fournies, ce que l’ajustement d’un paramètre de « température » sur les données de validation corrige et ce qu’il endommage discrètement, un filtre d’abstention adapté à un budget d’erreur, le trafic hors périmètre, une question oui/non que le paramètre de « température » ne peut pas résoudre, et les sorties typées issues d’un schéma pydantic.
En complément, nous installons le paquet publié, laya 0.3.27, et chargeons le checkpoint anglais. Deux choix permettent ici de garantir la reproductibilité de l’exécution. Par défaut, laya.load suit la branche principale de Hugging Face ; nous fixons donc la révision validée par les auteurs de la bibliothèque, exposée sous le nom de laya.PINNED_REVISIONS. De plus, sur CUDA, Laya effectue un autocasting vers la demi-précision ; nous désactivons donc cette fonctionnalité afin que tous les périphériques restent en fp32 et qu’une exécution sur GPU reproduise les résultats obtenus sur CPU présentés ici. L’impression des températures d’expédition du point de contrôle révèle le premier résultat avant même toute prédiction : la valeur pour les questions à choix multiples comportant onze options ou plus est de 0,10, ce qui se situe en dehors de la plage valide ; le chargeur la limite donc à 0,5 et affiche un avertissement. Une température inférieure à un accentue les probabilités ; ainsi, chaque réponse à une question comportant ce nombre d’options paraîtra deux fois plus certaine que ne le laisse supposer le modèle d’IA brut.
Le bloc d’utilisation n’affiche aucun jeton de sortie, car Laya évalue les options qui lui sont fournies et ne génère jamais de texte.
Point notable, un seul appel suffit pour prédire les réponses à trois questions saisies concernant un ticket d’assistance, en une seule étape : le service concerné, le niveau d’urgence sous forme de note comprise entre 0 et 2, et le risque de désabonnement sous forme de réponse par oui ou par non. Le résultat comporte une probabilité pour chaque option et deux champs de confiance qu’il est facile de confondre. « answer_confidence » correspond à la probabilité de la réponse indiquée ; c’est cette valeur qui est utilisée par l’étalonnage, le filtre d’abstention et tous les indicateurs abordés plus loin dans ce tutoriel. « confidence » correspond à un moins l’entropie normalisée, dont l’échelle dépend du nombre d’options proposées pour une question. Le bloc d’utilisation n’affiche aucun jeton de sortie, car Laya évalue les options qui lui sont fournies et ne génère jamais de texte.
Par ailleurs, avant de développer sur Laya, nous évaluons le coût d’un transfert vers l’avant pour un seul message. Chaque question constitue une ligne distincte, associée au message ; par conséquent, seize questions « oui/non » prennent environ huit fois plus de temps qu’une seule. Toutes les options d’une question à choix multiples partagent une même ligne et son budget alloué, de sorte qu’une question à quarante options coûte à peine deux fois plus cher qu’une question à trois options et un quart de ce que coûtent seize questions oui/non sur notre processeur. Il en résulte une règle de conception qui détermine tout ce qui suit : posez une seule question à choix multiples plutôt que plusieurs questions fermées (oui/non).
Pour les données réelles étiquetées, nous utilisons CLINC150, un ensemble de données de référence public dédié à la classification des intentions, comprenant 150 intentions réparties sur dix champs d’application, ainsi qu’un ensemble de requêtes hors champ, récupérées directement depuis Hugging Face Hub sous forme de fichier Parquet. Nous prenons son domaine bancaire, qui comprend quinze intentions avec chacune 100 requêtes d’entraînement, 20 de validation et 30 de test, et demandons à Laya d’acheminer les 450 requêtes de test en mode « zero-shot », en lui fournissant le nom de chaque intention et une description d’une ligne, du type de celle qu’un développeur rédigerait. Le dispositif atteint une précision de 0,804 sans aucun exemple étiqueté. À titre de comparaison, un classificateur utilisant le TF-IDF et la régression logistique atteint un score de 0,651 avec trois requêtes étiquetées par intention, de 0,848 avec dix et de 0,904 avec trente.
Ensuite, nous modifions uniquement la formulation des options. En proposant à Laya les quinze noms d’intentions bruts, sans nos descriptions, la précision passe de 0,804 à 0,878 et le temps de traitement est divisé par deux, car les options occupent moins de la moitié des tokens. Les descriptions ont brouillé les intentions que les noms permettent de distinguer : « account_blocked » a été redirigé vers « freeze_account » à dix reprises, et les questions sur les taux d’intérêt vers « balance ». Inverser l’ordre des noms nus modifie 4,2 % des réponses individuelles, même si la précision globale ne varie pratiquement pas, ce qui indique une position a priori ; l’ordre des options que vous déployez doit donc être celui que vous avez testé. Seules des données étiquetées pourraient nous fournir ces informations ; à partir de là, nous nous basons uniquement sur les noms bruts.
De plus, nous nous demandons ensuite dans quelle mesure ces probabilités sont fiables. Une question à quinze options relève de la catégorie de température « 11+ » du point de contrôle, celle dont la valeur est plafonnée à 0,5. Le tableau de fiabilité portant sur les 450 requêtes de test montre le résultat suivant : 92 % des réponses affichent un niveau de confiance d’au moins 0,9, mais 91,1 % d’entre elles sont correctes, et le niveau de confiance moyen de 0,974 se situe bien au-dessus de la précision de 0,878, ce qui correspond à une erreur d’étalonnage attendue de 0,102. L’objectif d’apprentissage de Laya utilise des règles de notation appropriées, ce que la fiche du système désigne par « calibré ». Pour autant, le calibrage est une propriété d’une question par rapport à une distribution, et vous devez le mesurer par rapport à vos propres étiquettes.
Point notable, le module d’étalonnage de Laya transforme les exemples étiquetés en enregistrements de logits bruts et de cibles, puis y ajuste une température. Nous créons 300 enregistrements à partir de la partie de validation et appelons la fonction `agent.fit_temperatures`, qui ajuste une température de choix de 1,258 et l’installe, puis affiche le tableau complet des températures à côté de celui fourni. L’ajustement a remplacé l’intégralité de la carte : toutes les entrées « nombre par option » ont disparu, car un compartiment a besoin de 2 000 enregistrements pour conserver sa propre température, et les températures « score » et « oui/non » ont été réinitialisées à 1,0, car il n’existait aucun enregistrement de ces types. Un seul ajustement sur une question à choix a modifié, sans avertissement, la manière dont toutes les questions « oui/non » de l’agent sont calibrées. Nous rétablissons donc les valeurs d’origine et n’installons que le « bucket » que nous avons mesuré. Sur l’ensemble de test, l’erreur d’étalonnage passe de 0,102 à 0,059 sans que la précision ne soit affectée, puisque la température ne change jamais, quelle que soit l’option choisie, et la fonction `save_calibration` enregistre le résultat dans un fichier JSON que `laya.load` peut lire par la suite.
Les points essentiels à retenir :
- Seules des données étiquetées pourraient nous fournir ces informations ; à partir de là, nous nous basons uniquement sur les noms bruts.
- Nous nous demandons ensuite dans quelle mesure ces probabilités sont fiables.
- Le module d’étalonnage de Laya transforme les exemples étiquetés en enregistrements de logits bruts et de cibles, puis y ajuste une température.
Reste à voir comment l’industrie va réagir à cette annonce.
À lire également :
- Reflection lance « Beam », un modèle d’IA à poids ouvert destiné à rivaliser avec les modèles chinois tout en réduisant les coûts de calcul | TechCrunch
- L’histoire de Qwen : les modèles d’IA d’Alibaba, de 7 milliards à 2,4 billions
D’après MarkTechPost : MarkTechPost