Cette semaine apporte son nouveau chapitre dans le grand livre de l’IA.
Mistral AI lance Voxtral 3 : reconnaissance vocale, synthèse vocale et SDK pour agent vocal
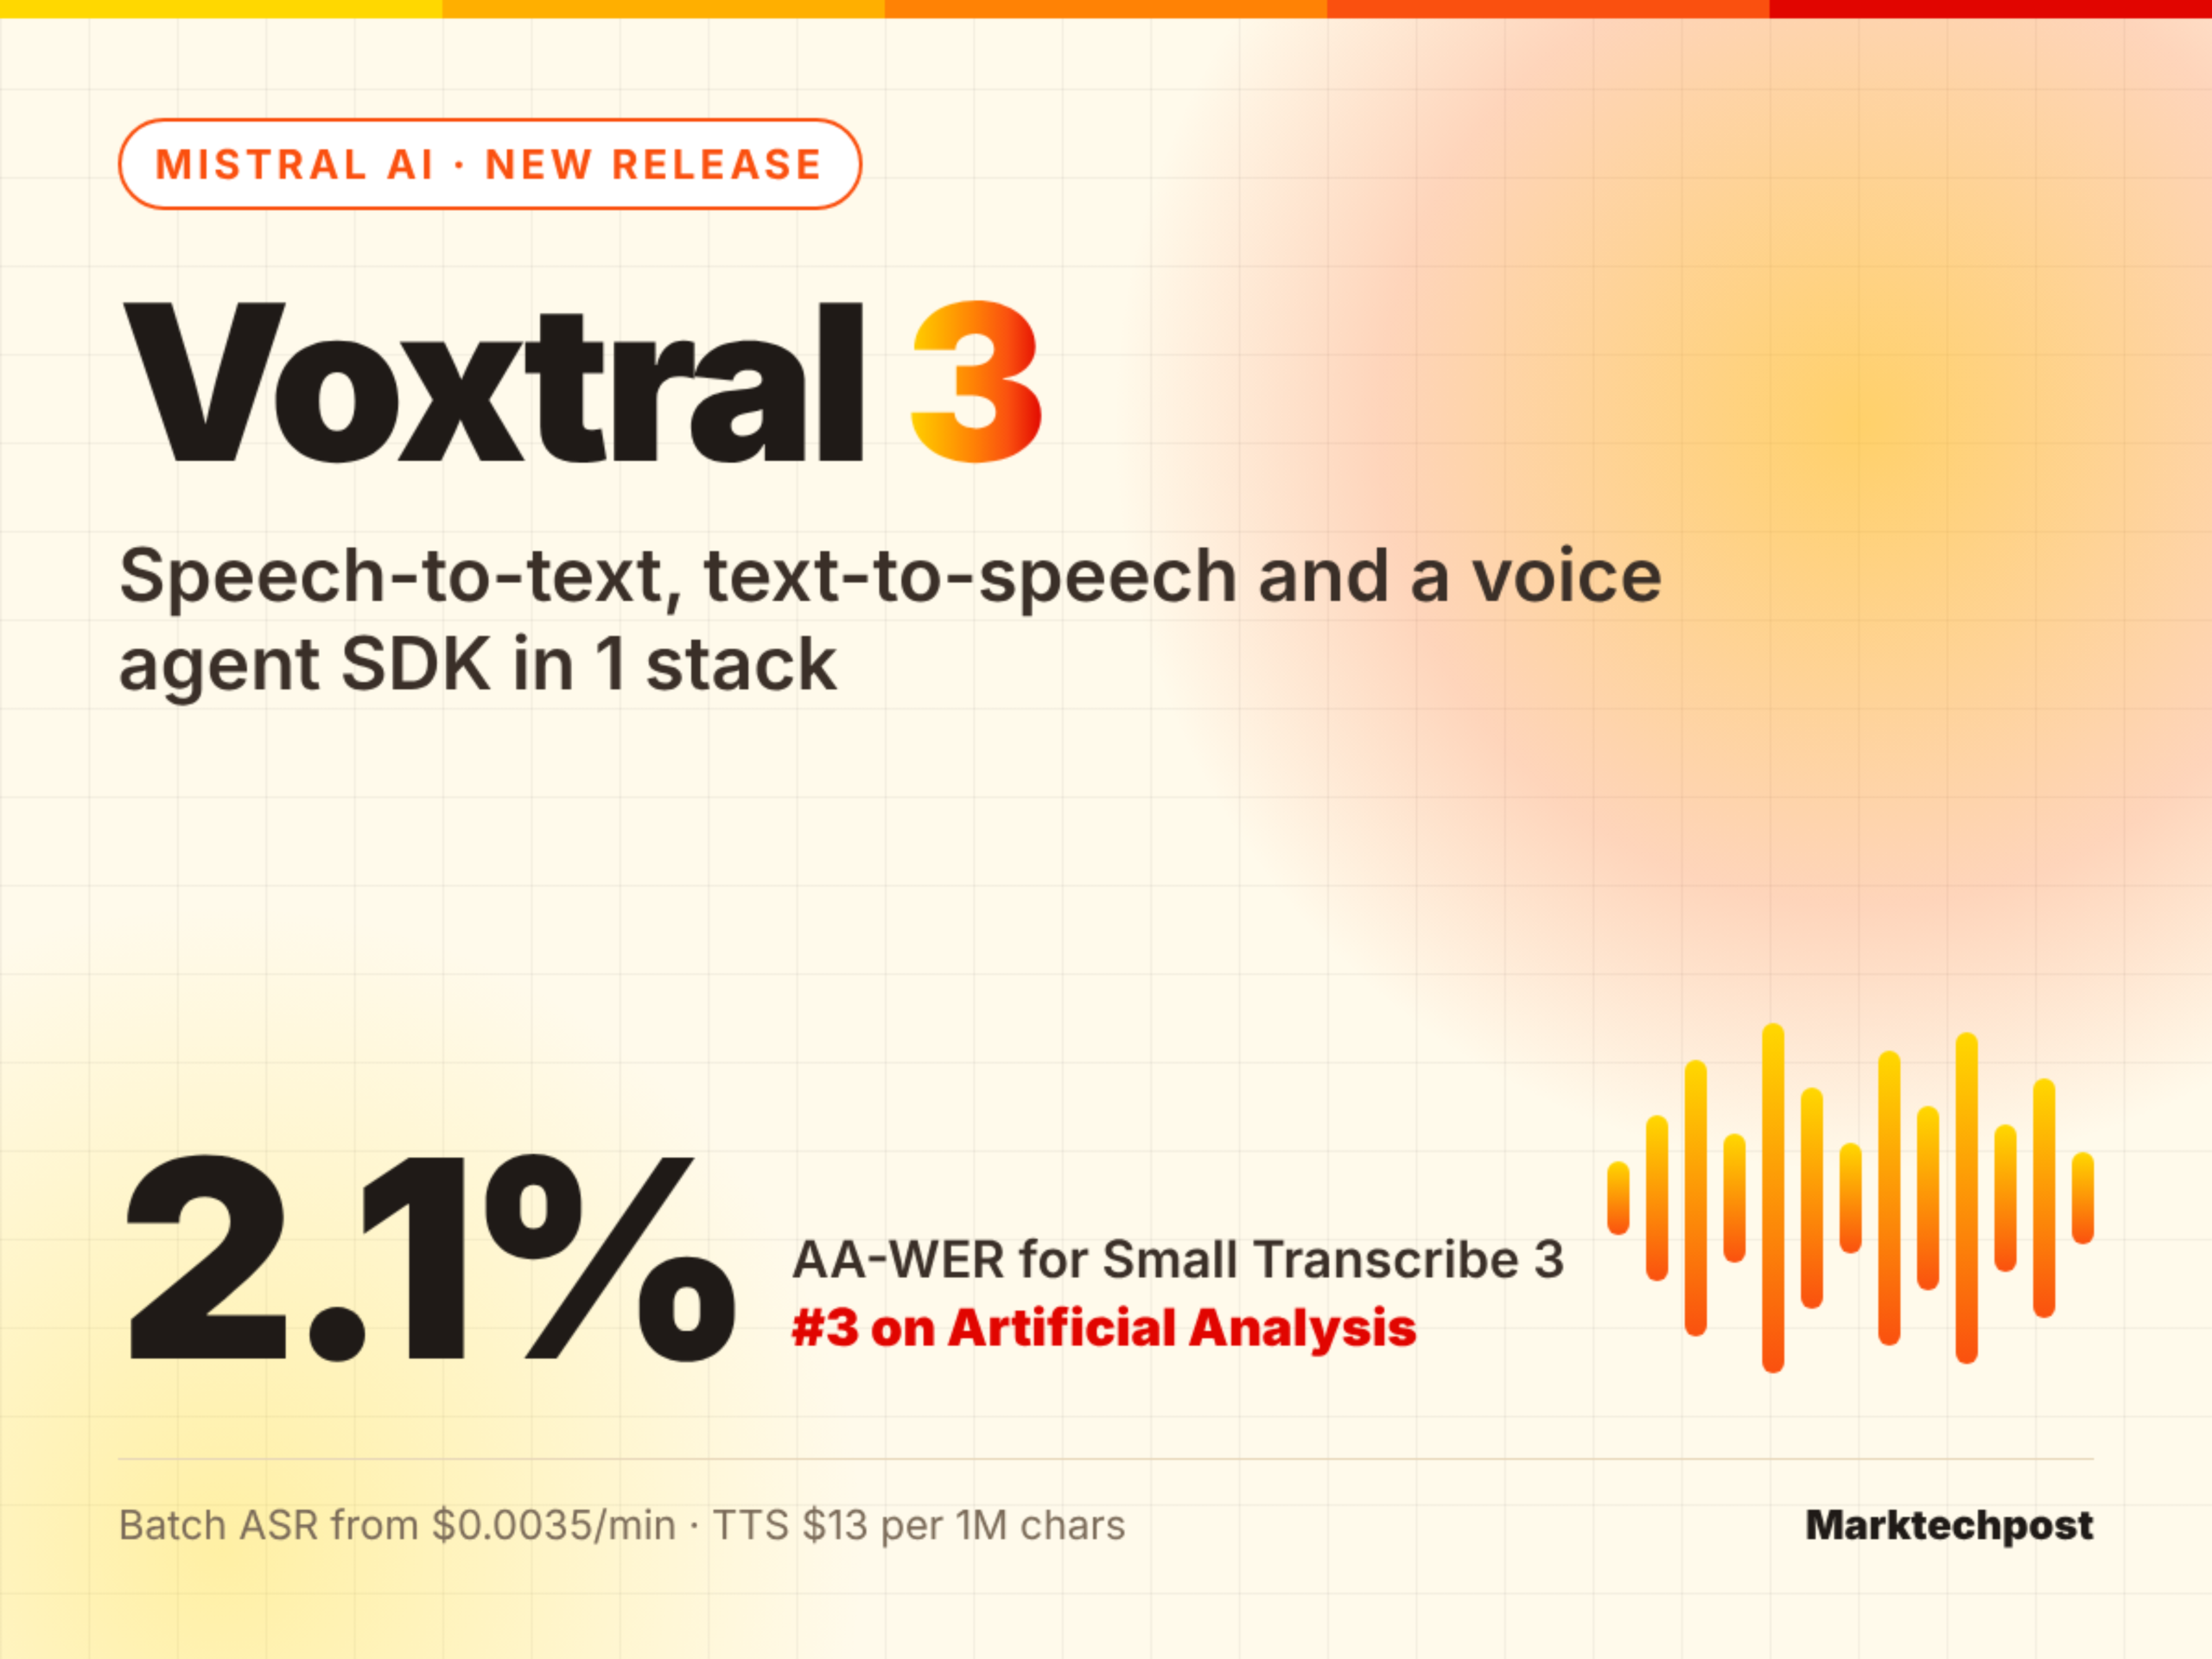
Mistral AI vient de lancer Voxtral 3. Mistral Voxtral 3 est une famille de modèles vocaux associée à un SDK d’agent vocal. Elle comprend 3 modèles de transcription, 1 système de synthèse vocale et un SDK basé sur LiveKit. Une solution unique pour l’écoute, le raisonnement, l’appel d’outils et la synthèse vocale. Les 4 modèles sont disponibles en préversion publique sur l’API Mistral.
Tous les modèles de transcription prennent en charge la diarisation et le biais contextuel. Le biais contextuel utilise des termes clés ou du texte libre pour améliorer le rappel. La transcription par lots couvre 50 langues, dont les 24 langues officielles de l’UE.
Le SDK repose sur LiveKit et exécute trois étapes au sein d’un même pipeline de streaming. Realtime Transcribe 3 écoute et détecte le moment où l’appelant cesse de parler. Un modèle de langage général (LLM), tel que Mistral Small 4, effectue des raisonnements et fait appel à des outils. Voxtral Speech 3 répond en s’adaptant au ton de la conversation jusqu’à présent.
Par ailleurs, chaque tour s’effectue en moins d’une seconde. L’agent cesse de parler dès que l’appelant prend la parole. Il gère les appels téléphoniques via SIP et les sessions via navigateur ou application via WebRTC. Chaque étape correspondant à un modèle distinct, les équipes peuvent changer de LLM, de voix ou de langue.
En ce qui concerne l’analyse artificielle, Small affiche un taux d’erreur AA-WER de 2,1 % et Mini de 2,2 %. Seuls Fun-Realtime-ASR-preview (1,7 %) et MAI-Transcribe-2 (2,0 %) obtiennent de meilleurs résultats. La différence réside dans la vitesse : le facteur de vitesse de Small est de 65,8x, contre 307,5x pour MAI-Transcribe-2.
Sur FLEURS 35, le système en temps réel privilégie la précision au détriment de la latence. Il affiche un taux d’erreur de mots (WER) de 5,7 % à 2 400 ms et de 6,4 % à 480 ms. À 240 ms, le WER grimpe à 7,4 %. Gemini 3.5 Realtime Transcribe affiche un taux de 4,2 % et MAI-Transcribe-2 Streaming, 5,8 %. GPT Live Transcribe (8,4 %) et Scribe v2 Realtime (8,7 %) sont à la traîne par rapport à tous les paramètres de Voxtral.
Sur ce point, voxtral Speech 3 coûte 13 dollars par million de caractères. Selon Mistral, ce prix est inférieur à celui d’OpenAI TTS-1, de Deepgram, d’ElevenLabs Flash et de Gemini Flash. Les commandes explicites couvrent les émotions, le rythme et l’accentuation. La page du modèle indique un délai de ~90 ms avant la première sortie audio et 34 balises d’émotions. Pro Voice adapte le style d’un locuteur à partir de 30 minutes d’enregistrement audio. Artificial Analysis le classe parmi les 12 meilleurs dans les deux champs d’application de la synthèse vocale.
Les points essentiels à retenir :
- Seuls Fun-Realtime-ASR-preview (1,7 %) et MAI-Transcribe-2 (2,0 %) obtiennent de meilleurs résultats.
- Sur FLEURS 35, le système en temps réel privilégie la précision au détriment de la latence.
- La page du modèle indique un délai de ~90 ms avant la première sortie audio et 34 balises d’émotions.
Pour les professionnels du domaine, cette annonce mérite d’être surveillée.
Dans le même ordre d’idées :
Article original publié par MarkTechPost : MarkTechPost