Un nouveau jalon vient d’être franchi dans l’univers de l’intelligence artificielle.
Baidu met en open source « Unlimited OCR 2 » pour l’analyse de documents de cent pages
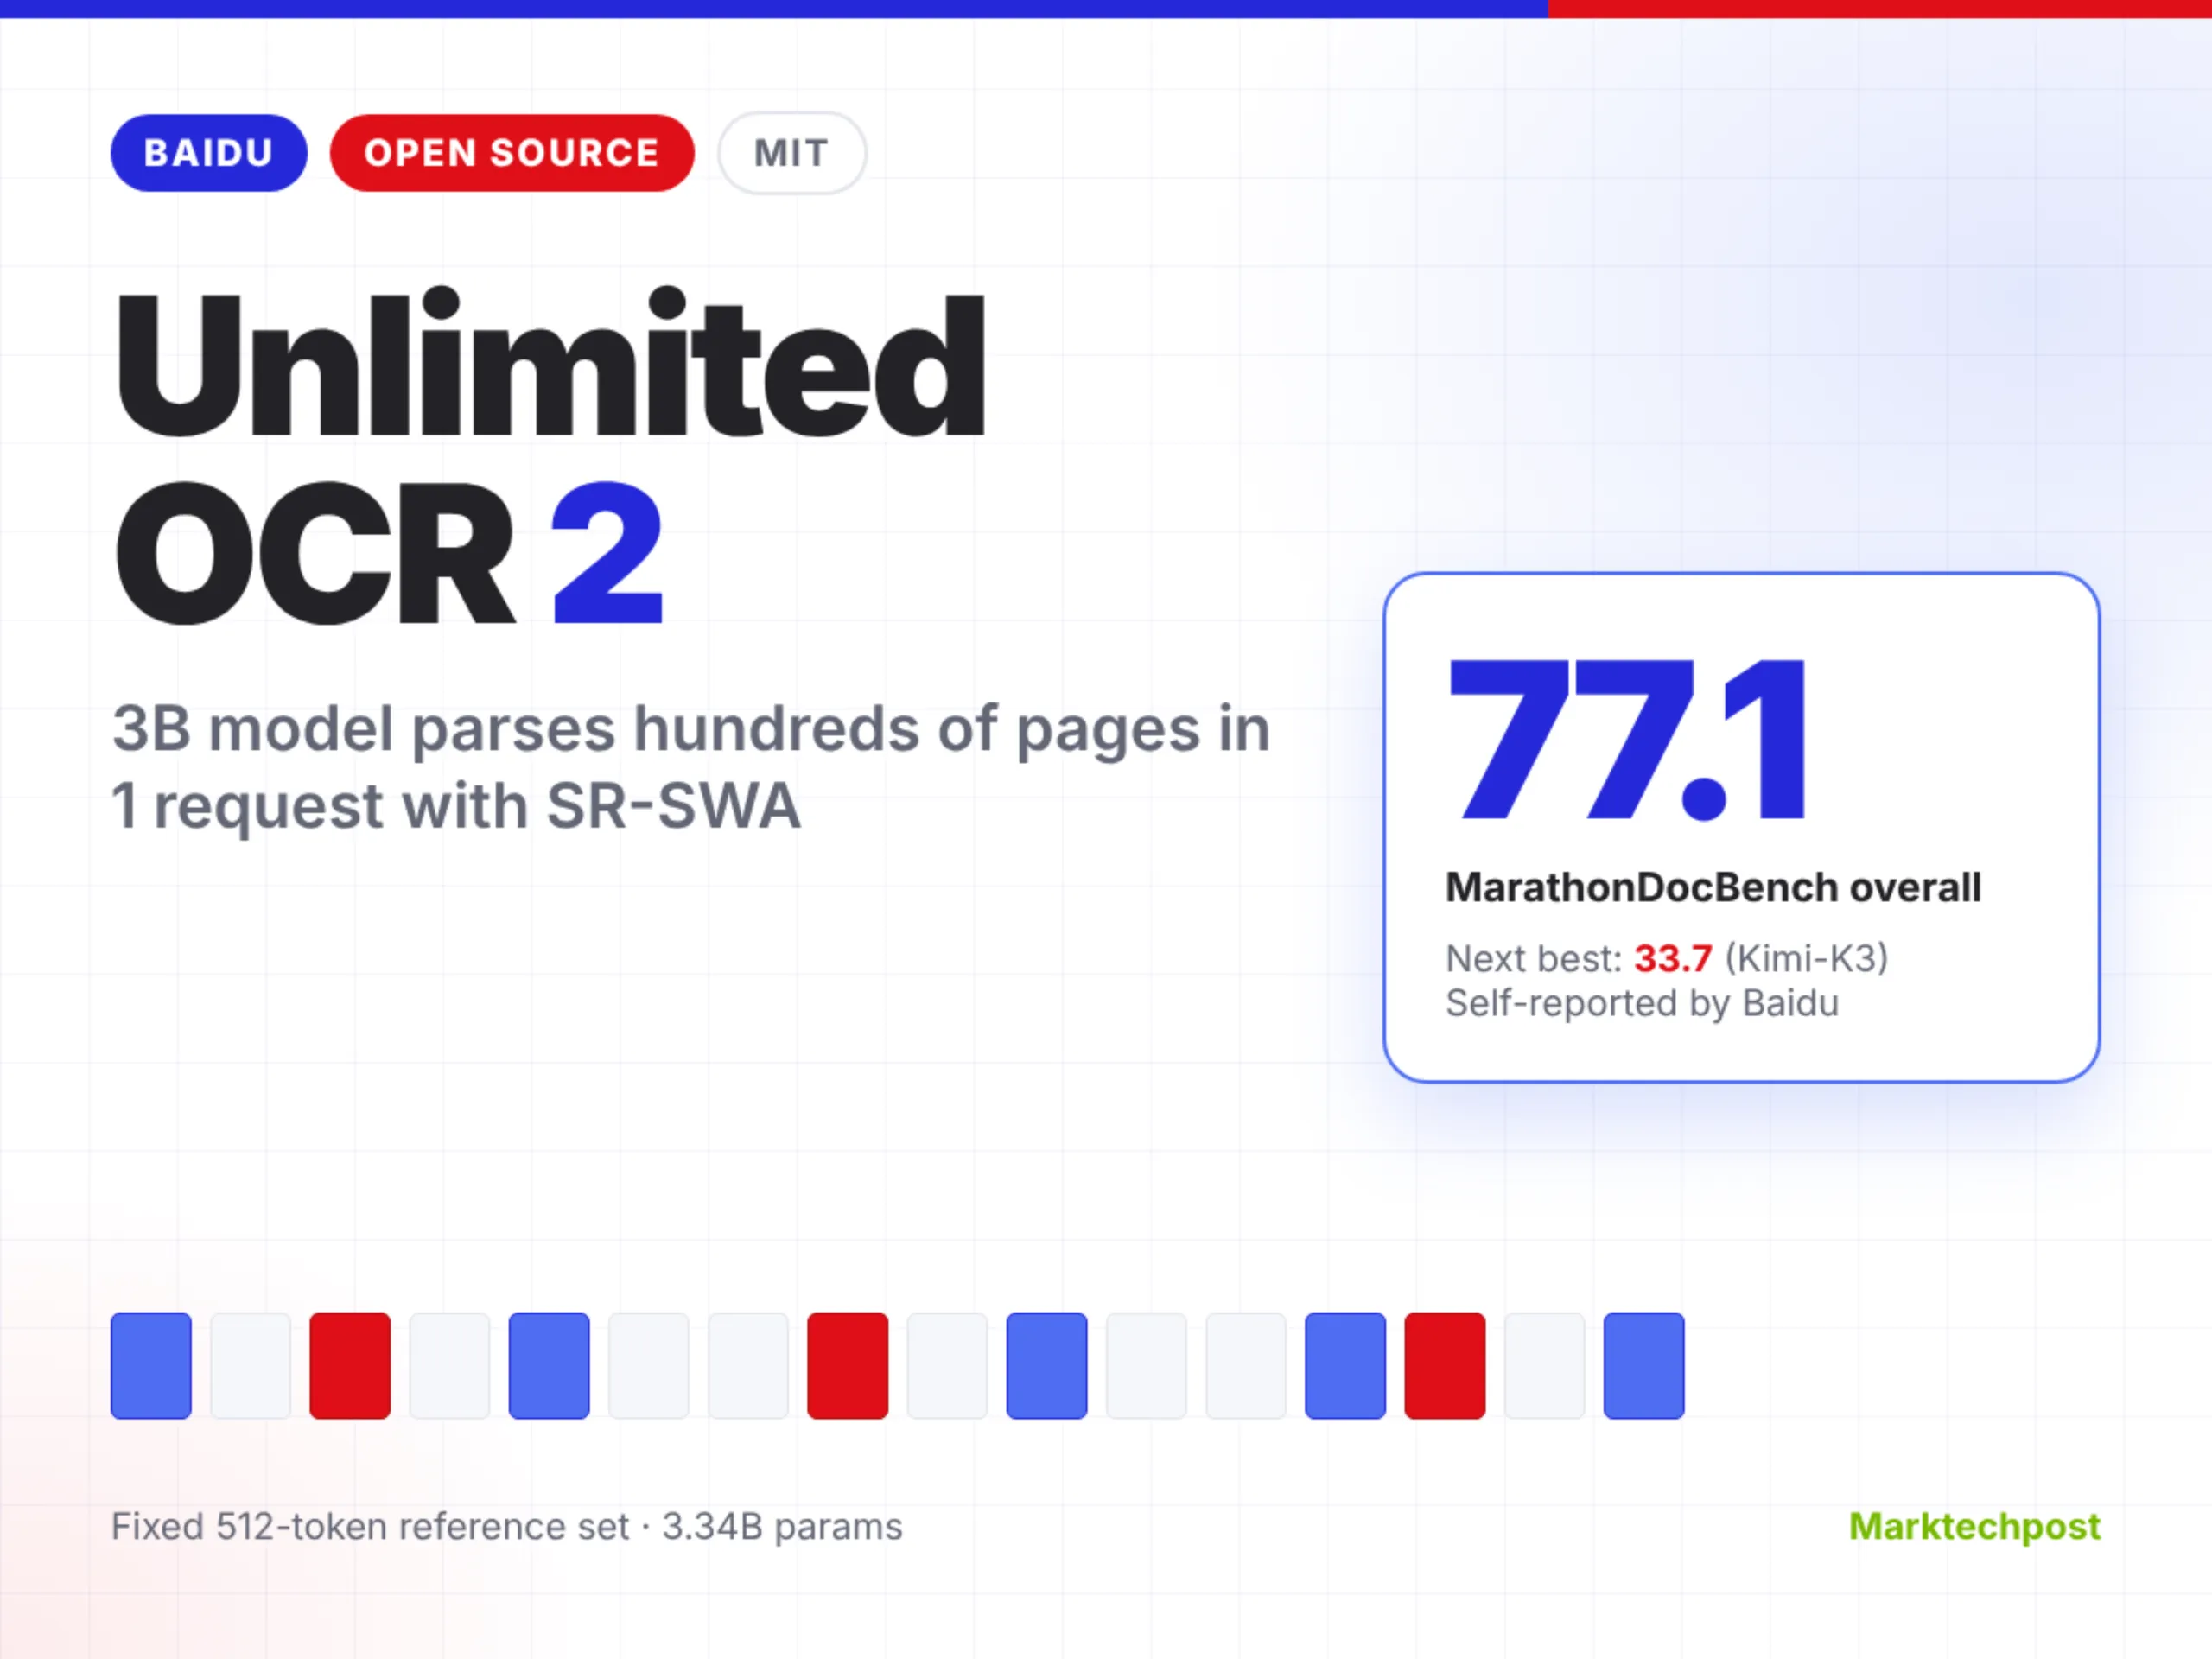
Baidu a lancé « Unlimited OCR 2 », un modèle OCR open source conçu pour les documents grandement longs. Ce modèle de 3 milliards de paramètres analyse des livres, des dossiers et des rapports de plusieurs centaines de pages en une seule requête. Sa principale innovation réside dans le SR-SWA, un schéma d’attention clairsemée qui maintient le coût de décodage par étape pratiquement constant. Les poids sont distribués sous licence MIT, et le code est disponible sur GitHub.
Unlimited OCR 2 est un modèle d’IA de vision-langage 3B développé par Baidu qui transforme des images de pages ordonnées en texte structuré. Les retombées comprennent du texte, des tableaux, des formules, des figures, des titres et l’ordre de lecture. Il succède à Unlimited-OCR, lancé en juin 2026 afin de faire progresser encore davantage DeepSeek-OCR.
La configuration conserve une architecture de type DeepSeek-OCR. Un encodeur SAM ViT-B associé à CLIP-L alimente un décodeur « mixture-of-experts » à 12 couches. Chaque token est acheminé vers 6 experts parmi 64, auxquels s’ajoutent 2 experts partagés. L’article sur DeepSeek-OCR décrit ce décodeur sous le nom de DeepSeek3B-MoE-A570M. Baidu ne précise pas le nombre d’experts actifs pour la version 2. En mode multipages, chaque page correspond à 273 tokens d’image.
Le coût total de l’attention augmente de manière quadratique avec la longueur de la séquence. Lors du décodage, chaque nouveau token parcourt un cache K-V de plus en plus long. Avec 273 tokens d’image par page, 100 pages ajoutent 27 300 tokens d’entrée avant toute sortie.
SR-SWA signifie « Sparse Reference Sliding Window Attention ». Ce modèle condense l’attention texte-image en un ensemble fixe de références de travail. La fiche technique du système de Baidu donne 512 tokens comme taille d’exemple. La configuration associe une fenêtre locale de 128 tokens à une sélection des 16 meilleurs éléments parmi des blocs de 32 tokens. Cela correspond à 16 blocs de 32 tokens, ce qui correspond au budget de 512 tokens.
Parallèlement, cela permet de maintenir la latence et la consommation de mémoire par étape à un niveau quasi constant à mesure que la taille des documents augmente. On appelle cela l’analyse syntaxique à « horizon illimité » dans une fenêtre de contexte finie. L’encodage des images et la durée d’exécution totale continuent toutefois d’augmenter avec le nombre de pages.
L’équipe de Baidu a effectué des tests sur MPDocBench, avec des dizaines de pages par document, et sur MarathonDocBench, avec des centaines de pages. MPDocBench-Parse est un benchmark public comprenant 433 documents et 3 246 pages. Nous n’avons pas trouvé de version publique de MarathonDocBench.
Les informations principales :
- La configuration associe une fenêtre locale de 128 tokens à une sélection des 16 meilleurs éléments parmi des blocs de 32 tokens.
- On appelle cela l’analyse syntaxique à « horizon illimité » dans une fenêtre de contexte finie.
- MPDocBench-Parse est un benchmark public comprenant 433 documents et 3 246 pages.
Cette nouvelle étape pose plusieurs questions qui restent ouvertes.
Pour aller plus loin :
- Nanbeige lance Nanbeige4.3-33B, un modèle de codage agentique ouvert de type 33B
- L’économie numérique de l’Asie du Sud-Est devrait atteindre 368 milliards de dollars
Information publiée en premier lieu par MarkTechPost : MarkTechPost