Un acteur majeur du secteur vient de faire parler de lui.
Liquid AI lance LFM3 : 6 modèles multimodaux de classe 2B à poids variable
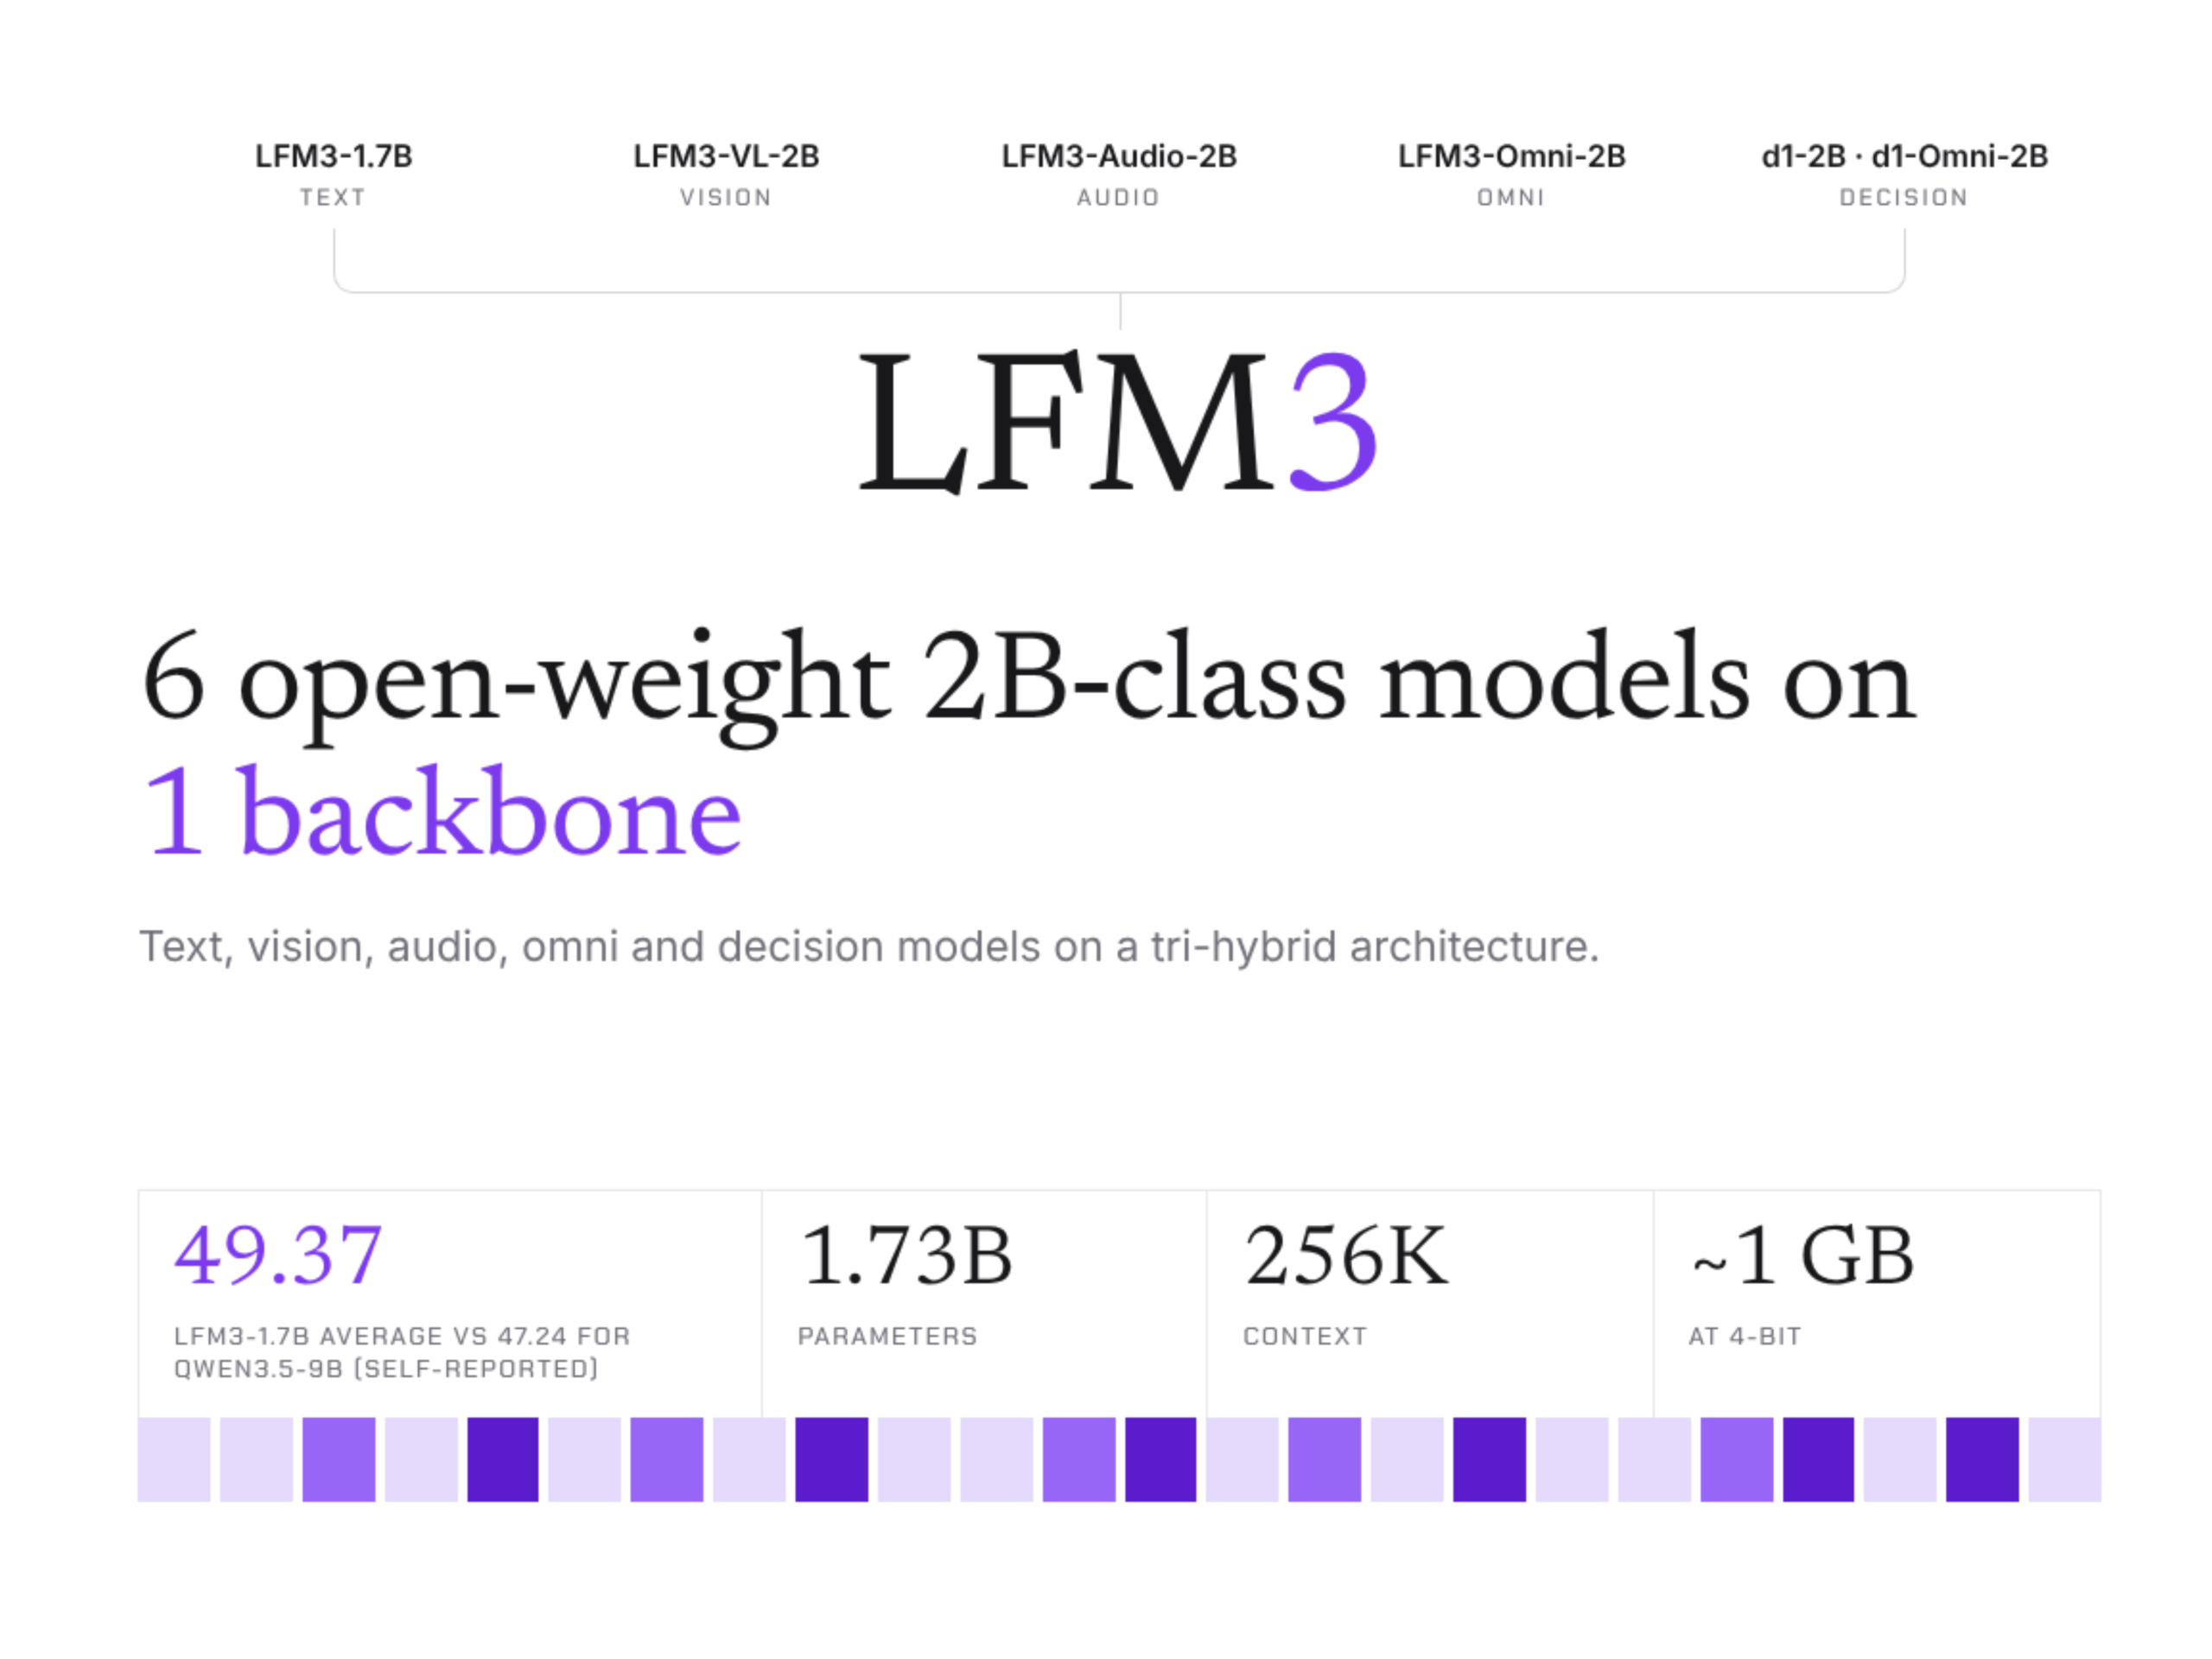
Liquid AI a lancé LFM3, sa nouvelle génération de modèles de base Liquid. Liquid AI LFM3 est une famille de 6 modèles à poids ouverts de classe 2B, construits sur une architecture commune. Cette famille couvre les tâches liées au texte, à la vision, à l’audio, à l’omnicanal et à la prise de décision. Chaque modèle peut être affiné sur un seul GPU. Les développeurs peuvent ensuite le déployer sur des téléphones, des ordinateurs portables, des serveurs privés ou dans le cloud.
LFM3 est une famille de modèles multimodaux développée par Liquid AI, qui comprend six modèles dérivés d’un modèle d’IA de base. Tous ces modèles sont issus du système LFM3-1.7B-Base.
En parallèle, l’architecture principale combine 3 opérateurs répartis sur 24 couches. Elle comprend 13 couches de convolutions courtes avec porte, 5 couches d’attention à fenêtre glissante et 6 couches d’attention globale. La fenêtre SWA compte 256 tokens. Le nombre de noyaux de convolution est passé de 3 à 7.
L’équipe de Liquid AI a découvert cette configuration grâce à sa recherche basée sur une architecture « hardware-in-the-loop ». Le modèle LFM2 a été optimisé sur un téléphone et un ordinateur portable. Le modèle LFM3 a été optimisé sur 14 combinaisons d’appareils et de backends, parmi lesquelles figuraient un Raspberry Pi 5 et le NPU Hexagon de Qualcomm.
Parmi les autres modifications, on peut citer l’utilisation de portes sigmoïdes « head-wise » pour l’attention, l’application partielle de la méthode RoPE sur les couches globales et la norme « sandwich ». Le modèle d’IA de base a traité 22 T de tokens. Les 3,5 T de tokens derniers correspondaient à une phase intermédiaire de l’entraînement fortement axée sur les agents, qui a en outre étendu le contexte à 256 K.
L’entraînement a été mené en quatre étapes. On a d’abord procédé à un SFT sur des jetons de 1,75 T, puis à un apprentissage par renforcement mixte. Ensuite, six enseignants spécialisés ont été regroupés en un seul modèle, avant de passer à un apprentissage par renforcement agentique.
Liquid AI indique que le modèle LFM3-1.7B surpasse le LFM2.5-2.6B avec 35 % de paramètres en moins. Cependant ce sont surtout les résultats obtenus par les agents qui retiennent l’attention. Sur WebArena-Verified, il obtient un score de 38,42, contre 28,94 pour Qwen3.5-9B. Sur BFCL V4, il obtient un score de 71,39, contre 62,83.
Notons par ailleurs, la taille reste un atout en matière de connaissances et de codage agentique. Le score GPQA Diamond s’élève à 63,37, contre 80,40 pour Qwen3.5-9B. Le score SWE-bench Verified est de 43,40, contre 51,20. La recherche réduit l’écart : le score de Humanity’s Last Exam passe de 7,17 à 13,90 grâce aux outils.
Une affaire qui méritera assurément d’être suivie de près.
À lire également :
- Baidu met en open source « Unlimited OCR 2 » pour l’analyse de documents de cent pages
- Nanbeige lance Nanbeige4.3-33B, un modèle de codage agentique ouvert de type 33B
Reportage initial : MarkTechPost : MarkTechPost