Un nouveau jalon vient d’être franchi dans l’univers de l’intelligence artificielle.
OpenAI présente Pando : un backend Git qui réduit la latence médiane des push d’environ 80 %
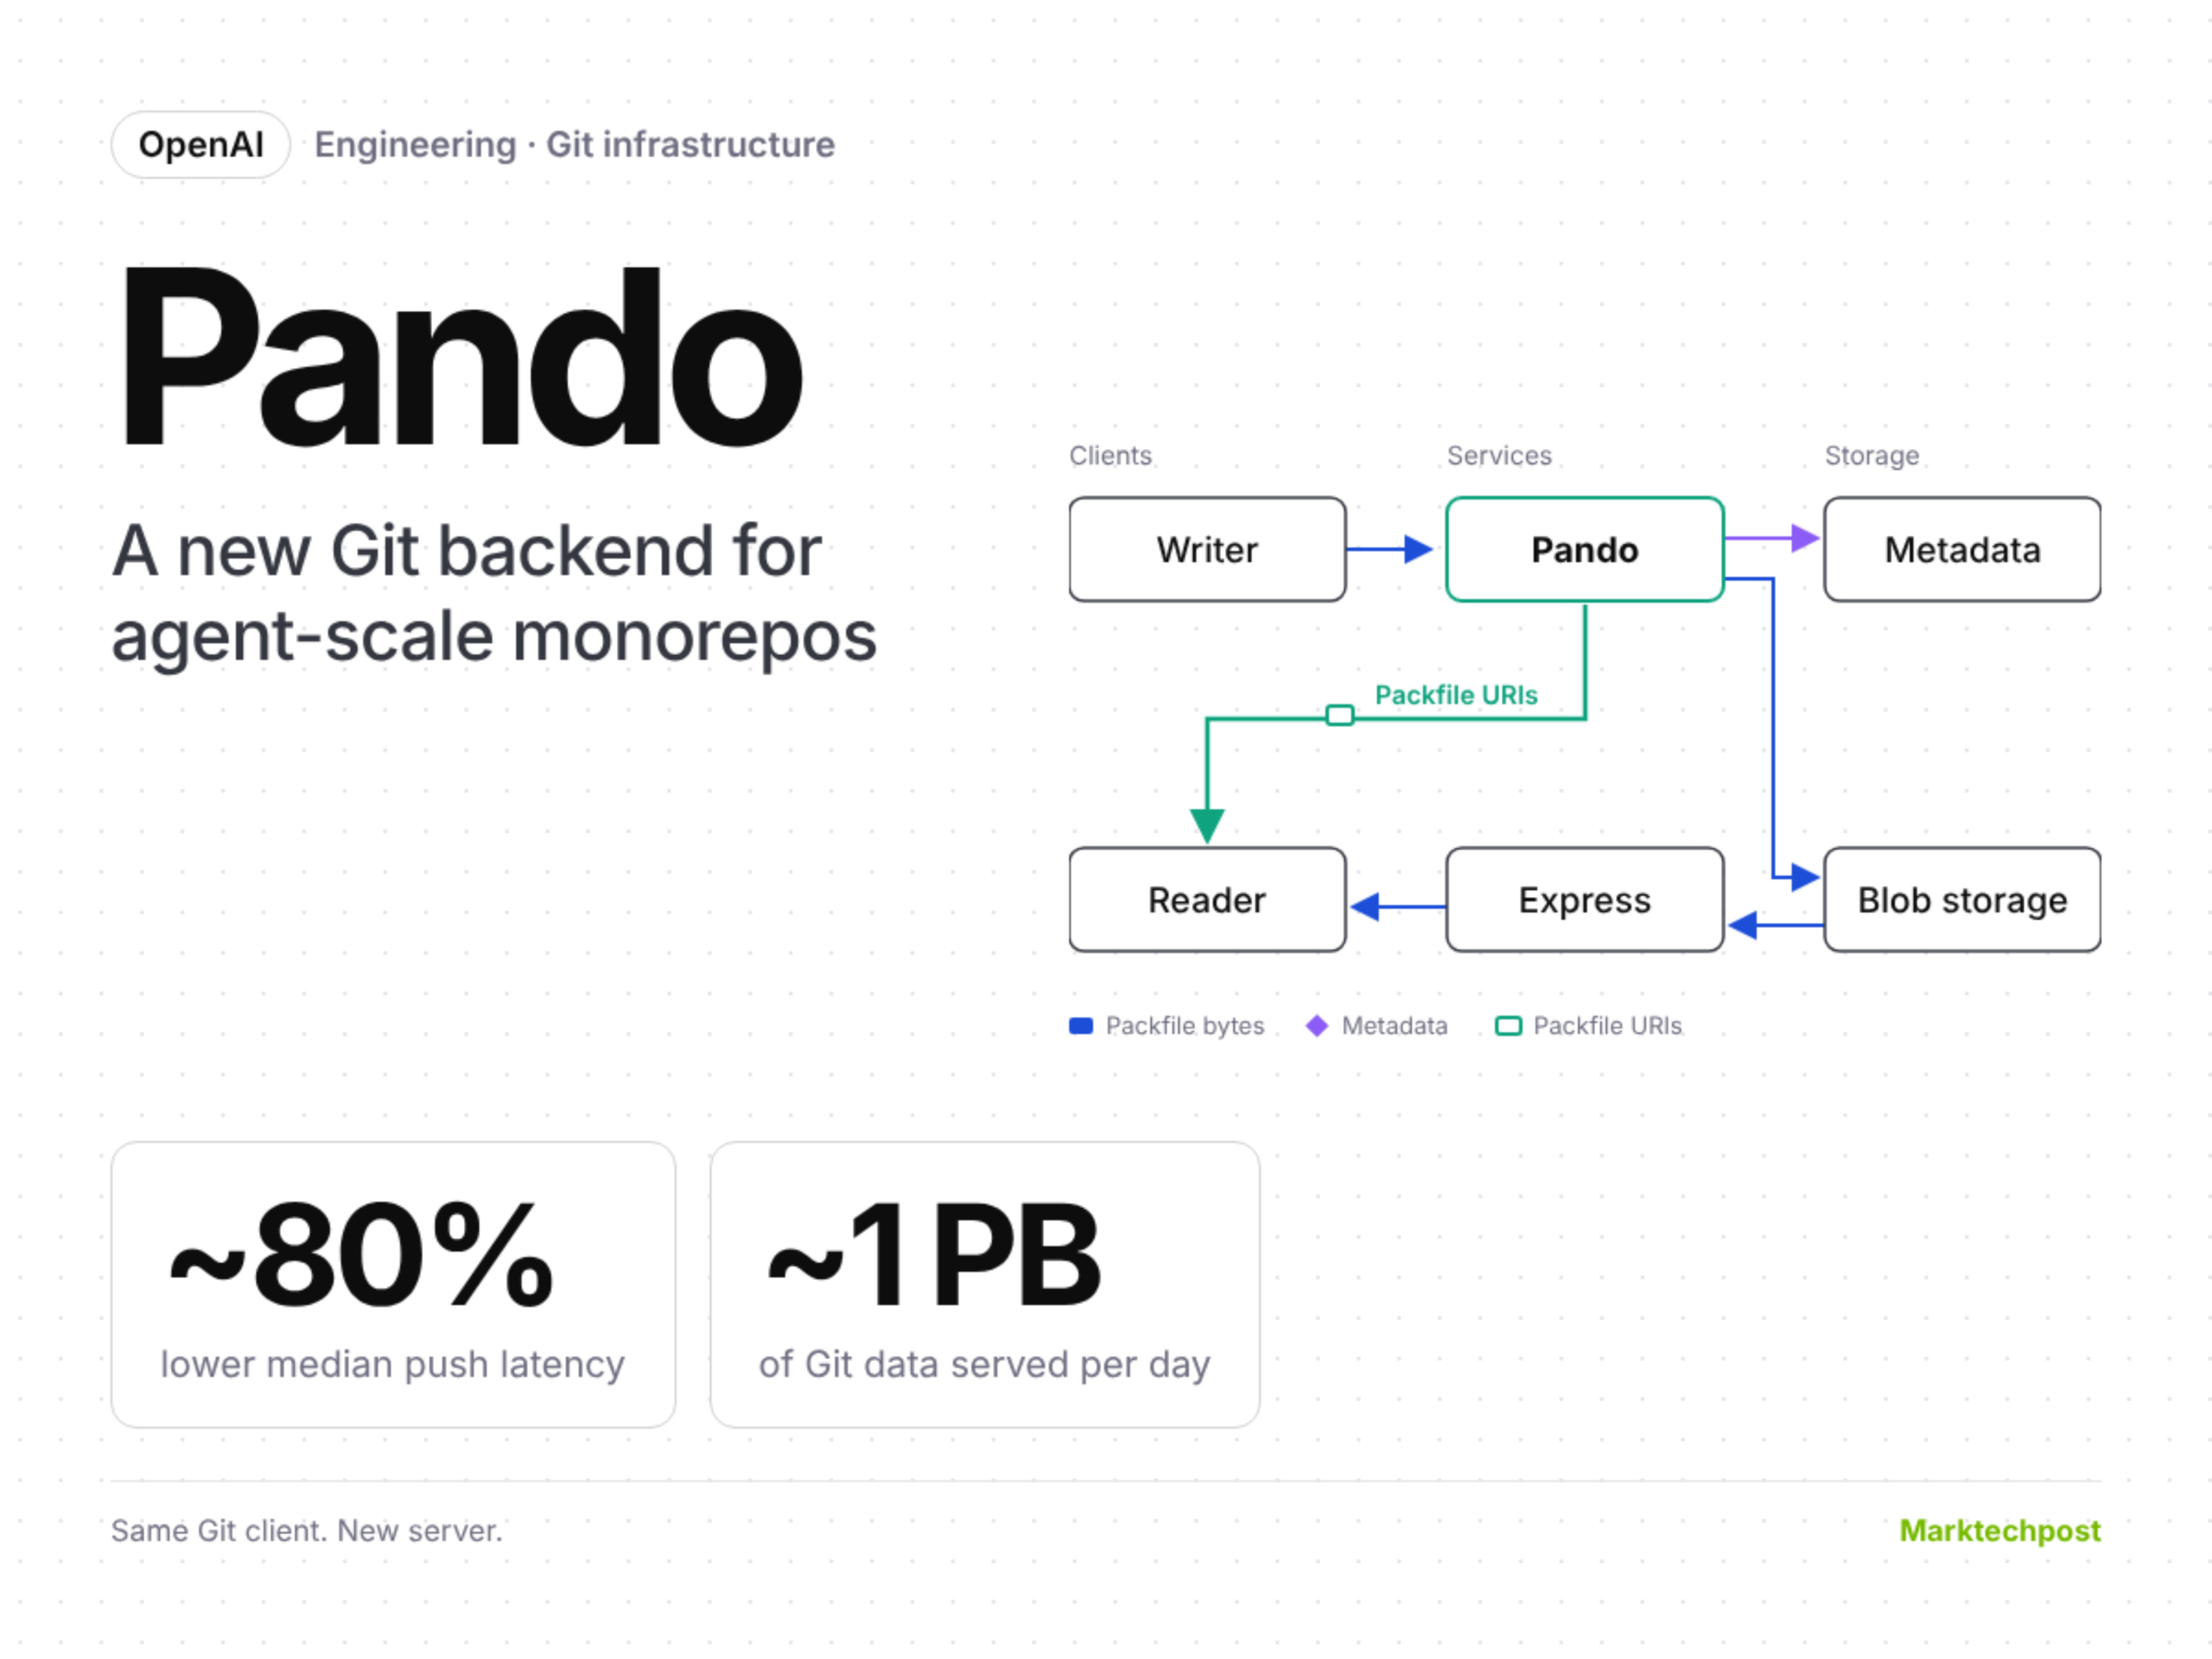
OpenAI a lancé Pando, un nouveau backend Git qui prend désormais en charge l’ensemble du progression au sein de son monorepo. Le backend Git Pando d’OpenAI conserve le client et le protocole Git standard. Les ingénieurs et les agents Codex continuent d’utiliser les commandes « git push » et « git fetch » comme auparavant. Seul le serveur a changé. L’équipe d’OpenAI indique que la latence médiane des poussées a diminué de près de 80 %. Pando traite désormais près d’un pétaoctet de éléments Git par jour.
Pando est un backend serveur compatible Git développé par OpenAI, qui rend possible de gérer de manière évolutive les opérations simultanées de push et de fetch pour un monorepo. Écrit en Rust, il a été mis en production en 10 semaines. Un ingénieur en a conçu le cœur, et des équipes d’agents Codex se sont chargées de sa mise en œuvre. Il traite le trafic de production depuis avril 2026.
Chaque branche est sérialisée séparément, et les clients ne rencontrent de conflit que lorsqu’ils poussent la même référence.
Codex a multiplié le travail en parallèle. Le graphique des commits d’OpenAI montre une hausse de 1 378 % du nombre de commits intégrés à la branche « master » au troisième trimestre 2026 par rapport au premier trimestre 2024. Ses estimations pour le quatrième trimestre 2026 indiquent une hausse de 2 442 %. Chaque push déclenche désormais de nombreuses récupérations CI. Fin 2025, les récupérations et les pushes ont ralenti, les fusions ont échoué et la fiabilité est parfois tombée en dessous de 90 %. OpenAI en a conclu que le goulot d’étranglement résidait dans la manière dont Git était mis à disposition, et non dans Git lui-même.
Pando ne se base pas sur deux hypothèses que la plupart des serveurs Git considèrent comme des exigences :
1. Cohérence à l’échelle du dépôt : les serveurs classiques ordonnent chaque mise à jour de référence à l’échelle du dépôt, ce qui entraîne une mise en attente des poussées sans rapport entre elles. Pando utilise plutôt la cohérence causale. Chaque branche est sérialisée séparément, et les clients ne rencontrent de conflit que lorsqu’ils poussent la même référence. Le compromis : un lecteur consultant plusieurs branches peut les voir à des moments différents.
2. Un fichier pack unique par client : les serveurs standard génèrent un nouveau pack à chaque récupération. Pando stocke chaque pack envoyé sous la forme d’un blob immuable. Une « version de référence » est enregistrée dans un magasin de métadonnées évolutif. Une opération de push nécessite O(1) lectures et écritures de métadonnées. Une récupération nécessite O(log Δ) lectures, où Δ correspond à l’écart de version de référence à combler.
Pando renvoie les liens de téléchargement via `packfile-uri`, une fonctionnalité existante du protocole Git. Il envoie un pack intégré vide. Un service de livraison appelé Express met en cache les packs au niveau régional, en utilisant un hachage cohérent, avec des taux de réussite supérieurs à 99 %.
Les acteurs concernés devront s’adapter à ce nouveau contexte.
Sur le même sujet :
D’après MarkTechPost : MarkTechPost