Cette semaine apporte son nouveau chapitre dans le grand livre de l’IA.
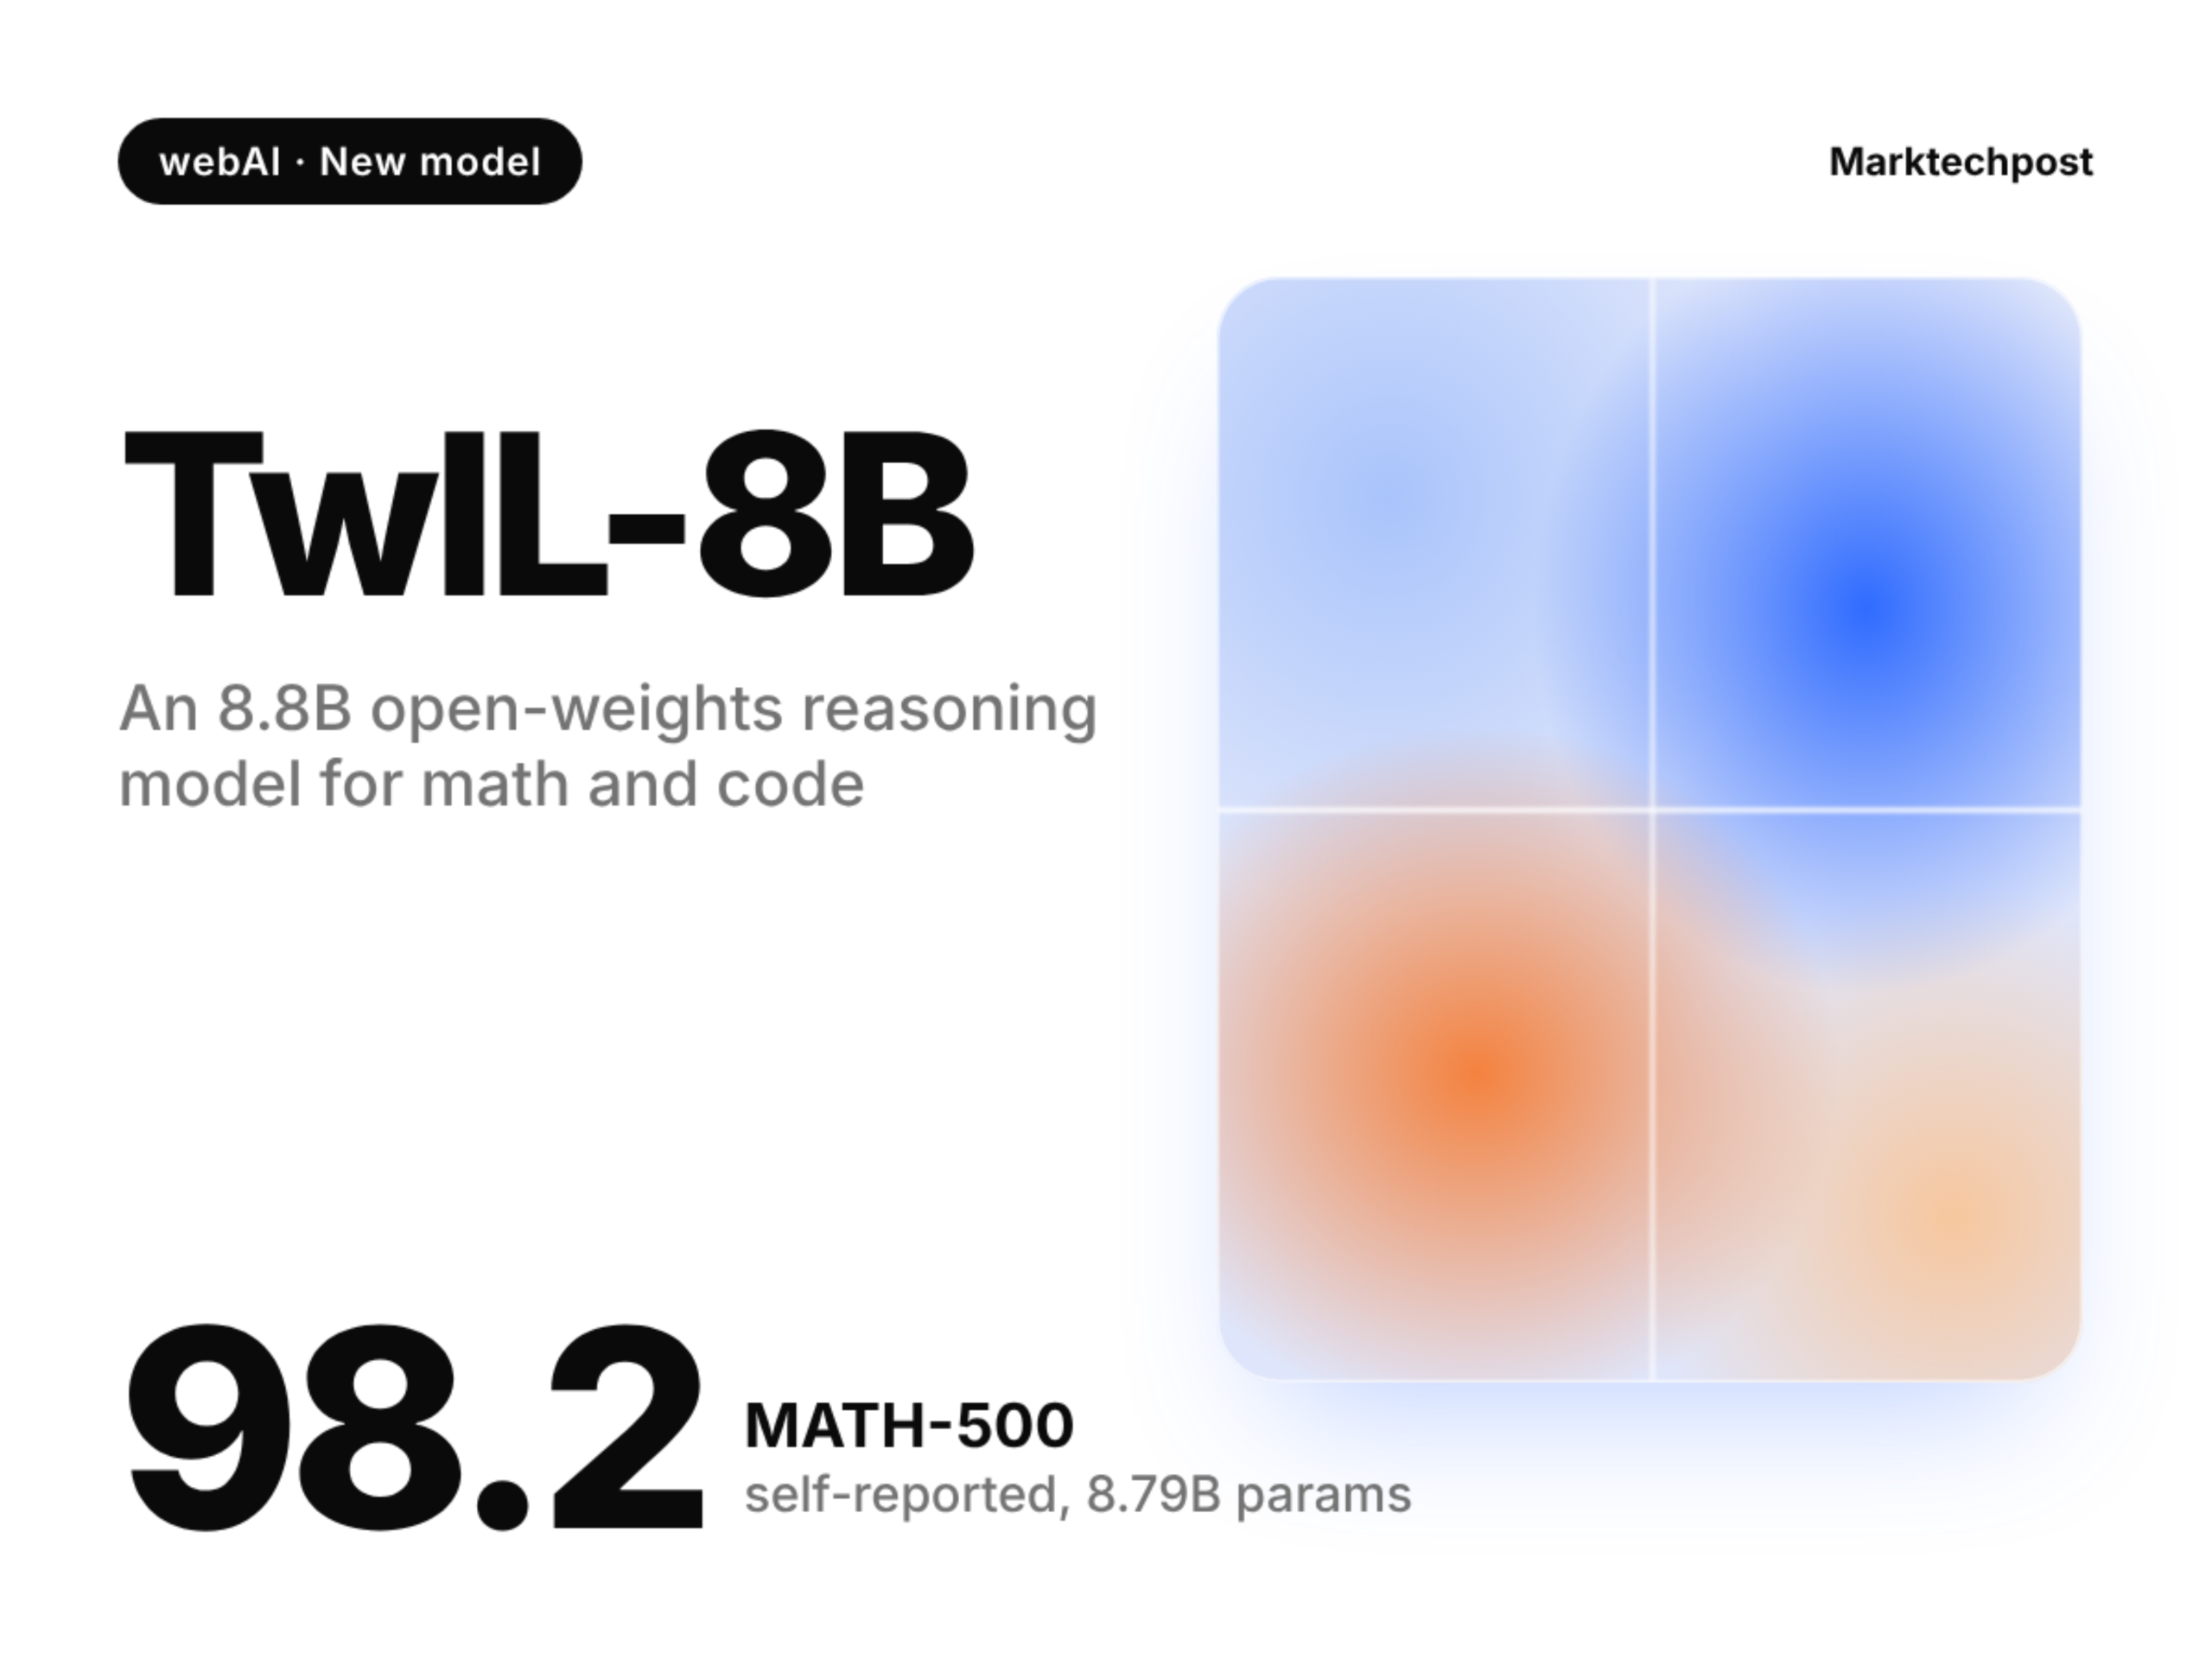
webAI lance TwIL-8B, un modèle de raisonnement de 8,8 milliards de paramètres obtenant un score de 98,2 au test MATH-500
webAI a lancé TwIL-8B, un modèle de raisonnement de 8,8 milliards de paramètres dédié aux mathématiques, au code et à l’exécution d’instructions. Le modèle de raisonnement TwIL-8B a été entraîné a posteriori à partir du modèle Granite 4.2 8 milliards d’IBM. Les poids sont disponibles sur Hugging Face sous une licence non commerciale. L’article de lancement de webAI met l’accent sur le coût par tâche, et non sur la taille brute du modèle. La version 4 bits pèse 4,98 GiB ; elle est conçue pour l’inférence sur processeur ou sur carte graphique dotée d’une mémoire vidéo modeste.
TwIL-8B est un modèle de raisonnement dense, exclusivement dédié au décodage, développé par webAI. Il comporte 40 couches, une taille de mémoire cachée de 4 096 et 32 têtes d’attention, dont 8 têtes KV. Les entrées et les sorties sont exclusivement constituées de texte en anglais. Le modèle rédige un bloc
Il est disponible en deux variantes, dotées de la même architecture et du même tokeniseur. « Balanced » est la variante par défaut et génère des traces de raisonnement plus courtes. « Verbose » propose des raisonnements plus longs et est destiné aux problèmes complexes de type concours.
À noter également, twIL-8B vient compléter la famille TwIL de webAI. Les premiers modèles de cette famille, basés sur la logique formelle, étaient les modèles 1.7B et 3B, lancés en août 2026.
Les ensembles de données d’entraînement ont été décontaminés à l’aide d’un alignement de 13 grammes par rapport aux ensembles de données d’évaluation AIME, HMMT, MATH-500, GPQA et d’autres.
Tous les scores au test TwIL-8B sont autodéclarés, obtenus en mode « pass@1 » avec un effort important et l’option « réflexion » activée. Les scores marqués d’un † ont été mesurés uniquement sur la variante détaillée.
Sur 13 benchmarks communs, TwIL-8B affiche un bilan de 7 victoires pour 6 défaites face à Qwen3.5-9B. Face à Gemma 4 31B, dont la taille est environ 3,5 fois supérieure à la sienne, son bilan est de 3 victoires pour 11 défaites.
Un dossier qu’il faudra continuer à observer dans les mois à venir.
À lire également :
Reportage initial : MarkTechPost : MarkTechPost