Un développement récent dans le monde de l’IA attire l’attention.
Google AI Research publie un cadre de délibération agile pour les classificateurs d’images en zone grise
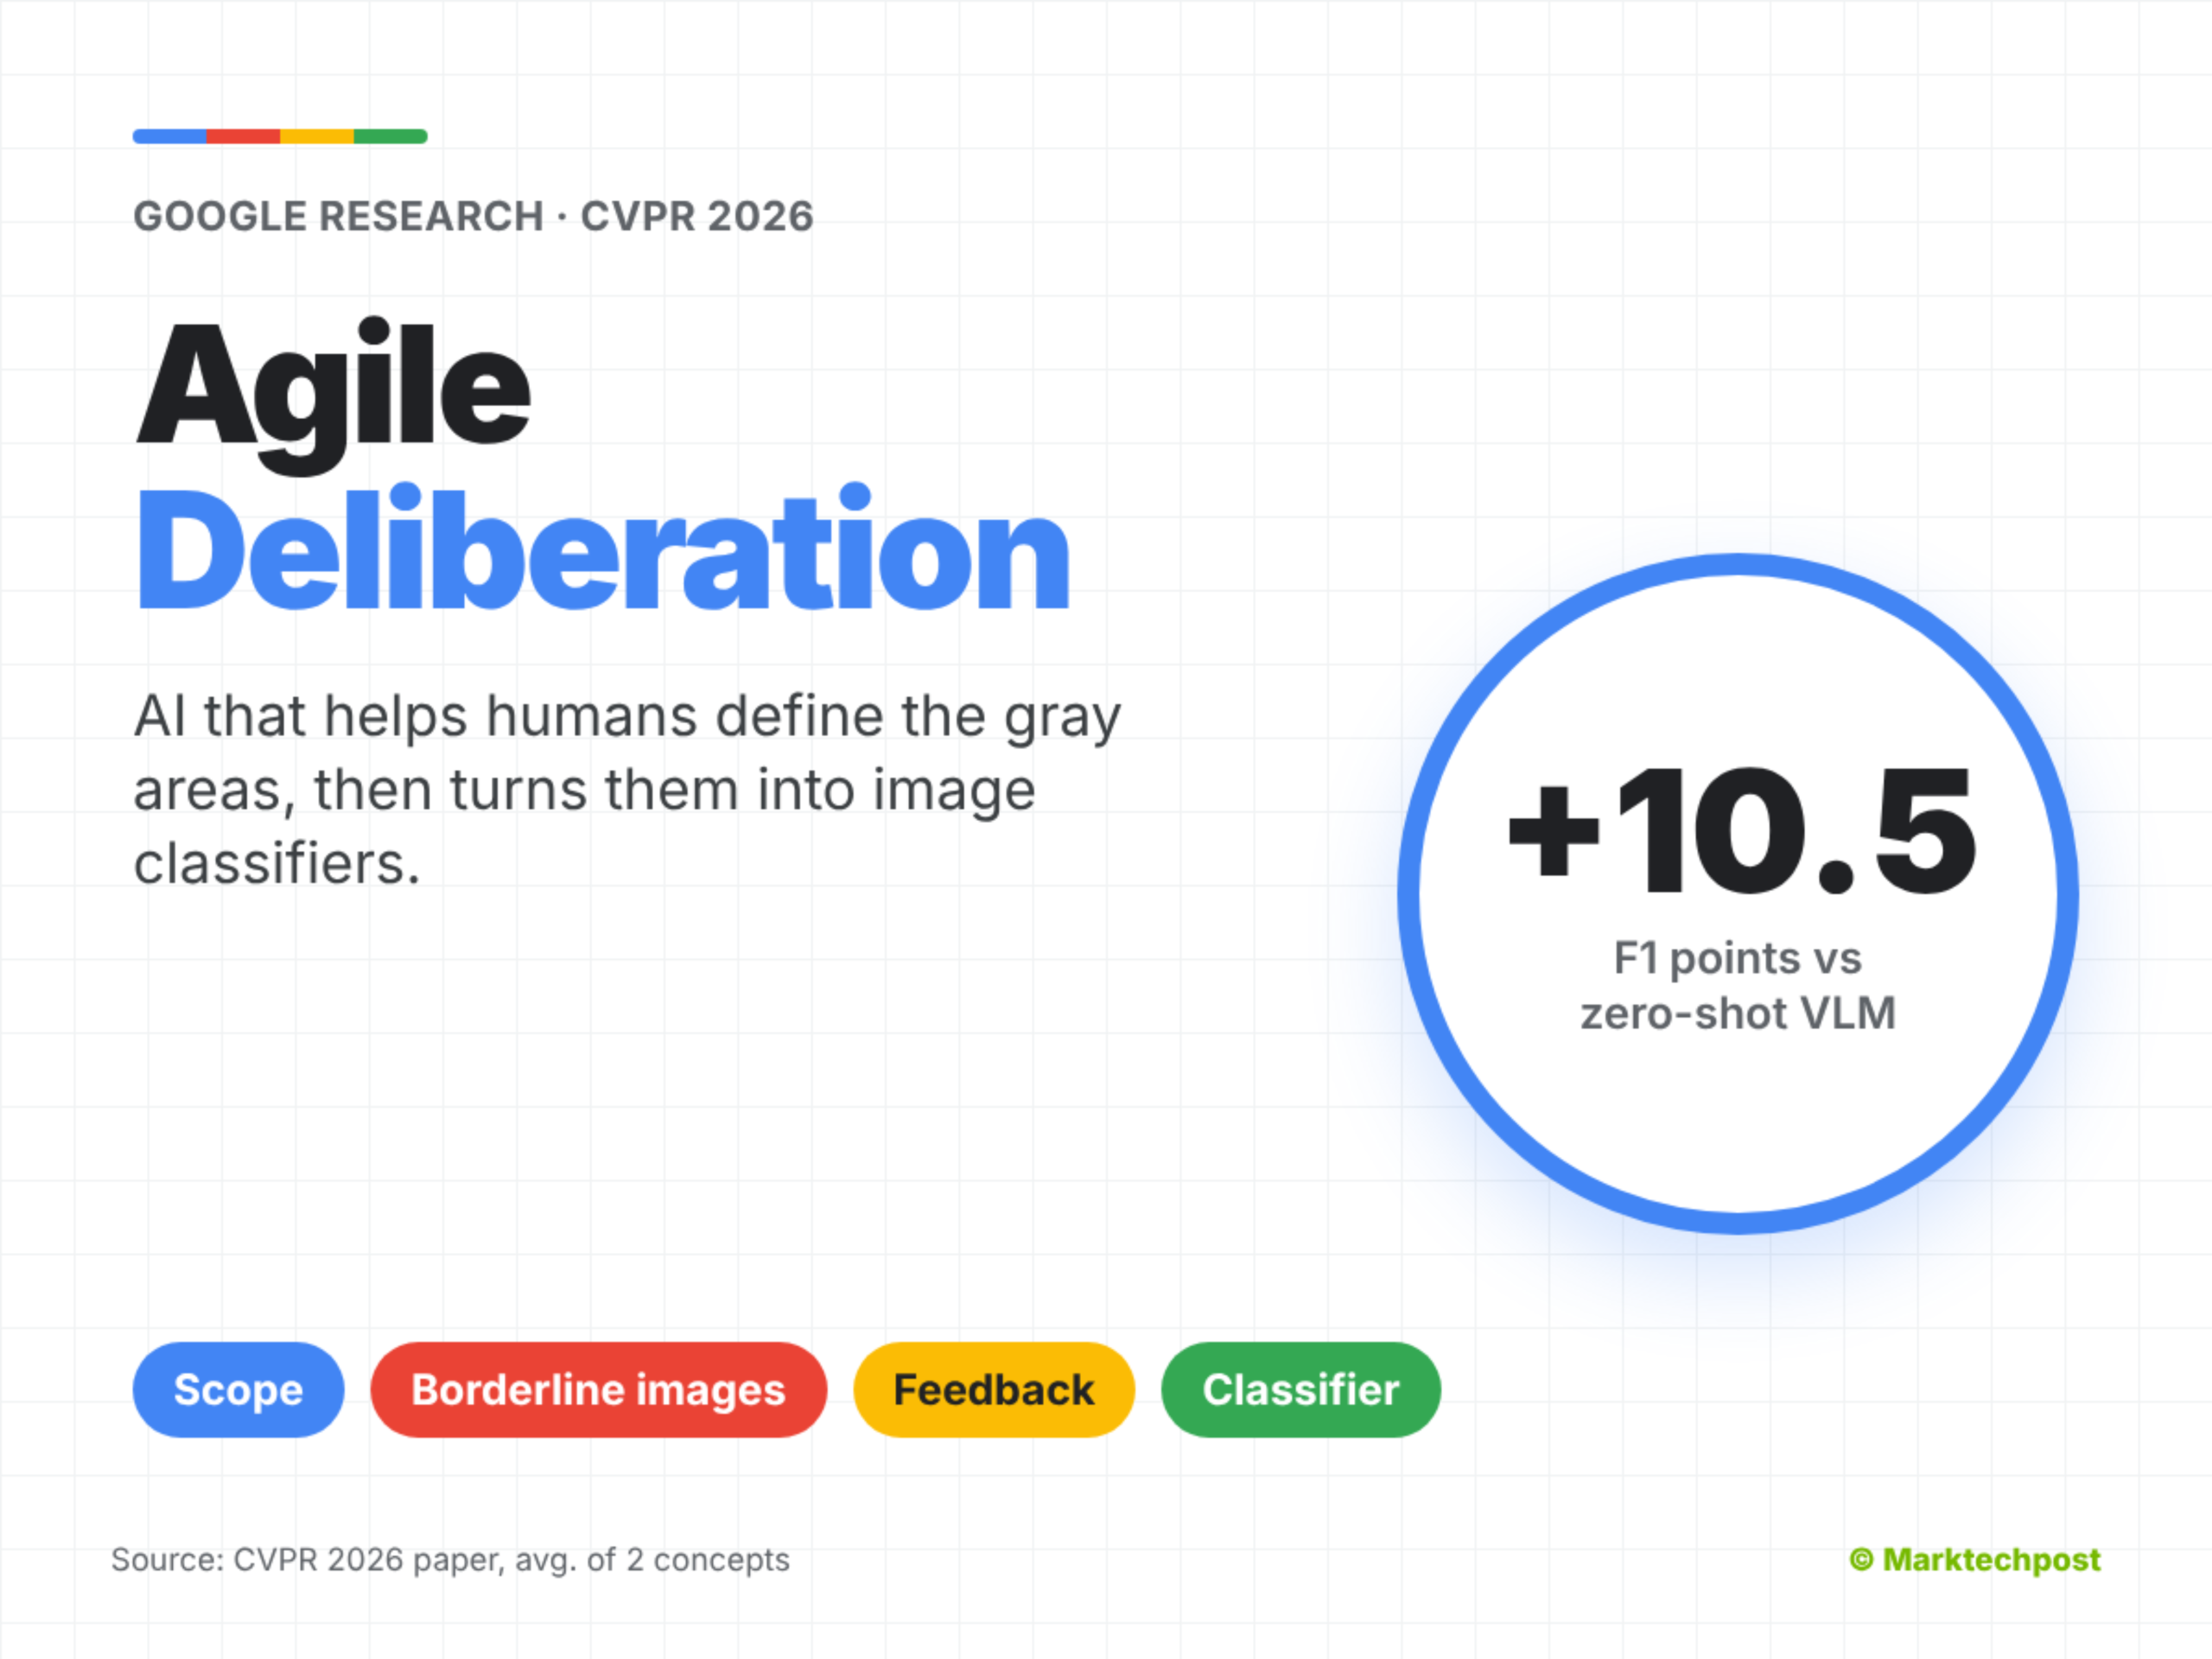
Google Research a lancé « Agile Deliberation », un cadre intégrant l’intervention humaine (human-in-the-loop) destiné à la création de classificateurs d’images autour de concepts subjectifs. Pensez à des notions telles que « alimentation saine », « œuvre d’art inspirante » ou encore aux « titres racoleurs » dans le cadre de la modération de contenu. La plupart des outils partent du principe que les utilisateurs connaissent déjà les limites de ces concepts. « Agile Deliberation » part du principe qu’ils ne les connaissent pas et les aide à les définir.
D’un autre côté, « Agile Deliberation » est un cadre développé par Google Research qui transforme un concept vague en une définition écrite structurée. Cette définition remplit deux fonctions : elle constitue à la fois une politique compréhensible par l’homme et le texte d’entrée d’un classificateur VLM. À chaque itération, le système conserve la définition candidate présentant le meilleur score F1 par rapport aux étiquettes fournies par l’utilisateur.
Pour l’alimentation saine, les sous-concepts positifs pourraient être les salades ou les bols de céréales.
La conception est issue d’entretiens menés auprès d’un groupe d’experts en modération de contenus. Ces experts ont d’abord défini les grandes lignes d’un concept, puis l’ont affiné à partir d’images limites. La recherche de ces images a constitué la partie la plus longue du processus.
En parallèle, la phase 1 décompose le concept en trois sous-concepts au maximum, en utilisant l’enchaînement de prompts avec Gemini 2.5 Pro. Chaque sous-concept se voit attribuer des sous-concepts positifs et négatifs potentiels, illustrés par des images extraites. Pour l’alimentation saine, les sous-concepts positifs pourraient être les salades ou les bols de céréales. Les sous-concepts négatifs pourraient être les aliments transformés ou les ingrédients crus et non préparés. L’utilisateur peut garder, retourner ou jeter chacune d’entre elles.
L’étape 2 fait l’impasse sur l’échantillonnage classique basé sur l’incertitude. Le classificateur étant un système VLM génératif guidé par des prompts, ses scores de confiance ne sont souvent pas calibrés. Le mécanisme recherche donc plutôt des images dont la signification est limite.
Les utilisateurs annotent chaque image et ajoutent de brèves remarques en cas de désaccord. Un modèle d’IA de langage de grande envergure (LLM) transforme ces remarques en définitions potentielles. Une mise à jour « gloutonne » conserve celle qui obtient le meilleur score.
Le contexte technologique évolue, et ce type d’annonce en témoigne.
À découvrir aussi :
Information publiée en premier lieu par MarkTechPost : MarkTechPost