
L’écosystème de l’intelligence artificielle continue sa progression à un rythme soutenu.
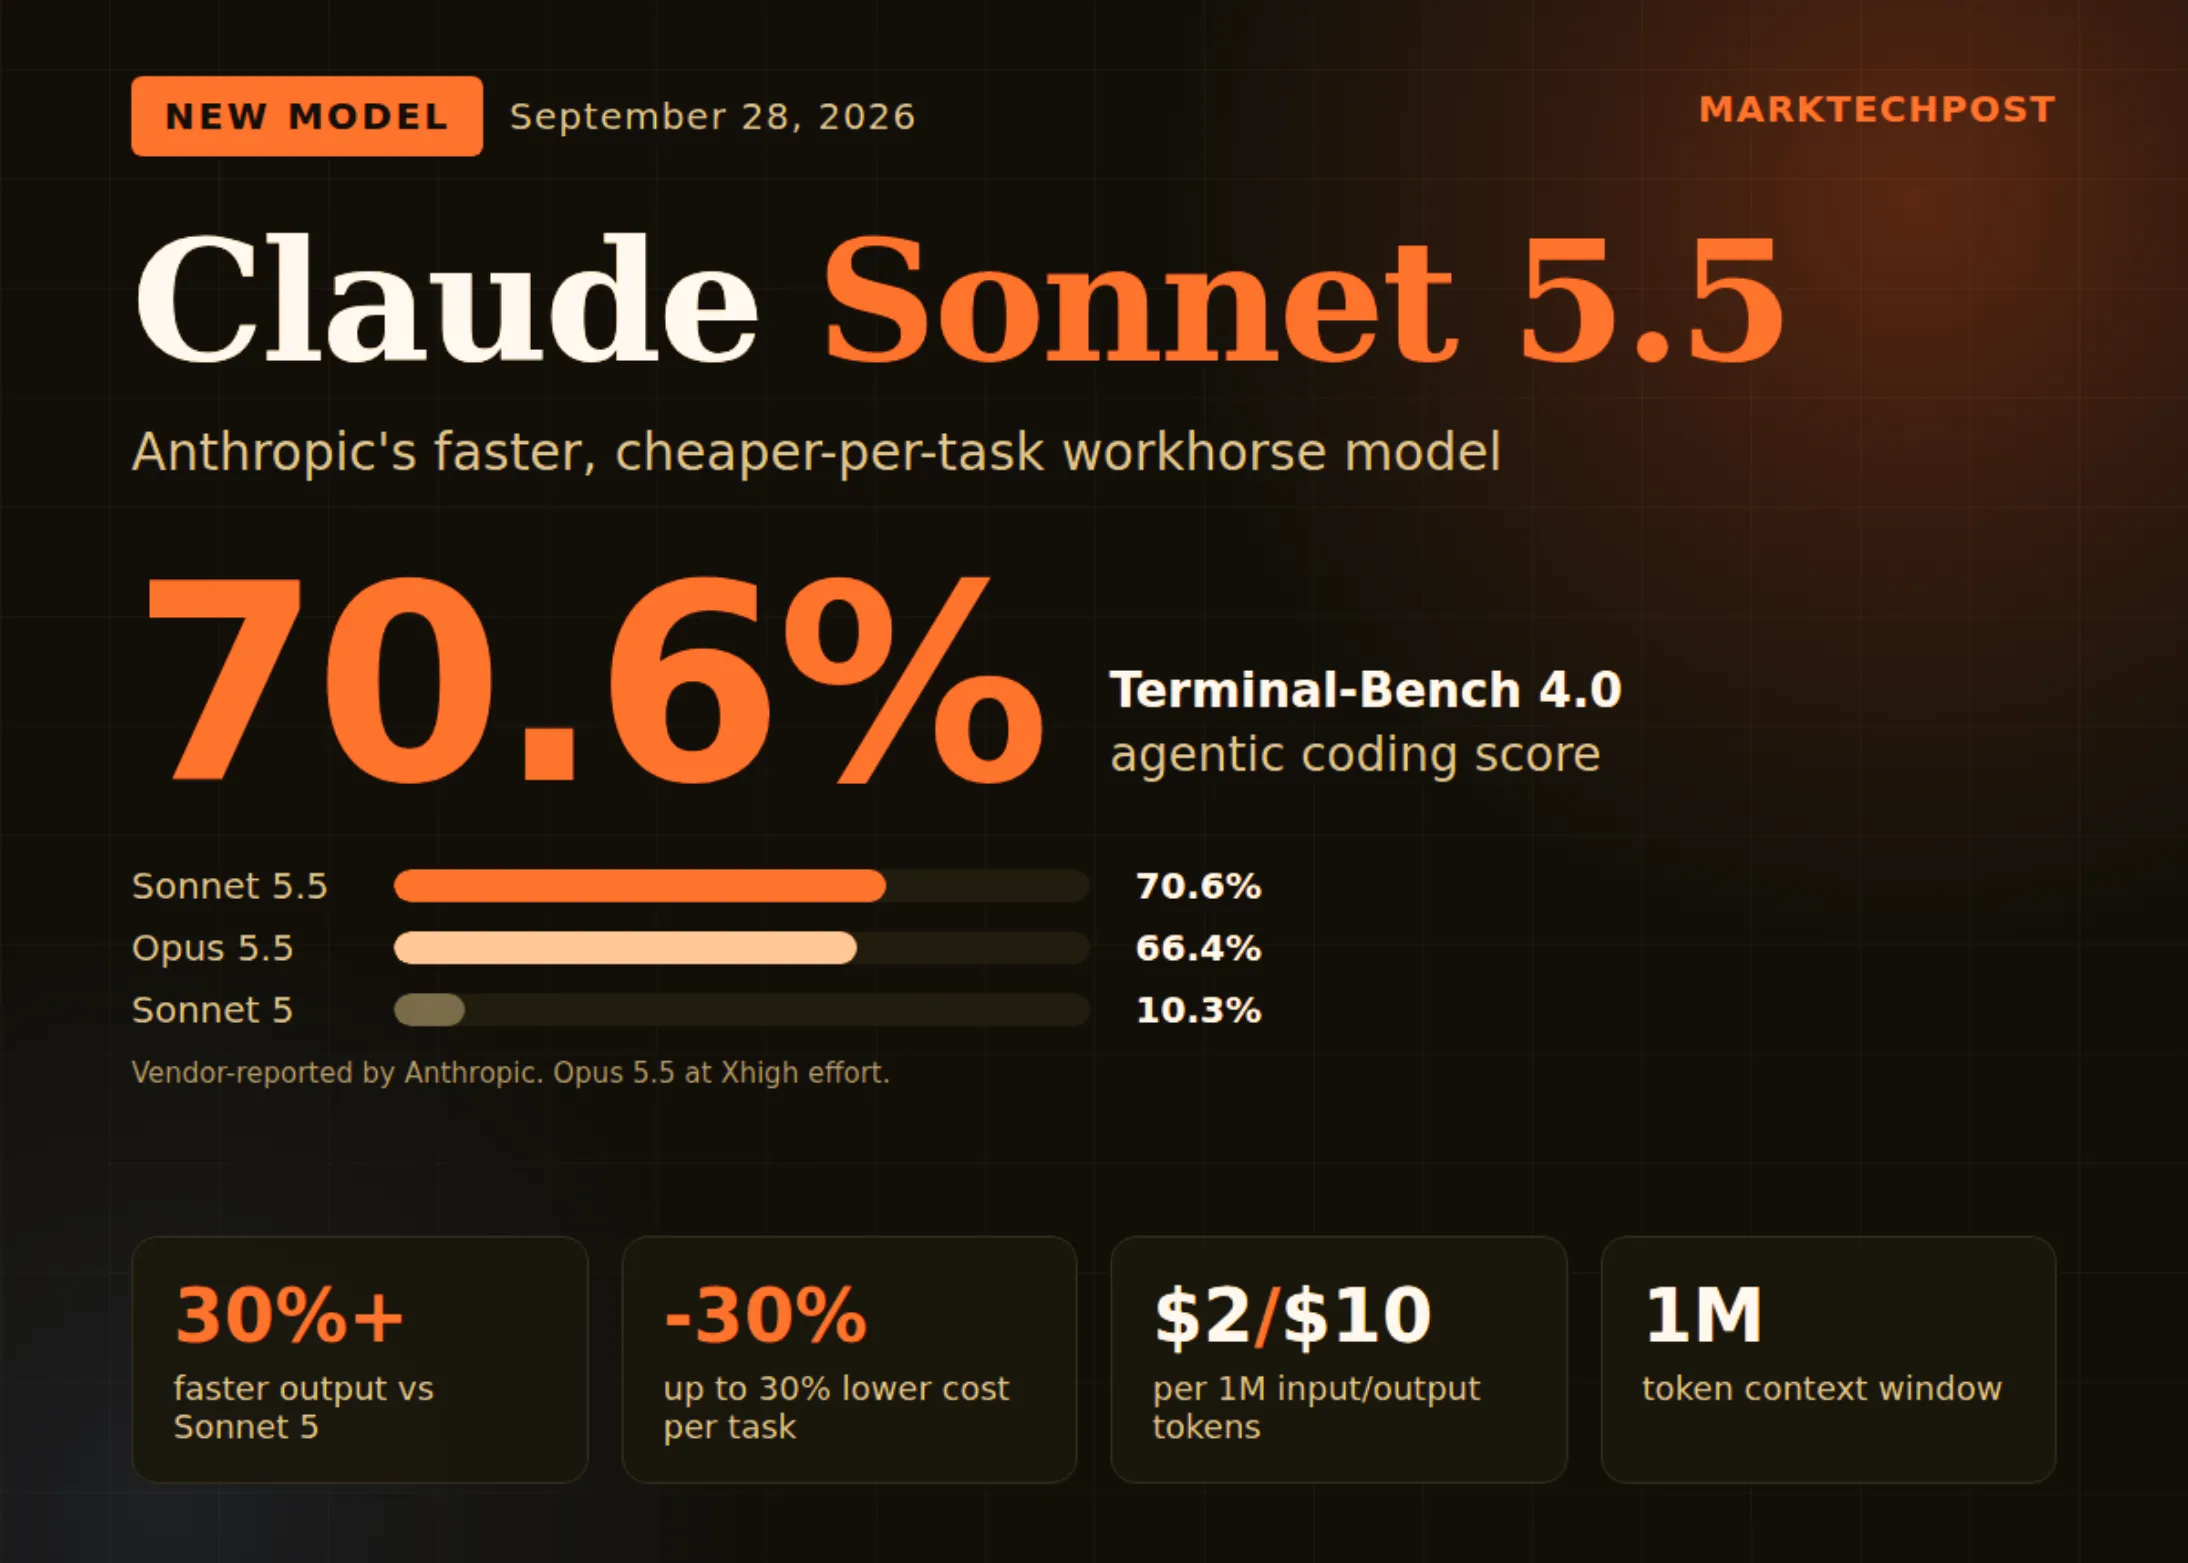
Anthropic lance Claude Sonnet 5.5 : 70,6 % sur Terminal-Bench 4.0, toujours au même prix de 2 $/10 $
Anthropic vient de lancer Claude Sonnet 5.5. Il s’agit du deuxième modèle de la gamme Claude 5.5, après Claude Opus 5.5. Anthropic le présente comme un complément plus rapide et moins coûteux à Opus 5.5. Il est destiné aux tâches quotidiennes bien définies, à la correction de bugs, ainsi qu’à la mise au point de documents, de diapositives et de feuilles de calcul.
Est-il déployable ? Oui, il est disponible sur la plateforme Claude sous le nom « asclaude-sonnet-5-5 », de cette manière que sur AWS, Google Cloud et Microsoft Azure. Il s’agit d’un modèle à poids fermés ; l’auto-hébergement n’est donc pas possible.
Caractéristiques techniques issues de la présentation des modèles : contexte de 1 million de jetons, sortie maximale de 128 000, et date limite de fiabilité des connaissances fixée à juin 2026. La réflexion adaptative est activée par défaut. L’effort est classé en 5 niveaux : faible, moyen, élevé, grandement élevé et maximal.
Tous les scores ci-dessous sont ceux communiqués par le fournisseur dans l’article de lancement. La méthodologie est décrite dans la fiche technique du mécanisme Sonnet 5.5.
La valeur obtenue pour « Max » est inférieure à « Xhigh » pour une raison bien précise. À ce niveau (« Max »), le modèle a plus souvent procédé à une révision de code multi-agents. Cela a parfois entraîné des dépassements de délai ou des modifications hors champ, ce que FrontierCode pénalise. Anthropic précise également qu’Opus 5.5 reste nettement plus performant sur les tâches complexes et ouvertes.
Les tarifs catalogue restent inchangés par rapport à Sonnet 5 : 2 $ par million de jetons d’entrée et 10 $ par million de jetons de sortie. Les lectures en cache coûtent 0,20 $ et les écritures en cache 2,50 $ par million. Cela représente la moitié des tarifs d’Opus 5.5 (4 $ / 20 $). Les économies proviennent de l’efficacité des jetons, et non d’une baisse des prix.
Par ailleurs, les données clients le confirment. Balyasny Asset Management a mesuré environ 121 000 jetons par réponse, contre 497 000 sur Sonnet 5. Base44 a fait état de 3,6 itérations par build d’application, contre 7,7 pour Opus 5. Zendesk a traité les tickets 20 % plus rapidement.
Les informations principales :
- Cela a parfois entraîné des dépassements de délai ou des modifications hors champ, ce que FrontierCode pénalise.
- Les économies proviennent de l’efficacité des jetons, et non d’une baisse des prix.
- Balyasny Asset Management a mesuré environ 121 000 jetons par réponse, contre 497 000 sur Sonnet 5.
Les mois à venir apporteront sans doute plus de précisions.
Dans le même ordre d’idées :
- Toutes les nouveautés à venir pour Muse, l’agent IA de Meta | TechCrunch
- L’indice « AI Hype » : l’IA adore tricher
Information publiée en premier lieu par MarkTechPost : MarkTechPost