
Voici une annonce qui mérite l’attention des observateurs du secteur.
JetBrains lance Mellum 2.1 : un modèle ouvert MoE de 12 milliards de paramètres destiné aux agents de programmation
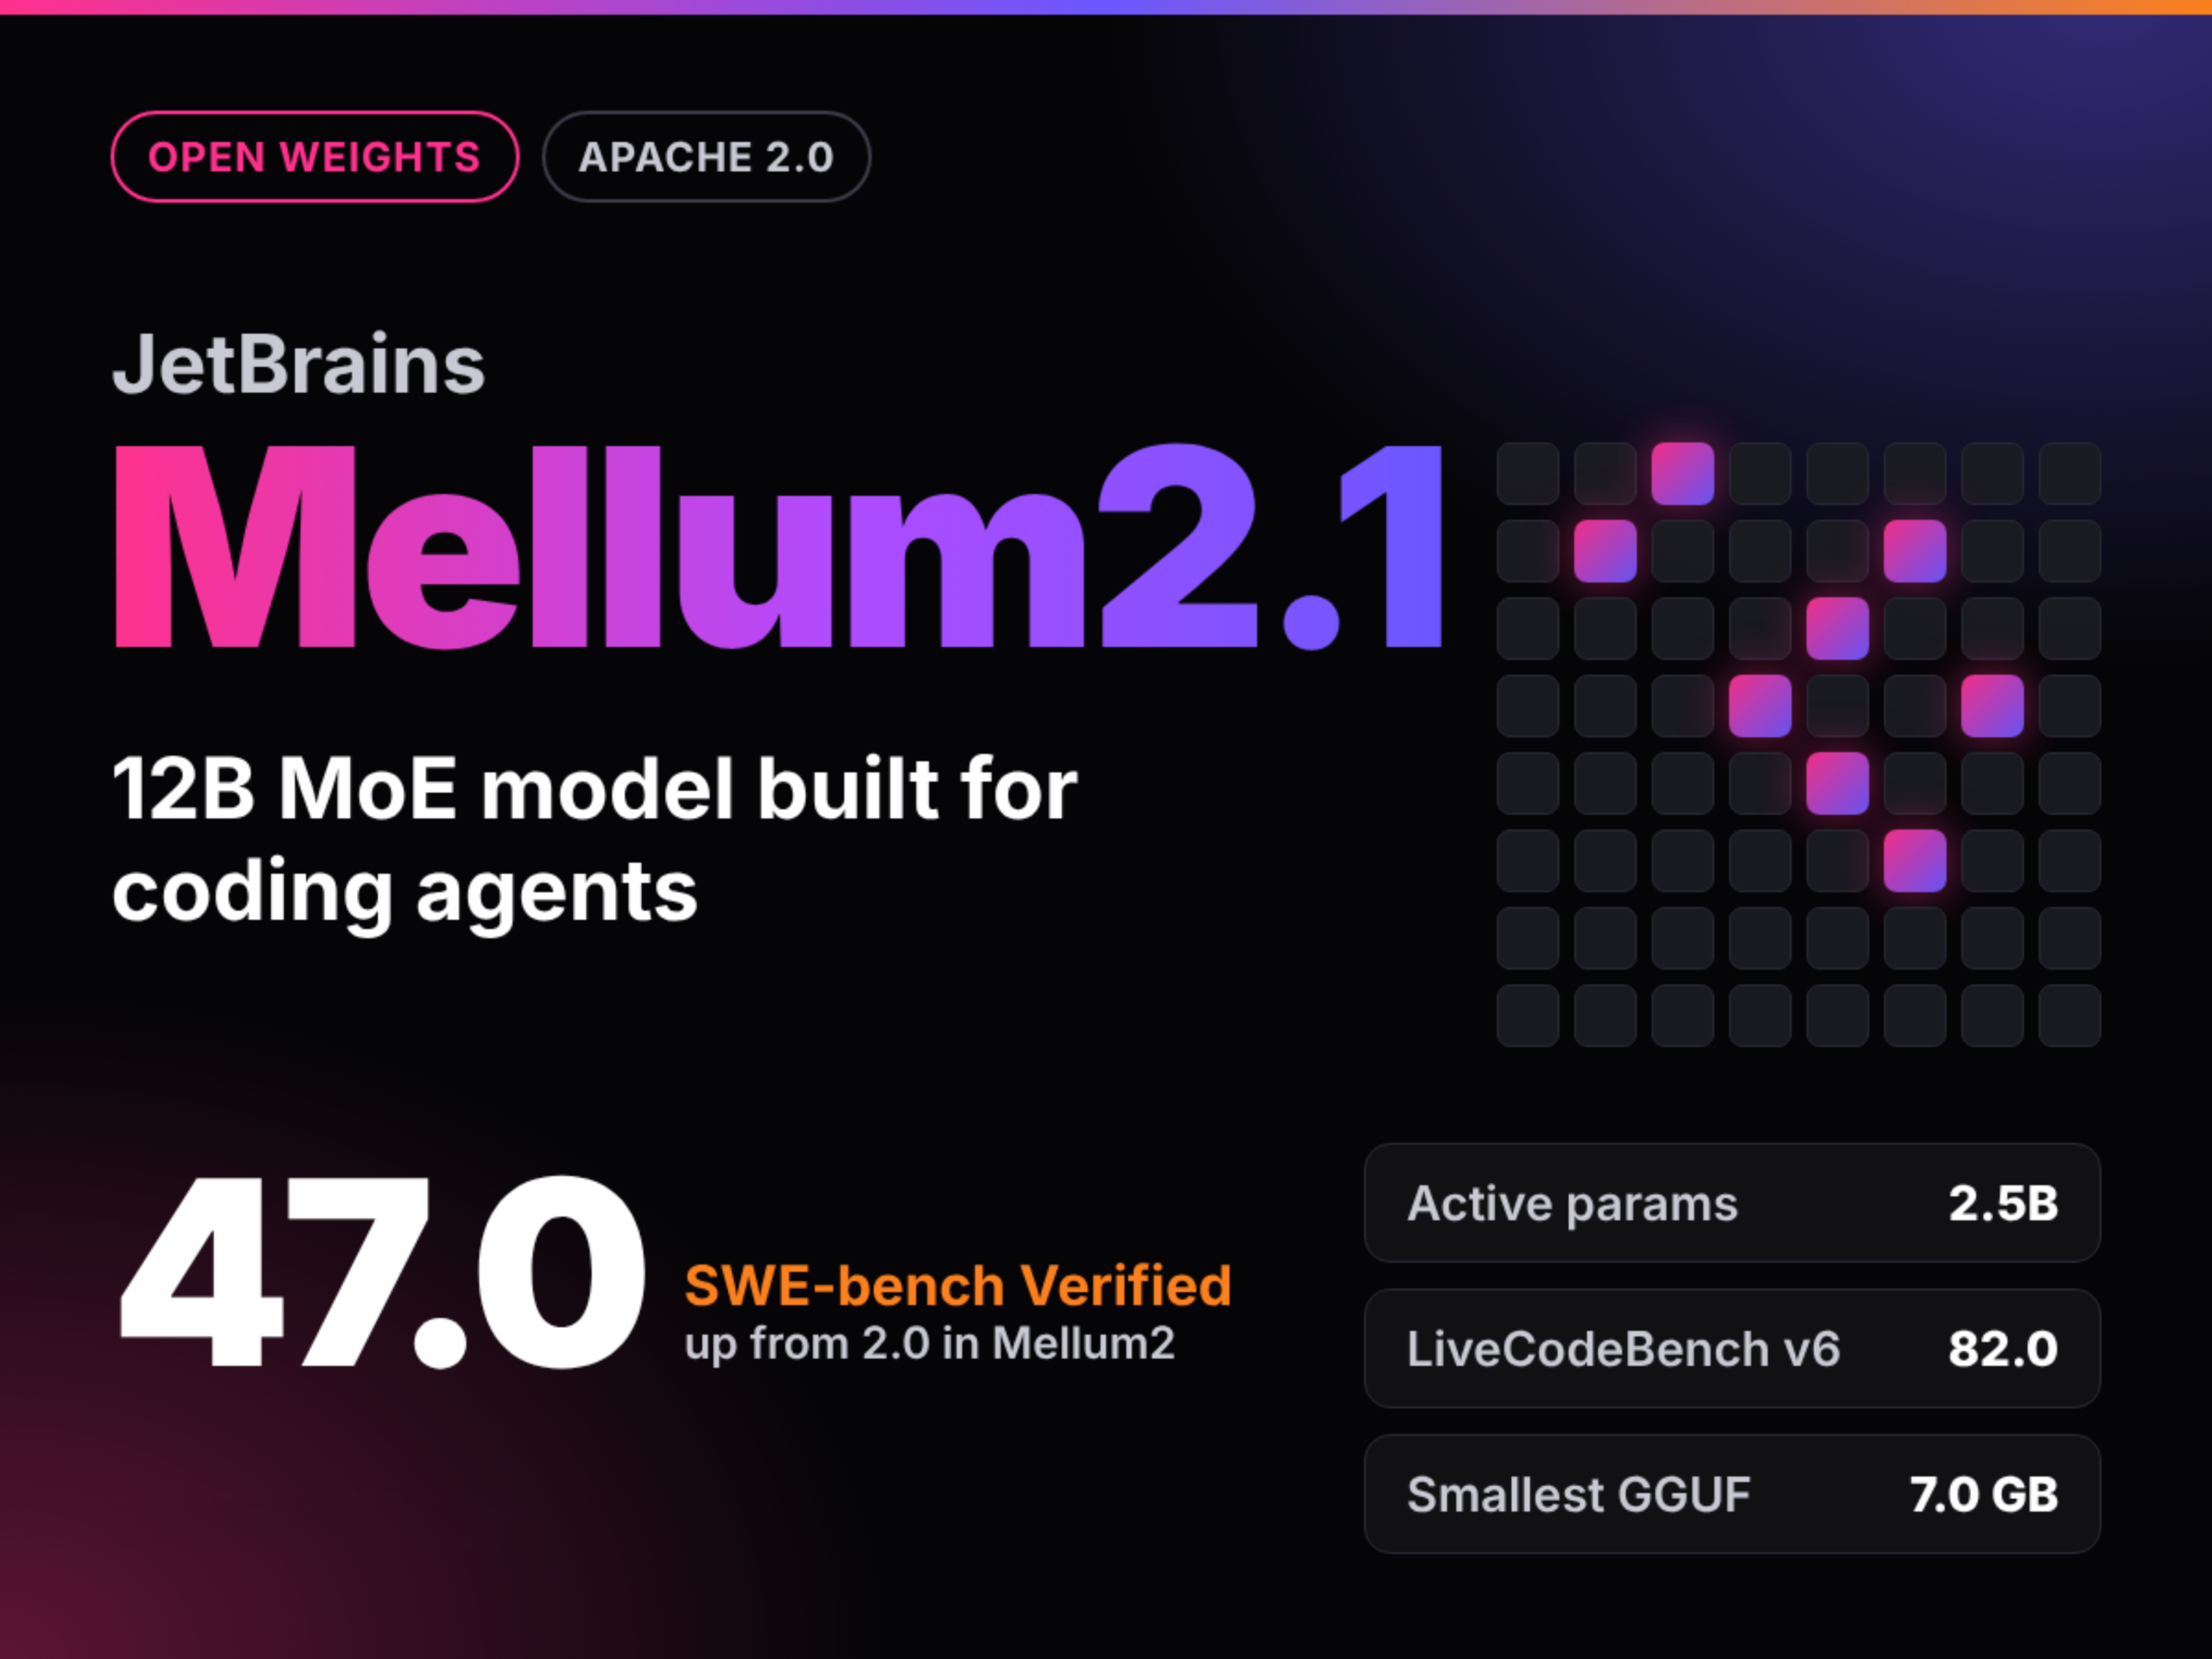
JetBrains a lancé Mellum 2.1, un modèle ouvert conçu pour les agents de codage et les sous-agents rapides. Mellum 2.1 est un modèle de raisonnement de type « mixture-of-experts » de 12 milliards de paramètres développé par JetBrains, qui active 2,5 milliards de paramètres par token. Il est disponible sous licence Apache 2.0 sur Hugging Face. L’architecture reste inchangée par rapport à Mellum 2. Cette mise à jour repose presque entièrement sur l’apprentissage par renforcement (RL) dans des environnements logiciels réels. Le résultat est un petit modèle pouvant être hébergé en local, qui explore un référentiel, modifie des fichiers et vérifie ses propres modifications.
En parallèle, mellum2.1 est la dernière version de Mellum2 Thinking, que JetBrains a mis en open source en juin 2026. Le checkpoint publié est Mellum2.1-12B-A2.5B-Thinking. Il s’agit d’un modèle de raisonnement qui expose son raisonnement avant de répondre. JetBrains vise trois cas d’utilisation : agent de travail, assistant de raisonnement général et déploiement privé auto-hébergé.
Mellum2.1 est la dernière version de Mellum2 Thinking, que JetBrains a mis en open source en juin 2026.
Le modèle comporte 28 couches et 64 experts. Un routeur active 8 experts par token. Le mécanisme d’attention utilise une attention par requêtes groupées avec 32 têtes de requête et 4 têtes KV. Trois couches sur quatre utilisent une fenêtre glissante de 1 024 tokens. La longueur du contexte est de 131 072 tokens, et le vocabulaire compte 98 304 tokens. Les poids sont fournis au format bfloat16.
La quasi-totalité du travail a été consacrée à la phase post-entraînement. L’apprentissage par renforcement (RL) est passé d’une brève étape finale à la partie principale de la formation. JetBrains a ajouté des tâches d’apprentissage par renforcement dans les domaines des mathématiques, de la programmation compétitive, des sciences, de l’utilisation d’outils et du génie logiciel. L’entreprise a filtré les jeux de éléments ouverts d’apprentissage par renforcement afin d’éliminer les tests défectueux, les réponses invérifiables et les tâches trop faciles ou impossibles à résoudre. En génie logiciel, le système s’entraîne sur de véritables dépôts à l’aide d’un shell et d’outils d’édition de fichiers. Il est récompensé lorsque les tests sont réussis. La formation a donné lieu à la création de millions de bacs à sable répartis sur des milliers d’environnements.
Précisons, jetBrains a évalué Mellum 2.1, Mellum 2, Qwen 3.5-9B et Gemma 4 E4B à l’aide d’un pipeline en mode « réflexion ». Tous les scores ont été communiqués par JetBrains.
Sur ce point, la plus forte progression concerne le codage agentique. Le score SWE-bench Verified est passé de 2,0 à 47,0. Le score SWE-bench Pro est passé de 0,0 à 28,0. Le score Terminal-Bench 2.1 est passé de 0,6 à 17,4. Les exécutions « agentic » ont utilisé le harnais open source Pi v0.73.1 avec un contexte de 114 000 tokens.
Une affaire qui méritera assurément d’être suivie de près.
À découvrir aussi :
Information publiée en premier lieu par MarkTechPost : MarkTechPost