L’innovation IA ne faiblit pas, comme en témoigne cette nouvelle annonce.
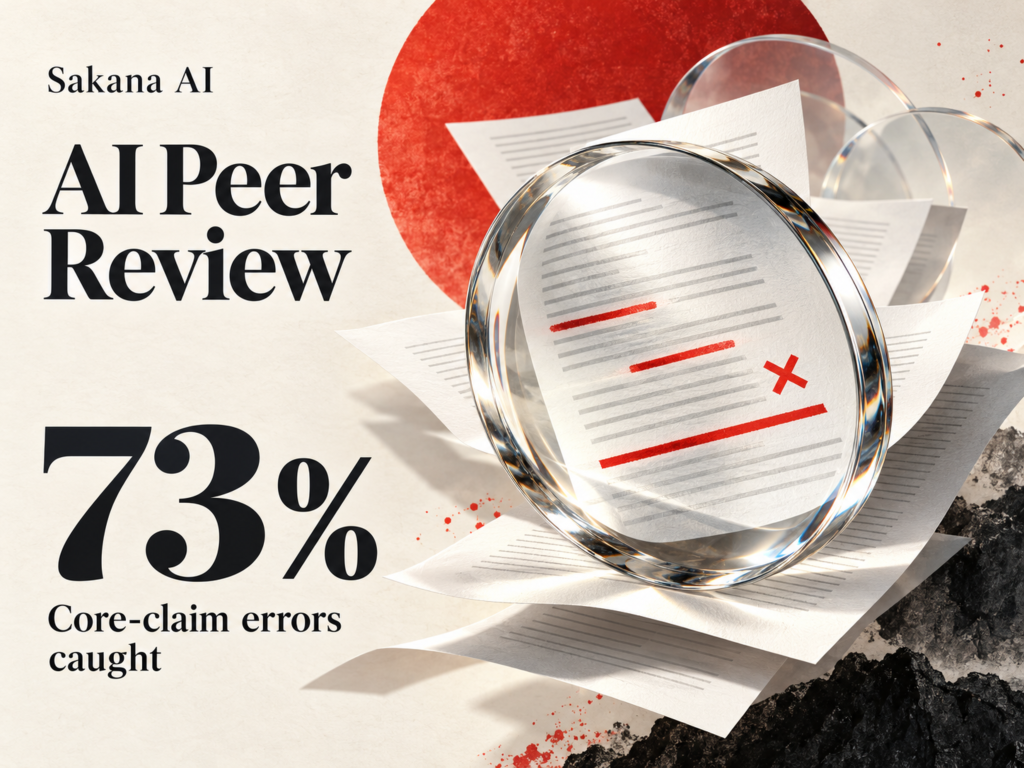
Le mécanisme de révision par les pairs basé sur un modèle de langage (LLM) de Sakana AI détecte 73 % des erreurs dans les revendications principales
Sakana AI a publié « Beyond Imitation », un article de exploration paru dans la revue TMLR consacré à l’évaluation par les pairs assistée par des modèles de langage de grande envergure (LLM) et axée sur la détection d’erreurs. La plupart des relecteurs IA sont évalués en fonction de leur capacité à reproduire fidèlement les relectures humaines. Ce travail pose une question plus difficile : un relecteur IA est-il capable de repérer une erreur délibérément introduite ? L’équipe de recherche propose deux outils : un benchmark de contradiction et un mécanisme de relecture multicouche (MLR). Pour les programmeurs qui créent des agents de recherche, les enseignements à en tirer sont concrets. La conception du dispositif et le choix du modèle influent tous deux sur la détection des erreurs.
Autre élément, « Multi-Layered Review » est un système d’évaluation basé sur l’IA agentique développé par Sakana AI, qui comprend un article de recherche avant de le critiquer. Il utilise trois agents basés sur des modèles Claude prêts à l’emploi :
GPT-4.1 réécrit ensuite 1 nœud par distance pour en faire une contradiction, ce qui donne 1 164 points de informations.
Autre élément, la première étape consiste à rédiger un plan général. La deuxième étape consiste à lire le texte en détail et à signaler les faiblesses, les hypothèses et les lacunes. La troisième étape consiste à regrouper toutes les contributions des agents sous les rubriques « Points forts », « Points faibles », « Questions », « Recommandations », « Note » et « Liste des tâches à effectuer ». Le fichier PDF est transmis tel quel, ce qui rend possible de conserver les figures et les équations.
Précisons, ce test de référence insère des erreurs dans de véritables articles et vérifie si les évaluateurs les repèrent. L’équipe de recherche a rassemblé 257 articles sous licence CC issus des conférences ACL, AISTATS, CVPR et ICML 2025, ainsi que de NeurIPS 2024.
Notons par ailleurs, gemini 2.5 Pro construit un graphe de connaissances à partir des affirmations, des preuves et des méthodes de chaque article. La distance entre un nœud et une « affirmation principale » détermine le niveau de gravité. Une distance égale à 0 correspond à une affirmation centrale ; des distances plus grandes correspondent à des détails. GPT-4.1 réécrit ensuite 1 nœud par distance pour en faire une contradiction, ce qui donne 1 164 points de informations.
Un juge o3 note chaque évaluation à 10 reprises. Sur des documents sans erreur, le système a atteint une précision de 99,9 %. Il a affiché une sensibilité de 86,8 % sur les détections confirmées manuellement ; les scores indiqués peuvent donc être prudents.
Les éléments clés de cette information :
- Ce test de référence insère des erreurs dans de véritables articles et vérifie si les évaluateurs les repèrent.
- Gemini 2.5 Pro construit un graphe de connaissances à partir des affirmations, des preuves et des méthodes de chaque article.
- Sur des documents sans erreur, le système a atteint une précision de 99,9 %.
Difficile à ce stade de prédire tous les impacts de cette annonce.
Pour aller plus loin :
Lire l’article original sur MarkTechPost : MarkTechPost