
Le paysage de l’intelligence artificielle s’enrichit d’une nouveauté significative.
Microsoft open-source TauGrid : une pile native Kubernetes pour les charges de travail d’IA sur GPU
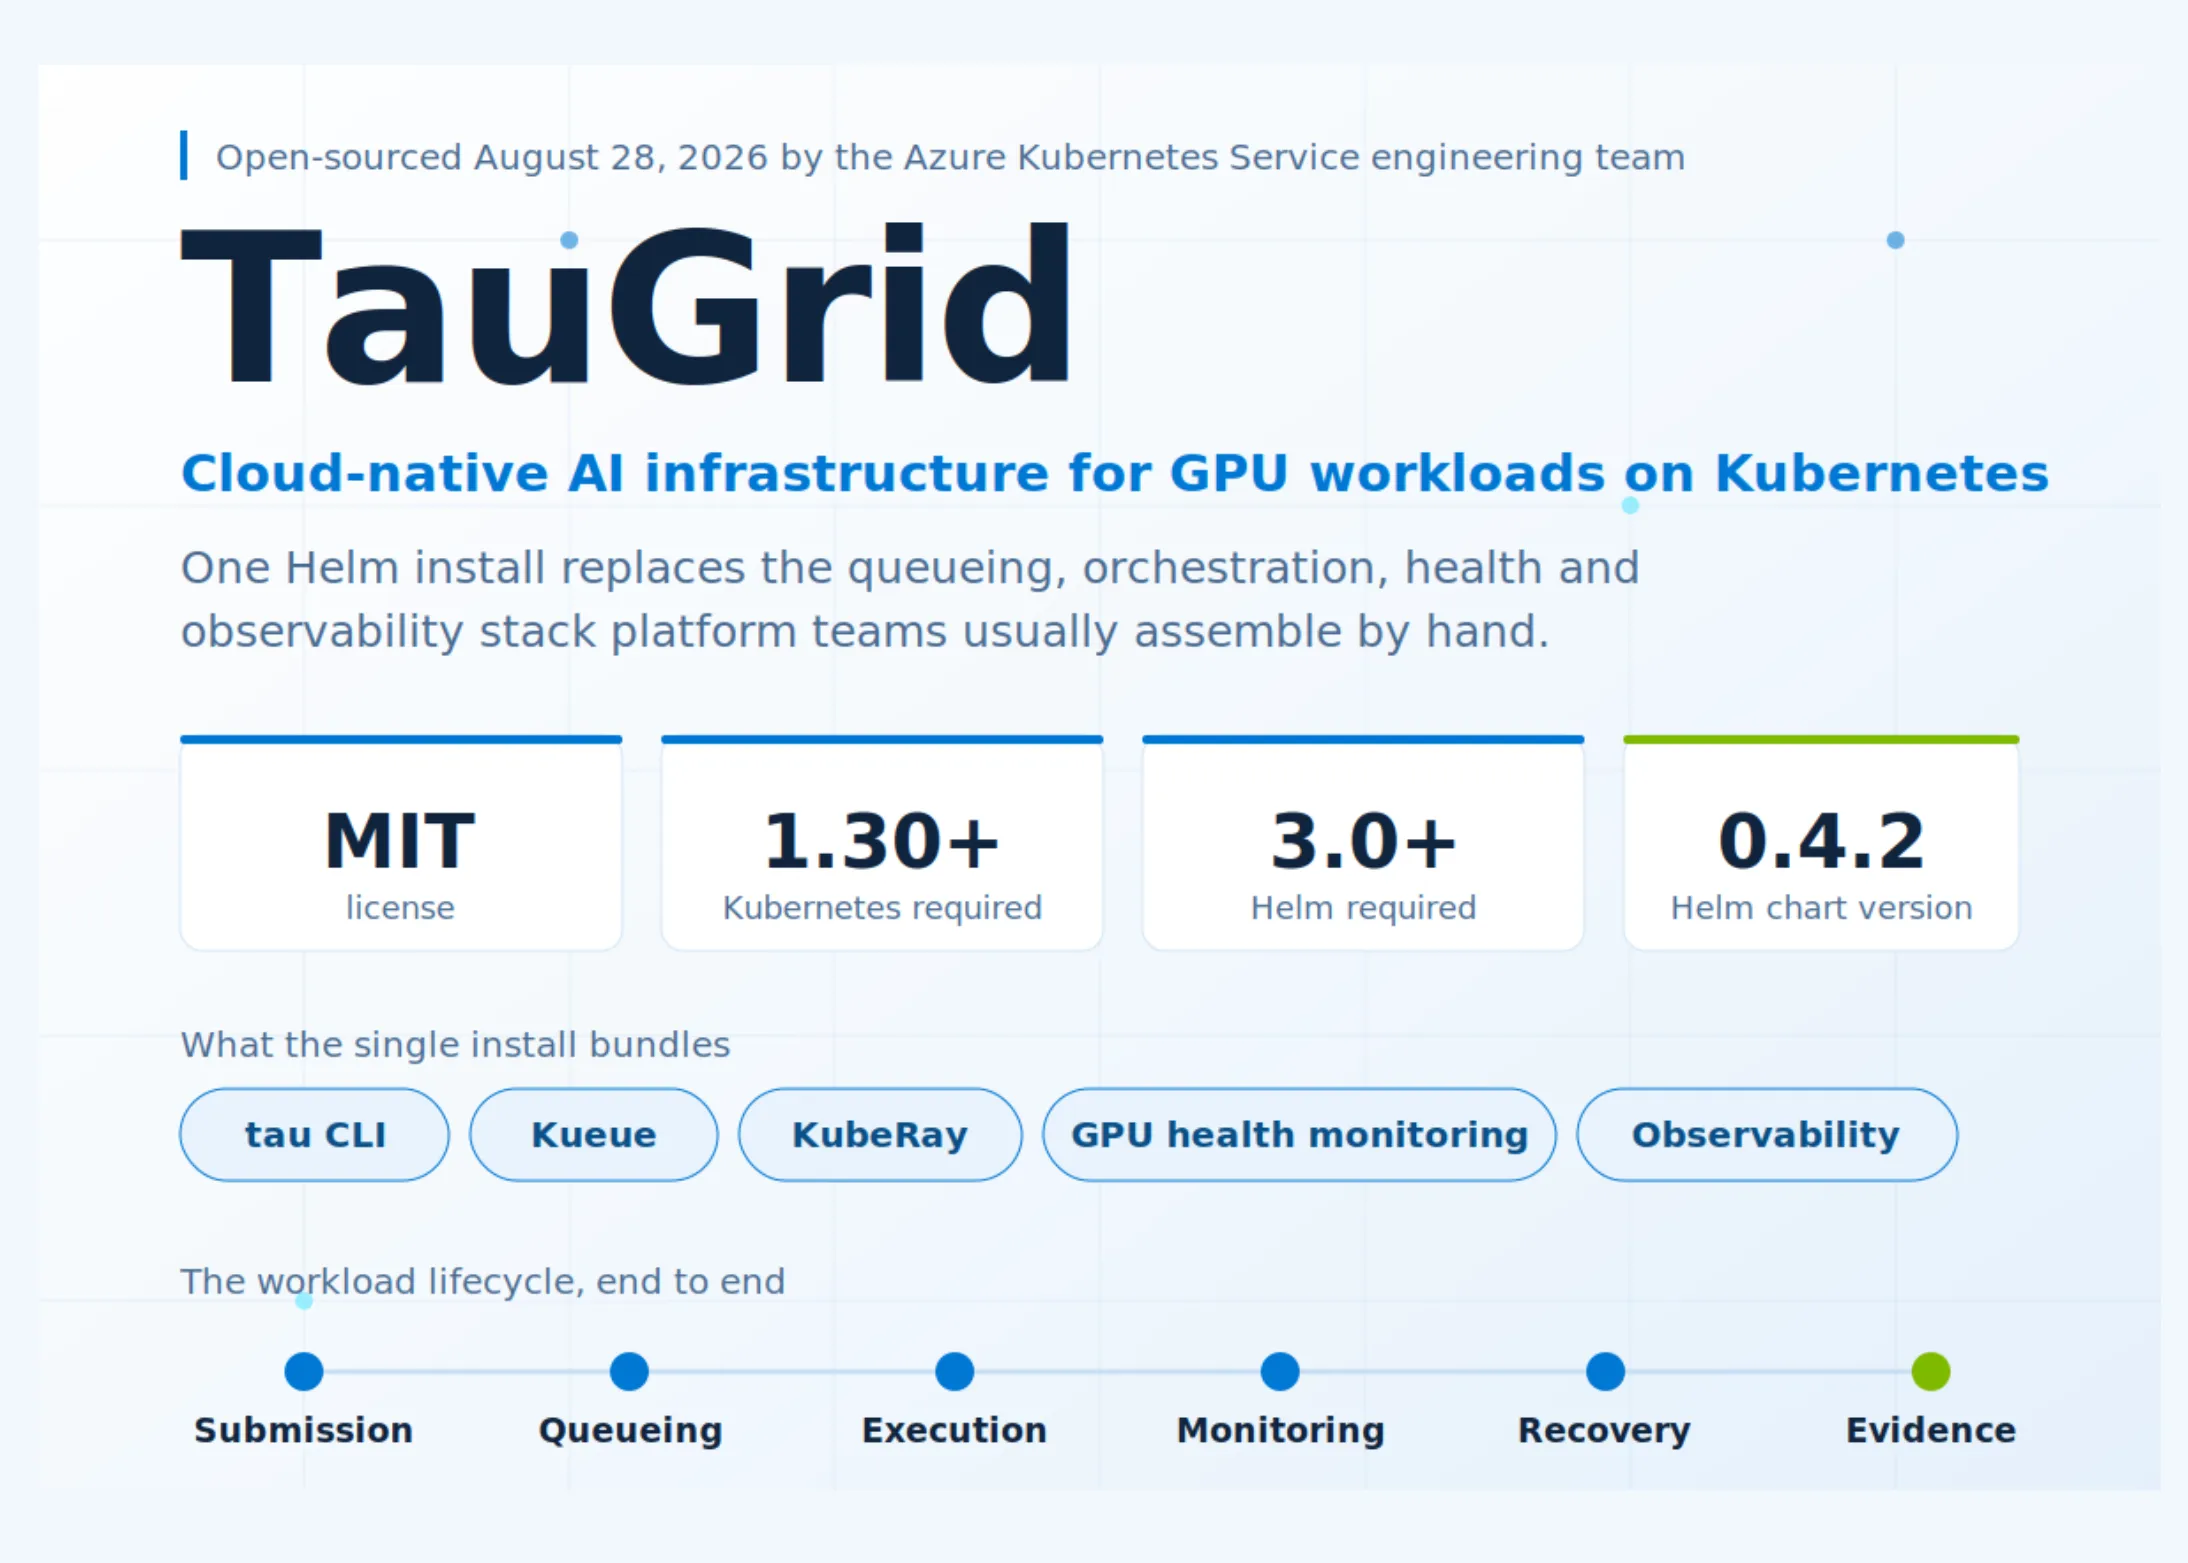
Les équipes de plate-forme qui exploitent l’IA sur Kubernetes ne se contentent généralement pas d’une seule application. Elles gèrent un mécanisme de files d’attente, un environnement d’exécution distribué, des contrôles d’intégrité des nœuds GPU, des tableaux de bord, ainsi qu’une couche de scripts de soumission qui assure la cohésion de l’ensemble. L’équipe d’ingénierie d’Azure Kubernetes Service a open-sourcé TauGrid, qui regroupe toutes ces composantes en une seule installation Helm.
De plus, peut-on le déployer ? Oui, TauGrid est distribué sous licence MIT ; ses images de conteneurs et ses charts Helm sont publiés en tant qu’artefacts OCI publics sur le Microsoft Container Registry. Les prérequis sont un cluster Kubernetes 1.30 ou supérieur doté de nœuds GPU, kubectl et Helm 3.0 ou une version ultérieure.
Les six étapes répertoriées par Microsoft sont les suivantes : soumission, mise en file d’attente, exécution, surveillance, récupération et justification.
TauGrid est une plateforme auto-hébergée permettant d’exécuter des charges de travail d’IA sur Kubernetes. Elle regroupe cinq éléments que les équipes chargées des plateformes intègrent généralement manuellement : thetauCLI, la mise en file d’attente et l’admission des charges de travail via Kueue, l’orchestration des clusters Ray via KubeRay, la surveillance de l’état des GPU au niveau des nœuds, ainsi que l’observabilité des clusters et des charges de travail.
La répartition des responsabilités est au cœur de la conception. Les équipes chargées de la plateforme gèrent les espaces de travail, les files d’attente, les profils de calcul, le stockage, la gestion des identités et l’observabilité. Les chercheurs travaillent à partir d’un référentiel et de l’interface de ligne de commande (CLI), et soumettent leurs charges de travail sans configurer directement Kubernetes. Le code est principalement écrit en Go.
Une charge de travail est décrite dans un fichier .yaml. L’exemple d’entraînement sur GPU publié par Microsoft exécute une tâche PyTorch sur une seule carte A100 :
Sur ce point, lorsqu’Ontau est exécuté, TauGrid détermine la politique de la plateforme, génère un Job Kubernetes ou un RayJob KubeRay, puis le soumet via Kueue. Les six étapes répertoriées par Microsoft sont les suivantes : soumission, mise en file d’attente, exécution, surveillance, récupération et justification. La récupération englobe la nouvelle tentative, la reprise à partir d’un point de contrôle et le diagnostic des défaillances. Les enregistrements de preuves contiennent les métadonnées relatives à la charge de travail, la configuration, les journaux, les métriques, les points de contrôle et l’historique d’exécution, ce qui permet de reproduire une exécution et de la soumettre à un audit ultérieur.
Lorsque plusieurs équipes partagent un cluster, leurs tâches sont placées dans une file d’attente commune, la « ClusterQueue » de Kueue. Kueue accepte chacune d’entre elles en fonction du quota et de la priorité, puis Kubernetes les affecte à des GPU disponibles.
Ce qu’il faut garder à l’esprit :
- L’exemple d’entraînement sur GPU publié par Microsoft exécute une tâche PyTorch sur une seule carte A100 :
- Lorsqu’Ontau est exécuté, TauGrid détermine la politique de la plateforme, génère un Job Kubernetes ou un RayJob KubeRay, puis le soumet via Kueue.
- Kueue accepte chacune d’entre elles en fonction du quota et de la priorité, puis Kubernetes les affecte à des GPU disponibles.
Cette nouvelle étape pose plusieurs questions qui restent ouvertes.
Sur le même sujet :
- Tables rondes : L’IA pourrait-elle vraiment tous nous tuer ?
- L’IA et les centres de données sont extrêmement impopulaires dans tous les sondages
Lire l’article complet sur MarkTechPost : MarkTechPost