Une évolution notable vient d’être rendue publique dans le domaine.
NVIDIA open-source Run:ai sous licence Apache 2.0 pour l’orchestration des GPU sur Kubernetes
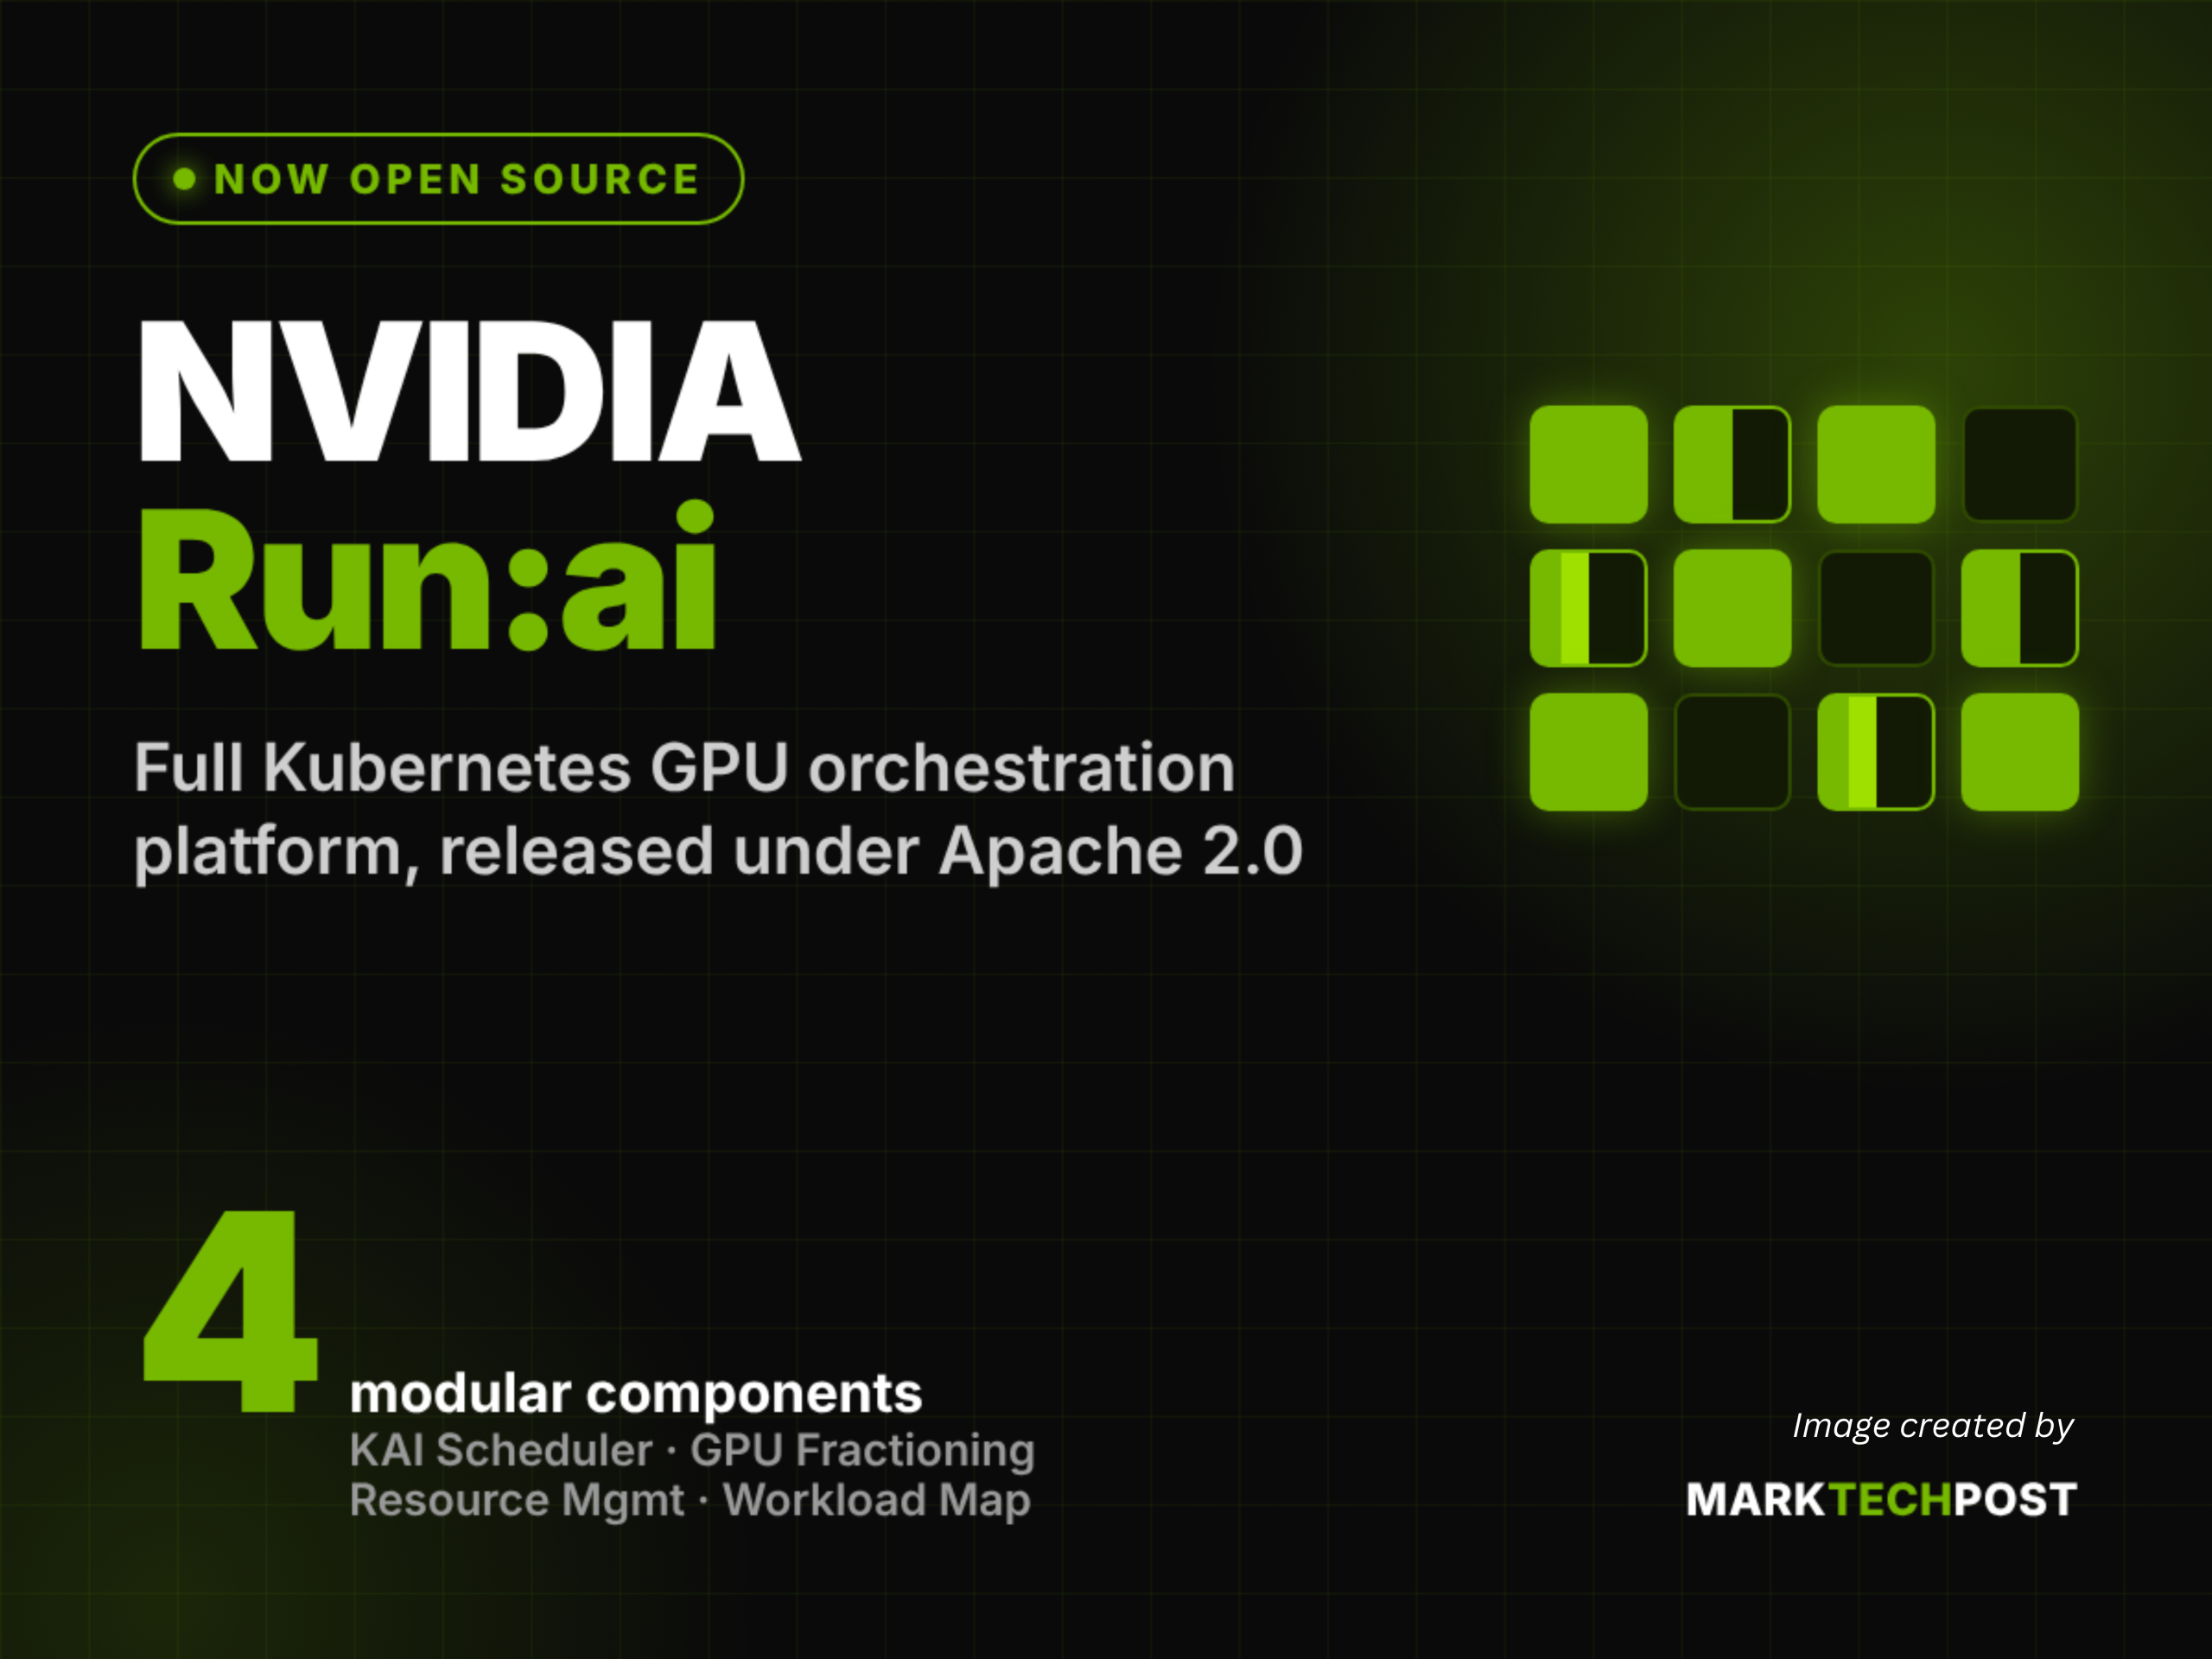
NVIDIA a publié l’intégralité de la plateforme NVIDIA Run:ai en open source. Le code source est disponible sous licence Apache 2.0 sur GitHub. L’open source de NVIDIA Run:ai met entre les mains des développeuses et développeurs les fonctionnalités de planification des GPU en production, de quotas et de gestion des charges de travail. Grâce à cette publication, Run:ai fait désormais partie intégrante de la plateforme NVIDIA DSX AI Factory. Les équipes chargées de la plateforme peuvent désormais examiner, créer des branches et héberger elles-mêmes la pile sans abonnement payant.
NVIDIA Run:ai est une plateforme NVIDIA dédiée à l’orchestration des charges de travail d’IA et des GPU pour Kubernetes. Elle gère la planification des charges de travail de avancée, d’entraînement et d’inférence sur des clusters de GPU partagés. Elle s’exécute sur Kubernetes sans pour autant le remplacer.
En parallèle, le plan de contrôle gère la soumission des charges de travail, la gestion des ressources et la surveillance. Les services de cluster s’exécutent sur chaque cluster Kubernetes et permettent une planification tenant compte des GPU. Les utilisateurs y accèdent via une interface utilisateur Web, une interface de ligne de commande (CLI), une API REST et un serveur MCP destiné aux assistants d’IA.
NVIDIA a divisé cette version en quatre composants que les équipes peuvent adopter séparément :
Le guide de développement local repose sur un seul script, « local-dev.sh ». Il compile environ 50 services Go à partir du code source au sein de conteneurs. Il crée ensuite un cluster Kind à 5 nœuds basé sur Kubernetes v1.32.5. Un faux opérateur GPU simule 8 GPU Tesla-A10, ce qui rend tout matériel GPU superflu.
L’option –gpu-operatorflag permet de basculer vers de véritables GPU NVIDIA. Ce mode nécessite Linux, Docker et le NVIDIA Container Toolkit. Les accélérateurs AMD et Intel ne sont pas pris en charge.
Fait intéressant, les équipes de développement peuvent effectuer le déploiement à partir du code source ou à partir du Helm chart « Community Product » de la NGC. Cette édition ne nécessite aucun abonnement payant, mais ne donne pas droit à l’assistance NVIDIA pour les entreprises.
À retenir de cette annonce :
- Il compile environ 50 services Go à partir du code source au sein de conteneurs.
- Les accélérateurs AMD et Intel ne sont pas pris en charge.
- Cette édition ne nécessite aucun abonnement payant, mais ne donne pas droit à l’assistance NVIDIA pour les entreprises.
Les acteurs concernés devront s’adapter à ce nouveau contexte.
Sur le même sujet :
- NVIDIA lance Nemotron 3.5 Super VL, un modèle d’IA d’agent multimodal ouvert de 120 milliards de paramètres
- Les modèles ouverts présentent de réels avantages. Ces avantages l’emportent-ils sur les risques ?
- Moins de 48 heures avant le début de Disrupt 2026 | TechCrunch
Source originale : MarkTechPost : MarkTechPost