Un nouveau jalon vient d’être franchi dans l’univers de l’intelligence artificielle.
Tsinghua AI met en open source AKV, un serveur d’ingénierie de cache destiné aux agents LLM sur SGLang
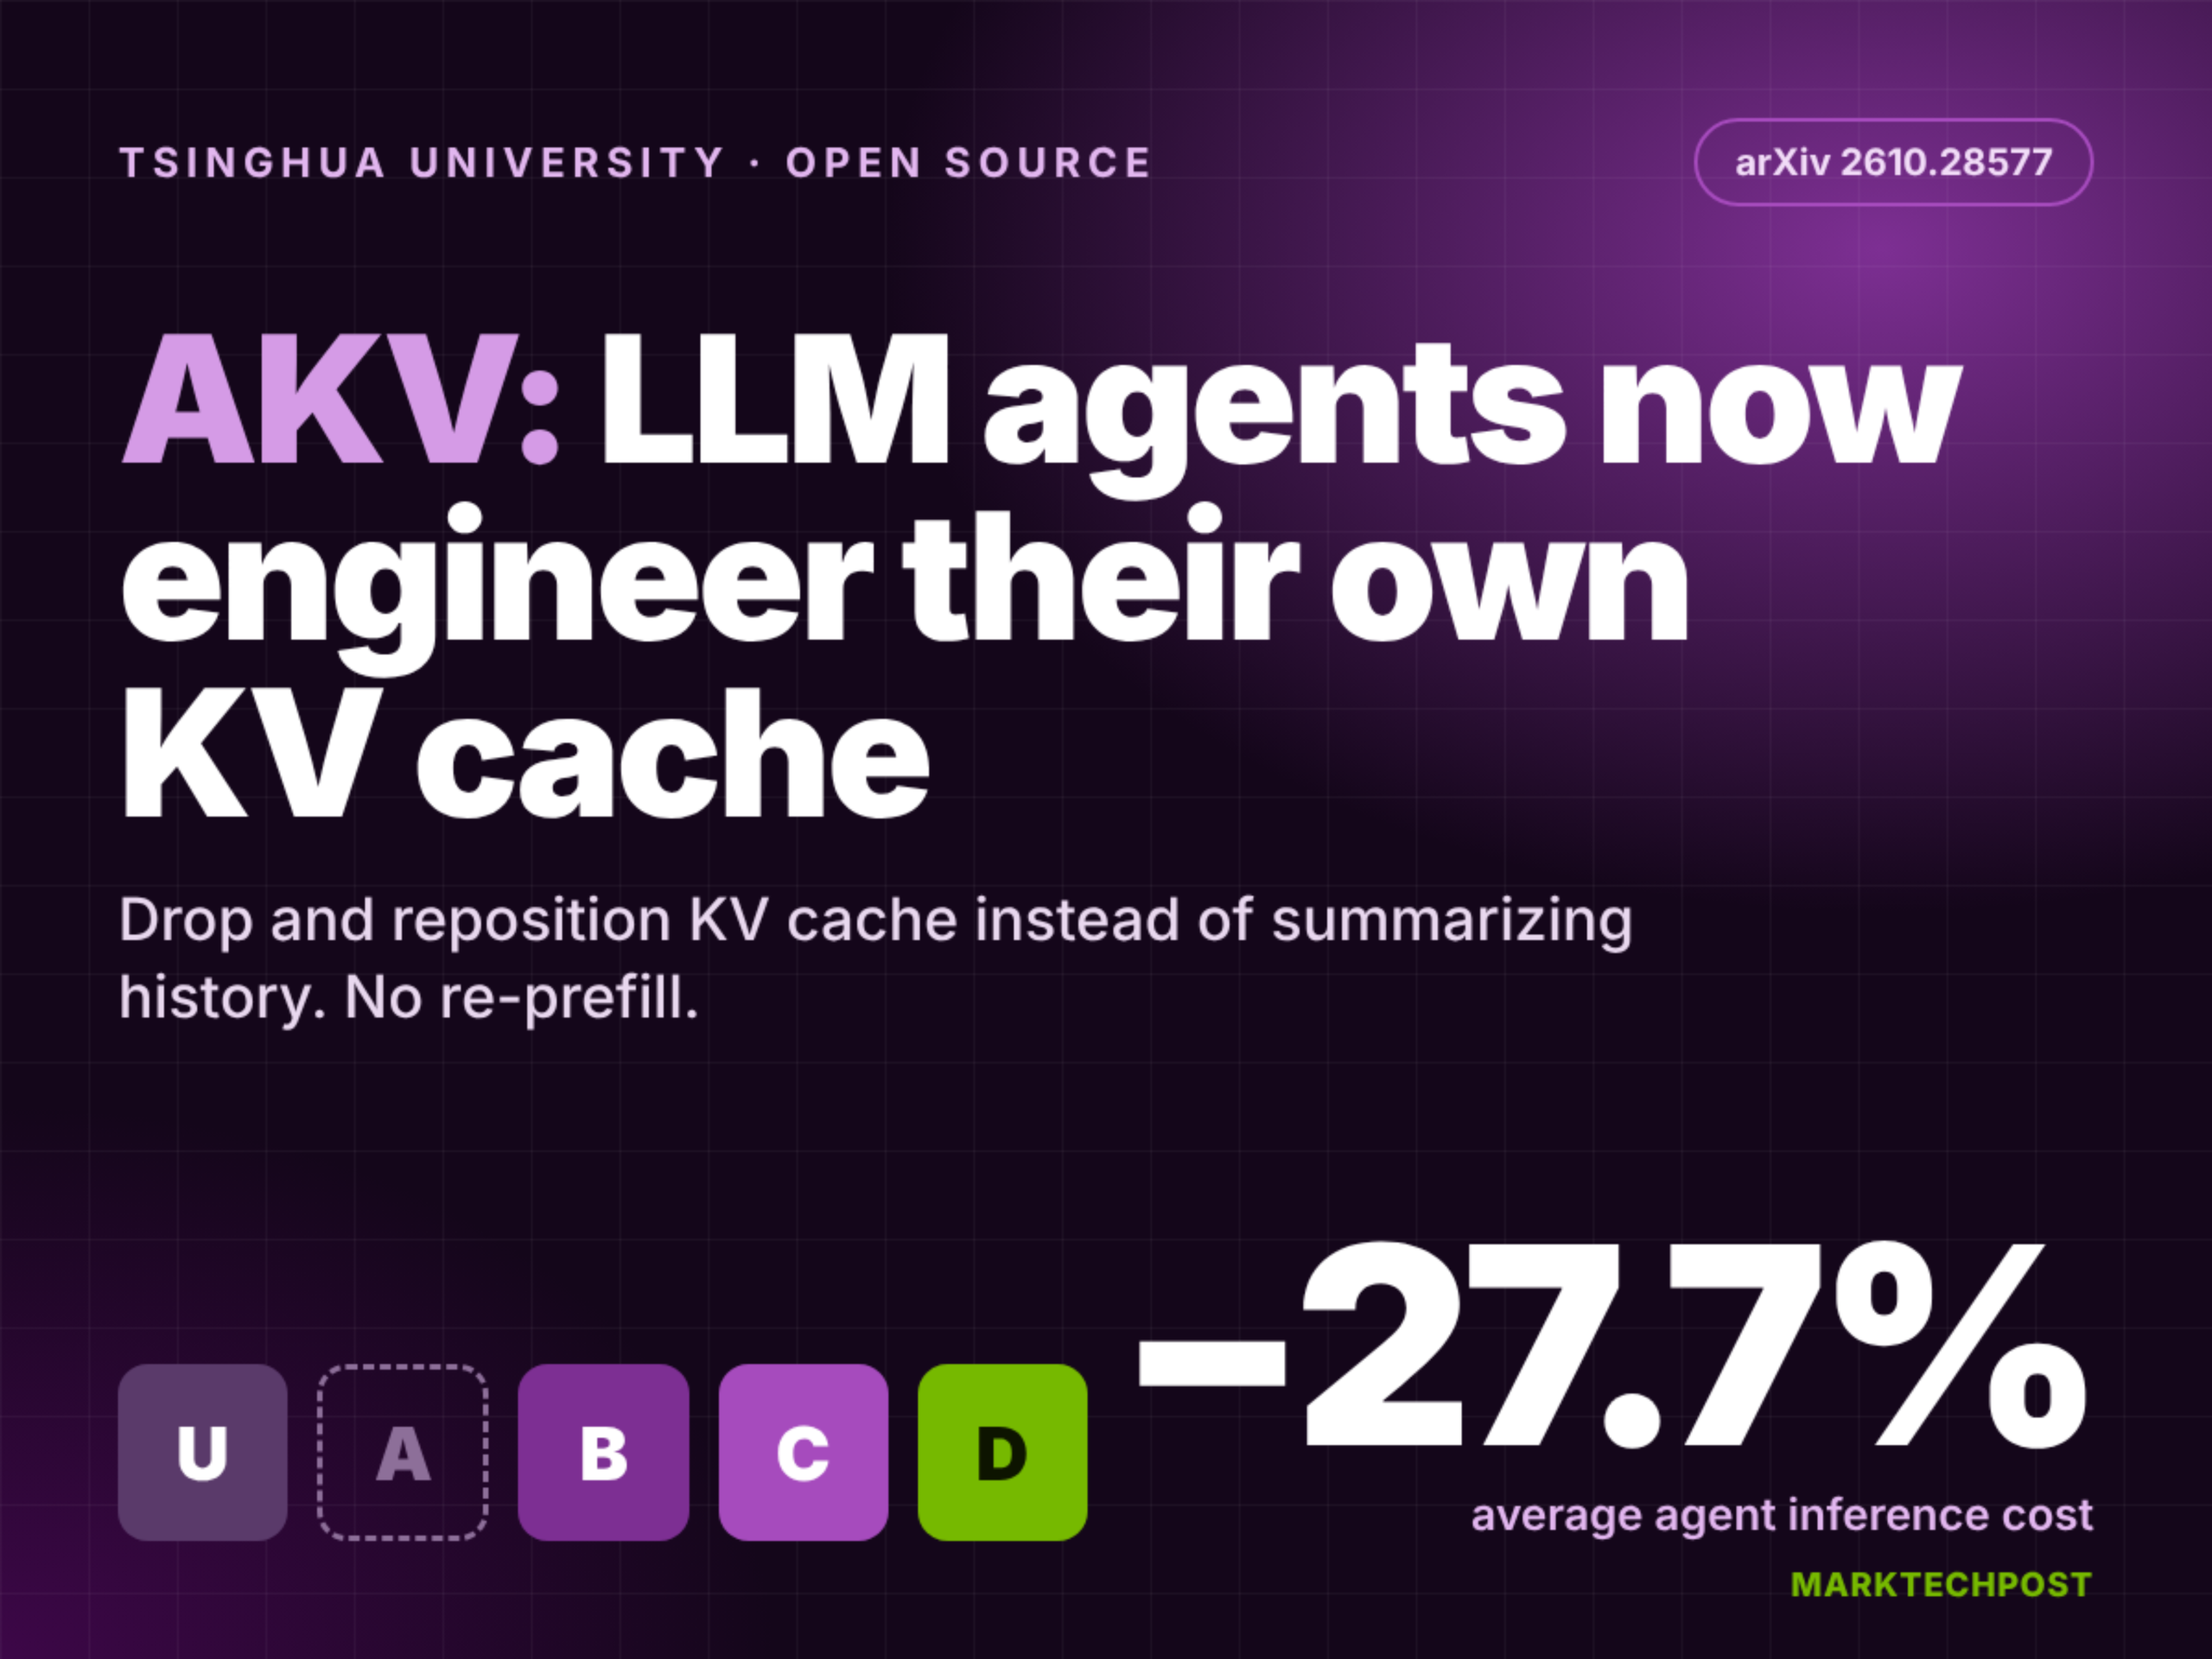
Des scientifiques de l’université de Tsinghua et de l’université chinoise de Hong Kong (CUHK) ont mis en open source AKV, un système de mise à disposition destiné à l’ingénierie du cache clé-valeur (KV) dans les agents LLM. Au lieu de résumer l’historique antérieur, les agents suppriment certaines entrées du cache KV et continuent de réutiliser les autres. Sur trois modèles et quatre tests de performance d’agents, le coût moyen diminue de 27,7 %. Le score moyen des tâches augmente de 1,7 point. Le code est sous licence Apache 2.0 et s’appuie sur SGLang.
À noter également, aKV est un système de service Tsinghua qui permet aux agents LLM de supprimer et de repositionner leur propre cache clé-valeur.
L’ingénierie de la mémoire cache ne modifie en rien la trajectoire du texte.
L’ingénierie contextuelle raccourcit ou résume l’historique du texte. La modification de ce préfixe invalide tous les états KV ultérieurs. Le suffixe conservé doit alors être à nouveau prérempli. Les harnais procèdent donc à un résumé tardif et radical, ce qui peut entraîner la perte de détails issus des itérations intermédiaires.
L’ingénierie de la mémoire cache ne modifie en rien la trajectoire du texte. Elle ne fait que déterminer quelles entrées clé-valeur restent visibles pour l’attention. Les entrées conservées sont réutilisées sans être recalculées. Elles peuvent toujours contenir des informations provenant de messages supprimés. Dans l’analyse des coûts présentée dans l’article de recherche, les lectures de la mémoire cache clé-valeur représentaient 82,4 % du coût total de l’API.
AKV définit trois opérations de cache. « Append » ajoute la mise à jour standard pour les nouveaux jetons. « Drop » supprime les entrées sélectionnées de l’attention future sans modifier leur position. « Repos » réécrit les clés conservées aux positions 0 à r-1 à l’aide d’une rotation RoPE. Les valeurs restent inchangées, de sorte qu’aucun état caché n’est recalculé. Lors des tests d’ablation, l’ajout de « Repos » a fait passer le taux de réussite de GPT-OSS-120B au test « BrowseComp-Plus » de 55 % à 62 %.
Le plus difficile, c’est la mise à disposition. Des jetons identiques peuvent donner lieu à des états de cache différents selon l’historique des opérations. Une simple correspondance de préfixes pourrait entraîner la réutilisation d’états erronés. AKV étend l’arbre radix de SGLang avec des nœuds de suppression et de repositionnement. Il ne libère les paires clé-valeur supprimées que lorsqu’aucune requête active n’en a plus besoin. L’attention par segments et par lots rétablit les états supprimés en un seul passage de préremplissage.
L’interface est sans état et compatible avec OpenAI. Les clients envoient l’historique complet des messages ainsi que deux champs facultatifs. Le champ `drop_message` associe un index de message déclencheur aux messages à supprimer. Le champ `reposition` répertorie les indices à partir desquels les positions sont compactées.
Une politique de cache (ACachePolicy) construit ces champs à partir d’un déclencheur, d’un sélecteur et d’une règle de repositionnement. Les politiques intégrées sont de type « au tour par tour », « basées sur des jetons » ou « basées sur un modèle ». ACacheTool permet au modèle d’IA d’appeler lui-même la fonction `drop_context`.
L’avenir dira si cette annonce tient toutes ses promesses.
À découvrir aussi :
- Sécurisation de notre environnement d’entraînement au système « Frontier »
- Grok dévoile les sept premières minutes de son film « Odyssey », généré par IA | TechCrunch
Source originale : MarkTechPost : MarkTechPost