
Nouvelle information marquante dans l’actualité IA.
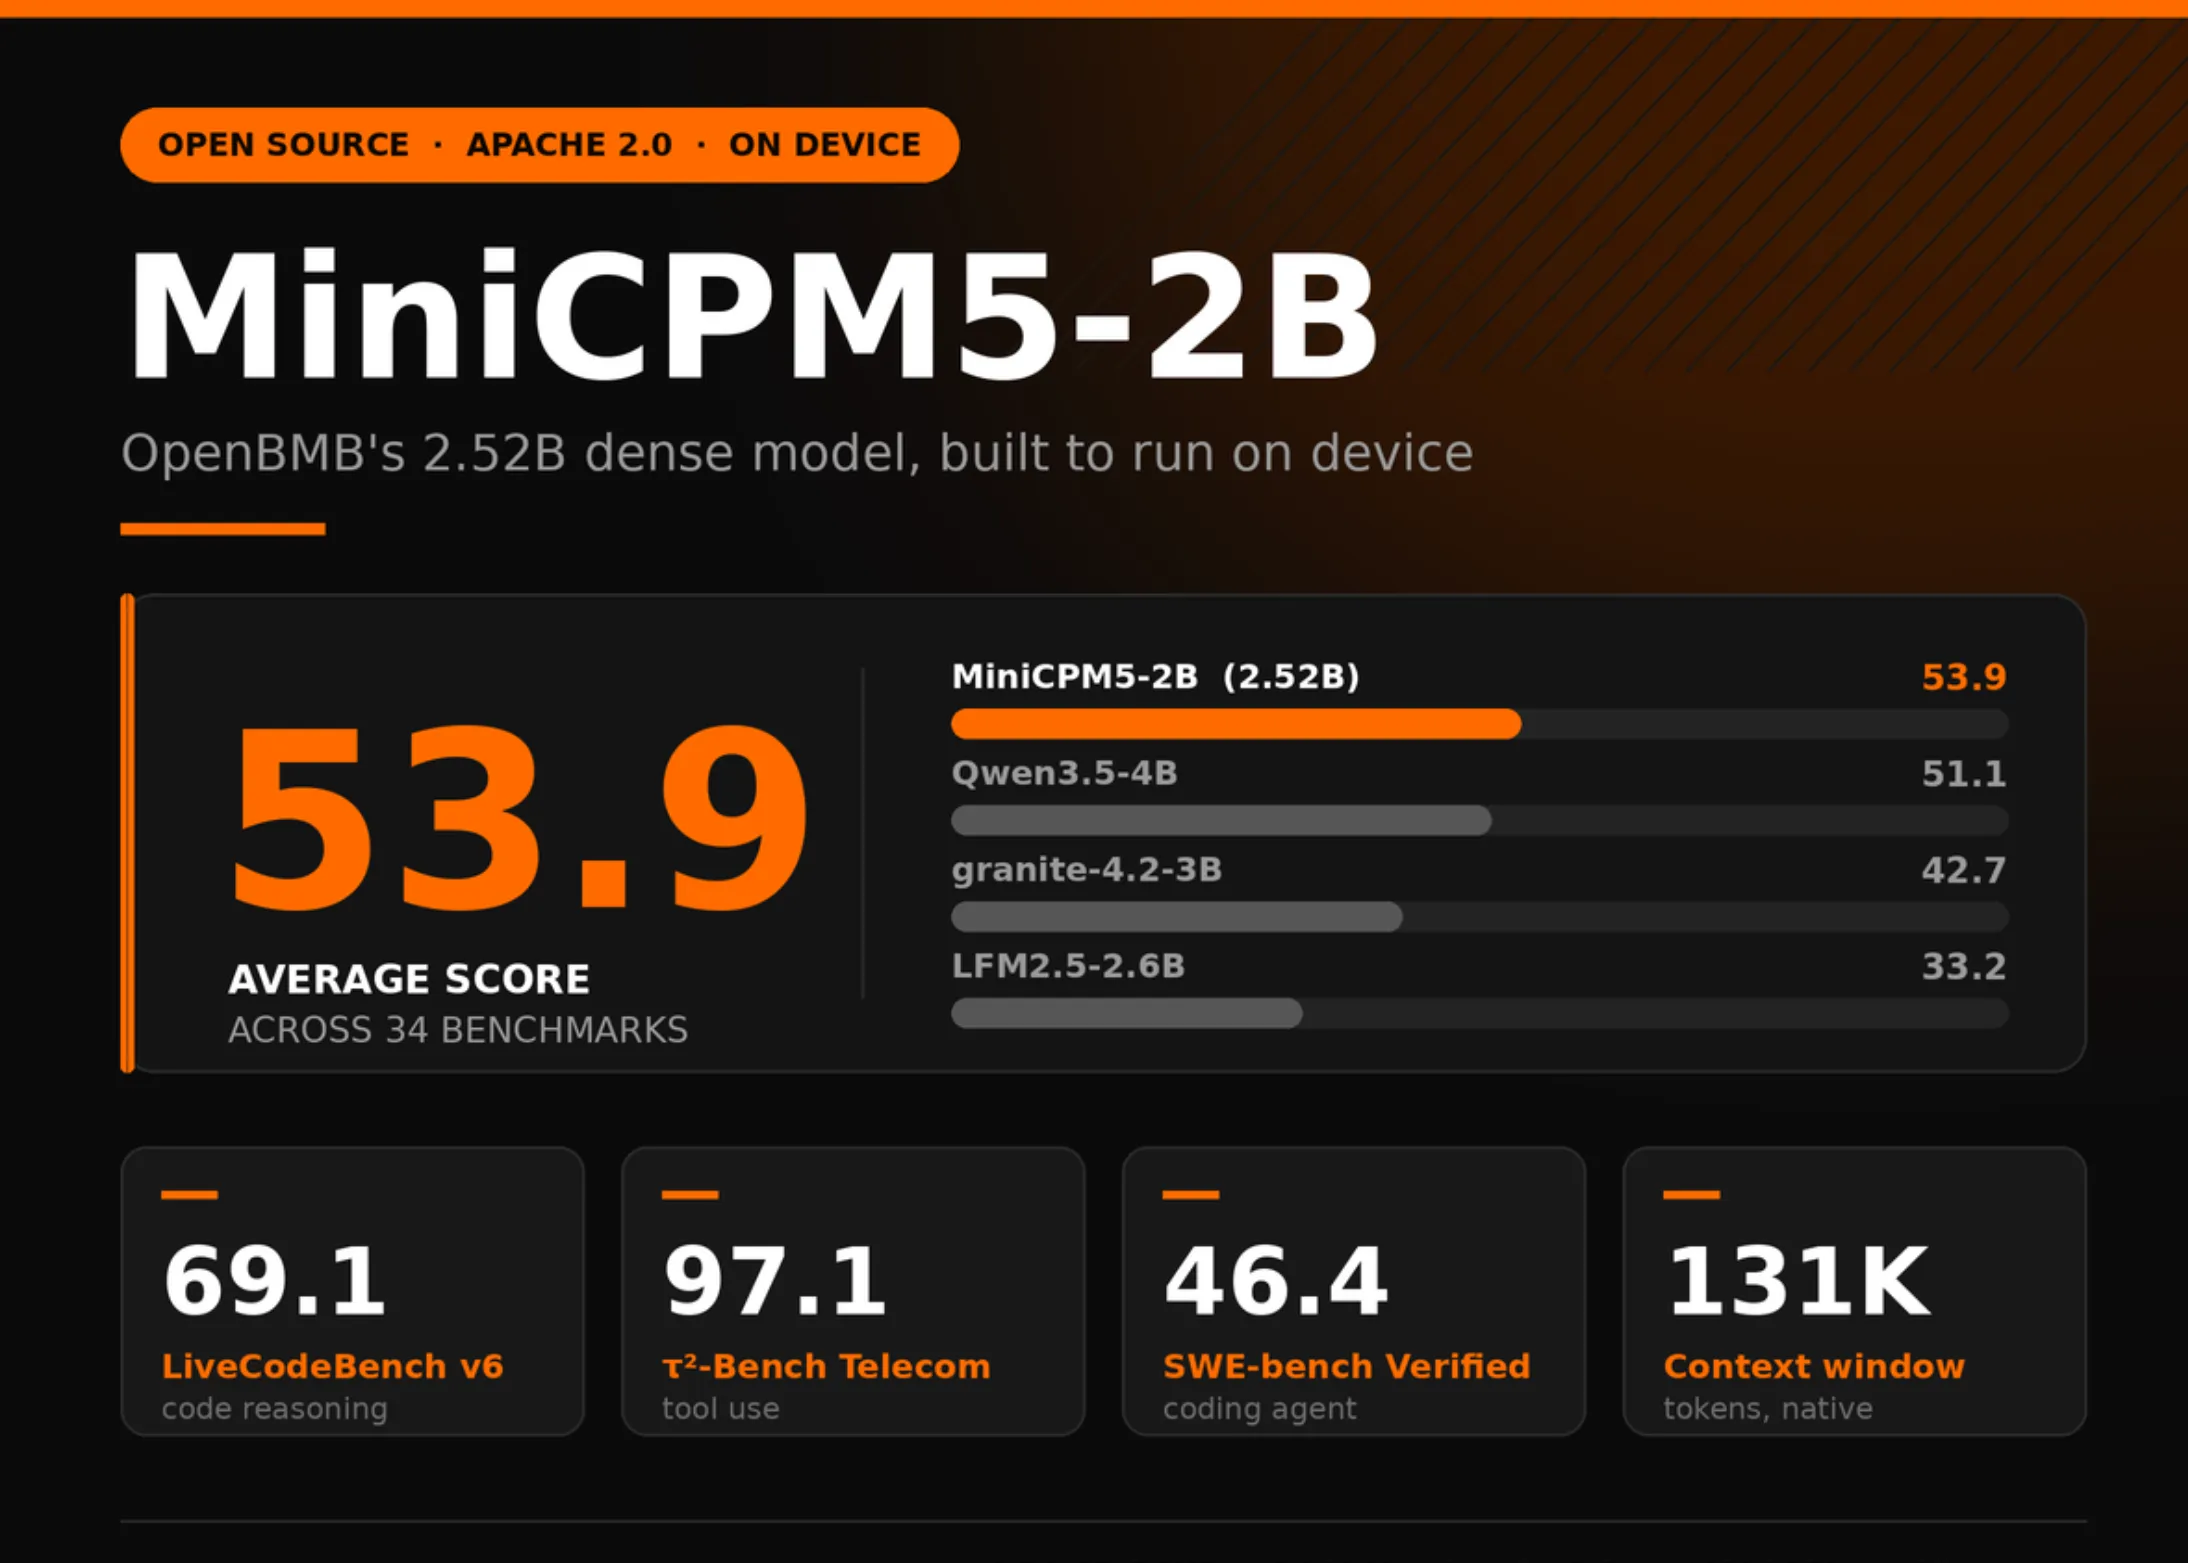
OpenBMB lance le MiniCPM5-2B : un modèle dense de 2,52 milliards de paramètres, obtenant une note moyenne de 53,9 sur 34 benchmarks et conçu pour fonctionner sur appareil
OpenBMB a publié MiniCPM5-2B, le deuxième point de contrôle de la série MiniCPM5 et la suite de MiniCPM5-1B. Il s’agit d’un modèle linguistique causal dense comptant 2 516 756 480 paramètres, dont 1 981 982 720 se situent en dehors des embeddings. Il utilise 42 couches, un mécanisme d’attention par requêtes groupées avec 16 têtes de requête et 2 têtes clé/valeur, de cette manière qu’une fenêtre de contexte native de 131 072 tokens. L’architecture est de type standardLlamaForCausalLM ; les moteurs courants peuvent donc la charger sans noyaux personnalisés ni dérivation du code du modèle.
Dans le même temps, est-ce déployable ? Oui. Les modèles sont sous licence Apache 2.0 et fonctionnent avec vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX et FlagOS.
OpenBMB compare MiniCPM5-2B à LFM2.5-2.6B, Qwen3.5-2B et Gemma-4-E2B-it, qui appartiennent à la même classe de taille, et cite à titre de référence Qwen3.5-4B, granite-4.2-3B, Nemotron-3-Nano-4B, Gemma-4-E4B-it et LFM2.5-8B-A1B à titre de référence. Sur les 34 lignes du benchmark, la moyenne s’établit à 53,9. La meilleure référence de cet ensemble est le Qwen3.5-4B avec 51,1, suivi du granite-4.2-3B avec 42,7 et du LFM2.5-2.6B avec 33,2.
En matière de raisonnement sur le code, le MiniCPM5-2B affiche un score de 69,1 sur LiveCodeBench v6 contre 56,4, et de 46,4 sur SWE-bench Verified contre 33,6. C’est dans l’utilisation des outils que l’écart est le plus important : 97,1 sur τ²-Bench Telecom, 66,6 sur BFCL v4 et 20,8 sur τ³-Bench Banking contre 6,8. Le contexte long est mitigé, avec 68,1 sur NoLiMa contre 43,5, mais 59,0 sur AA-LCR contre 61,0 et 43,7 sur LongBench v2 contre 47,3. C’est dans le domaine des connaissances générales que l’écart de taille se fait le plus sentir : 70,8 au MMLU-Pro contre 78,0, et 8,9 à l’« Humanity’s Last Exam » contre 9,9. OpenBMB distingue les lignes issues d’Artificial Analysis de celles reproduites en interne.
L’entraînement suit la méthode de gestion des éléments par niveaux UltraData décrite dans les travaux de exploration originaux. L’entraînement de base comprend des phases stables et de décroissance, puis l’entraînement intermédiaire adapte le modèle d’IA à la distribution des éléments cibles. L’entraînement postérieur commence par 400 milliards de tokens de SFT à réflexion profonde, puis forme des enseignants RL spécialisés en mathématiques, en programmation, en tâches agentiques et en écriture à l’aide de l’algorithme JustRL II basé sur un critique.
La dernière étape est la distillation « on-policy ». L’OPD fusionne 16 experts d’apprentissage par renforcement, dont cinq de type « agentic », en un seul modèle final. À chaque position de réponse, elle calcule la divergence KL inverse sur l’ensemble du vocabulaire entre les logits de l’élève et ceux du professeur pour obtenir l’estimation de l’avantage, remplaçant ainsi l’avantage basé sur la vérification. Il réutilise les prompts de l’apprentissage par renforcement (RL) comme données de distillation, ce qui évite de créer un nouveau corpus. OpenBMB attribue à l’étape combinant RL et OPD une note moyenne de 10,96 points pour les benchmarks de raisonnement et généraux, et de 6,96 points pour les benchmarks « agentiques ».
Parallèlement aux poids, OpenBMB a publié Ultra-FineWeb, Ultra-FineWeb-L3, UltraX, UltraData-Code, UltraData-Math, UltraData-SFT-2605, UltraData-SFT-Agent-2609 avec 500 000 échantillons d’agents, et UltraData-RL-2609 avec plus de 80 000 échantillons d’apprentissage par renforcement. Des points de contrôle intermédiaires sont également publiés, couvrant les phases « Base », « Midtrain » et « SFT uniquement », ce qui autorise de mesurer directement la contribution de chaque étape.
Les mois à venir apporteront sans doute plus de précisions.
Pour aller plus loin :
- Meta FAIR présente les modèles de préférences en matière de recherche sur l’IA (RPM) : classer les expériences d’apprentissage automatique avant d’allouer des heures de GPU
- Google lance Gemini 3.8 Flash, son troisième modèle Flash en six semaines
D’après MarkTechPost : MarkTechPost