
Nouvelle information marquante dans l’actualité IA.
Alibaba Qwen lance Qwen-Audio-3.1-Realtime : un modèle vocal en duplex intégral entraîné à réfléchir, agir et décider quand parler
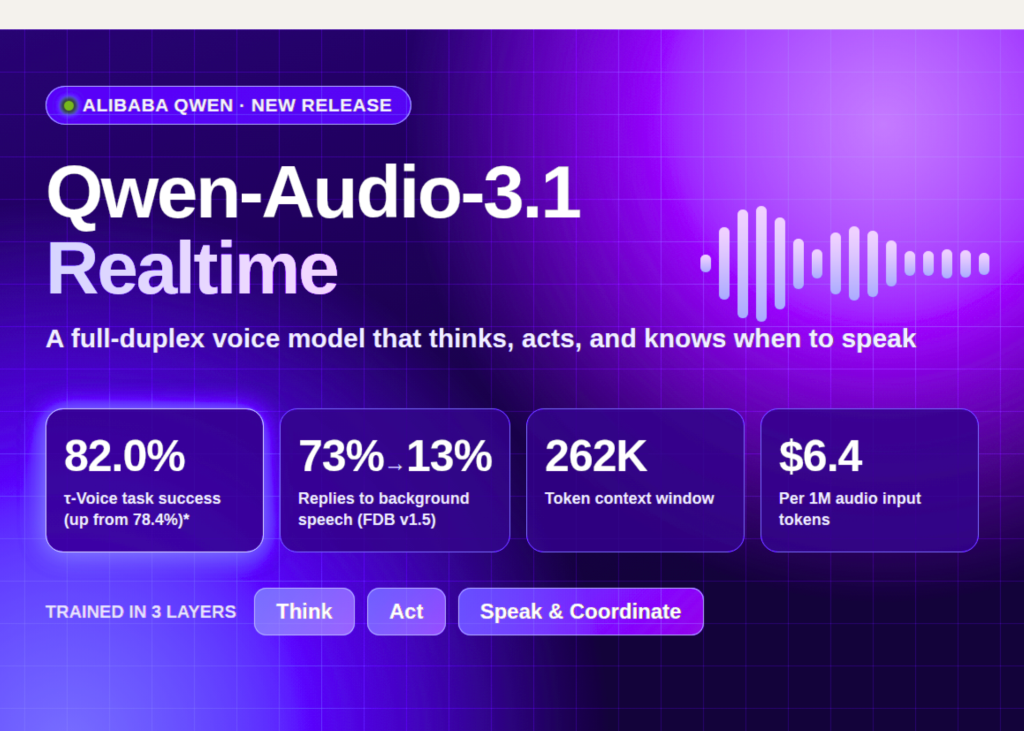
L’équipe Qwen d’Alibaba a lancé Qwen-Audio-3.1, une pile audio composée de cinq modèles couvrant la reconnaissance vocale (ASR), la synthèse vocale (TTS) et l’interaction en temps réel. Le modèle principal est Qwen-Audio-3.1-Realtime, un modèle vocal en duplex intégral conçu pour les assistants vocaux qui appellent des outils. Qwen a également réduit ses tarifs : d’environ 85 % pour Realtime, d’environ 70 % pour TTS et jusqu’à 95 % pour ASR.
Est-ce déployable ? Oui, sous forme d’API gérée. « qwen-audio-3.1-realtime-plus » est proposé sur QwenCloud via WebSocket. Aucun coût n’a été annoncé.
La page du modèle mentionne le texte et l’audio comme formats d’entrée et de sortie. Le contexte est de 262 000 tokens, avec un maximum de 245 000 tokens en entrée et 16 000 tokens en sortie. Les limites par défaut sont de 60 requêtes et 100 000 tokens par minute. La tarification est de 6,4 $ par million de tokens audio en entrée et de 0,8 $ par million de tokens texte en entrée. La sortie texte et audio coûte 24 $ par million de tokens, la sortie texte n’étant pas facturée. Les principales fonctionnalités comprennent l’appel de fonctions, la recherche sur le Web, les sorties structurées, le cache de contexte et le réglage fin.
Un modèle complémentaire, Qwen-Audio-3.1-ASR-Flash-Filetrans, est destiné à la transcription hors ligne d’enregistrements audio longs. Il prend en charge les mots-clés, la séparation des locuteurs, la ponctuation ainsi que la reconnaissance multilingue et des dialectes chinois. Son coût s’élève à 0,15 $ pour l’entrée et à 0,47 $ pour la sortie par million de tokens.
Le mécanisme utilise deux modèles dotés du même encodeur audio et de la même architecture LLM. Un modèle de décision en duplex intégral prédit s’il faut continuer à écouter, parler, s’arrêter ou reprendre. Un modèle d’IA de reconnaissance vocale transcrit le contenu de la réponse sous forme de texte. Un moteur de synthèse vocale contextuel transforme ensuite ce texte en flux vocal. Il tient compte de l’historique de la conversation, des indices vocaux et du contexte acoustique.
D’un autre côté, la formation s’articule autour de trois axes : « Réfléchir », « Agir » et « Communiquer et coordonner ».
Core-Cocktail SFT réancre le modèle audio à son LLM de texte source à l’aide de données appariées à l’échelle de millions d’heures. Vient ensuite l’OPD multimodal. Un « Text Teacher » et une « Audio Reference » figée attribuent une note à chaque token de la trajectoire propre à l’élève. Il s’agit d’une distillation « ison-policy », et non d’une imitation de réponses pré-rédigées. Des experts spécialisés dans l’empathie, l’intention pragmatique et les scènes acoustiques sont ensuite formés à l’aide de GRPO. L’OPD « Multi-Teacher » les fusionne en un seul modèle d’IA prêt à être déployé.
Sur ce point, chaque domaine de formation regroupe un ensemble d’outils, une base de données JSON à état et une politique métier en langage naturel. Les domaines sont alimentés à partir de définitions d’outils open source et de serveurs MCP. Chaque tâche définit l’un des trois résultats suivants : une écriture, un refus justifié ou une requête non prise en charge. L’évaluation vérifie d’abord l’état final, puis les écritures autorisées, puis les assertions comportementales. Une réponse fluide ne peut pas compenser un contrôle d’état qui a échoué.
Ce qu’il faut garder à l’esprit :
- La formation s’articule autour de trois axes : « Réfléchir », « Agir » et « Communiquer et coordonner ».
- Un « Text Teacher » et une « Audio Reference » figée attribuent une note à chaque token de la trajectoire propre à l’élève.
- L’évaluation vérifie d’abord l’état final, puis les écritures autorisées, puis les assertions comportementales.
Le chapitre n’est pas clos, loin de là.
À découvrir aussi :
Lire l’article original sur MarkTechPost : MarkTechPost