
L’industrie de l’IA poursuit sa transformation rapide avec cette nouvelle annonce.
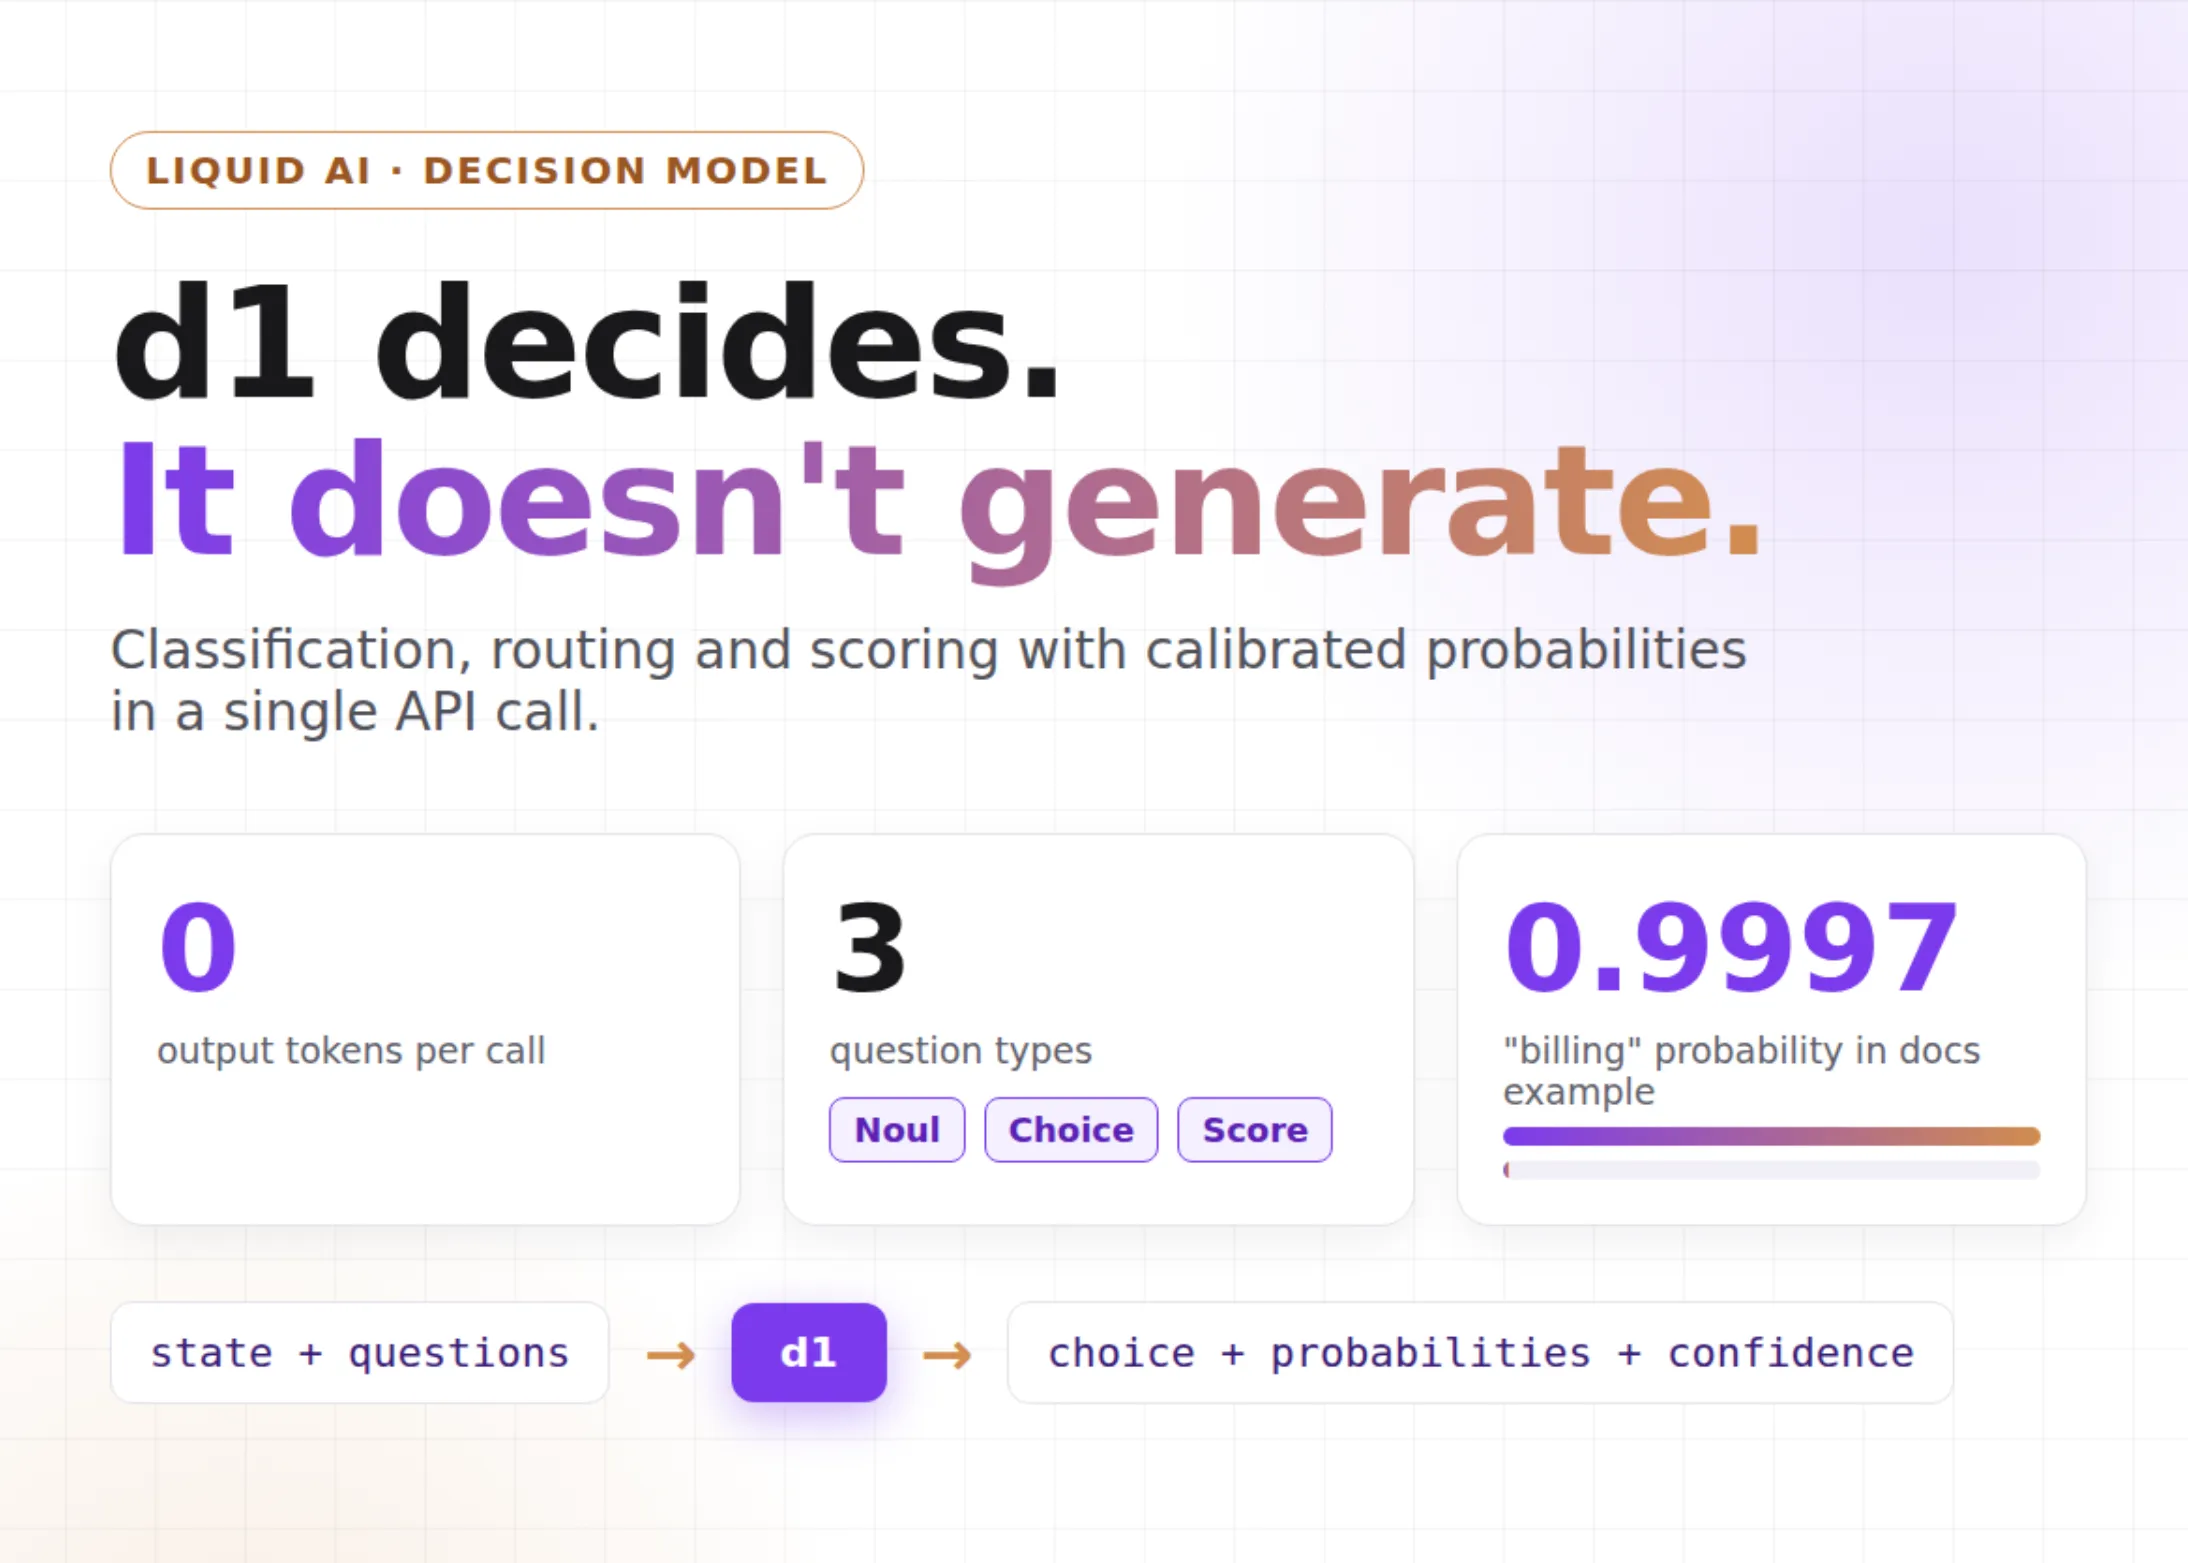
Liquid AI lance « d1 » : un modèle décisionnel qui renvoie des probabilités calibrées sans générer de tokens de sortie
Liquid AI a lancé « d1 », un système décisionnel conçu pour les choix structurés plutôt que pour la génération de texte.Il suffit de lui fournir un contexte et un ensemble de questions formulées par écrit. En un seul appel, il renvoie des probabilités calibrées pour un ensemble fixe de résultats, sans générer le moindre token. Il vise à prendre en charge les tâches que de nombreuses équipes confient encore aux grands modèles de langage (LLM) généraux : classification, acheminement des tickets, notation, modération, reclassement et vérifications par un LLM agissant en tant que juge.
Peut-on le déployer ? Oui, dès aujourd’hui, sous forme d’API hébergée. d1 fonctionne sur l’API Liquid selon le modèle « 1:free ». La bibliothèque de modèles de Liquid le répertorie comme une API uniquement, non entraînable ; il n’y a donc pas de poids GGUF, MLX ou ONNX à héberger soi-même.
Le guide de migration répertorie les différences concrètes par rapport à un LLM générant des résultats structurés :
Point notable, un système de décision évalue une situation et renvoie une réponse typée parmi les options que vous définissez avant l’appel. Il ne rédige pas de texte. Dans chaque réponse, usage.output_tokensis vaut 0. Le guide de migration de Liquid AI propose une règle simple : si la réponse est l’une des N options connues, utilisez un modèle de décision. Si le modèle d’IA doit composer une récente chaîne de caractères, conservez votre LLM.
Vous pouvez combiner ces trois types dans une seule requête. Le système évalue chaque question par rapport au même état en un seul aller-retour.
Notons par ailleurs, chaque requête comporte trois parties : le modèle, l’état (texte brut ou objet JSON) et les questions. Les appels sont envoyés via une requête POST à l’adresse https://api.liquid.ai/decisions/v1/systemone. Les clés proviennent de console.liquid.ai et commencent par liquid_. Les clients sont le typesafe-sdk de TypeSafe AI pour Python et @typesafe-ai/sdk pour TypeScript.
Dans le même temps, le guide de migration répertorie les différences concrètes par rapport à un LLM générant des résultats structurés :
À noter également, les probabilités rendent les seuils exploitables. Dans l’exemple de modération de Liquid, les valeurs supérieures à 0,8 sont bloquées, celles inférieures à 0,2 sont autorisées et les valeurs situées dans la fourchette intermédiaire sont soumises à une vérification humaine. Dans l’exemple de routage, le système se rabat sur le niveau de modèle le plus performant lorsque le niveau de confiance du routeur passe en dessous de 0,5. Liquid indique également que les évaluations répétées d’une même entrée sont plus cohérentes, ce qui réduit les revirements de verdict.
L’évolution de ce dossier sera à suivre avec attention.
Sur le même sujet :
- Trump ordonne au gouvernement américain d’appeler l’IA « super-intelligence »
- America.gov se comporte de manière vraiment bizarre quand on lui pose des questions sur Minecraft, toutefois ce n’est pas un bug | TechCrunch
- Présentation de GPT-6.1 Sol
Via MarkTechPost : MarkTechPost