Voici une information qui pourrait bien avoir un impact durable sur le secteur.
Nanbeige lance Nanbeige4.3-33B, un modèle de codage agentique ouvert de type 33B
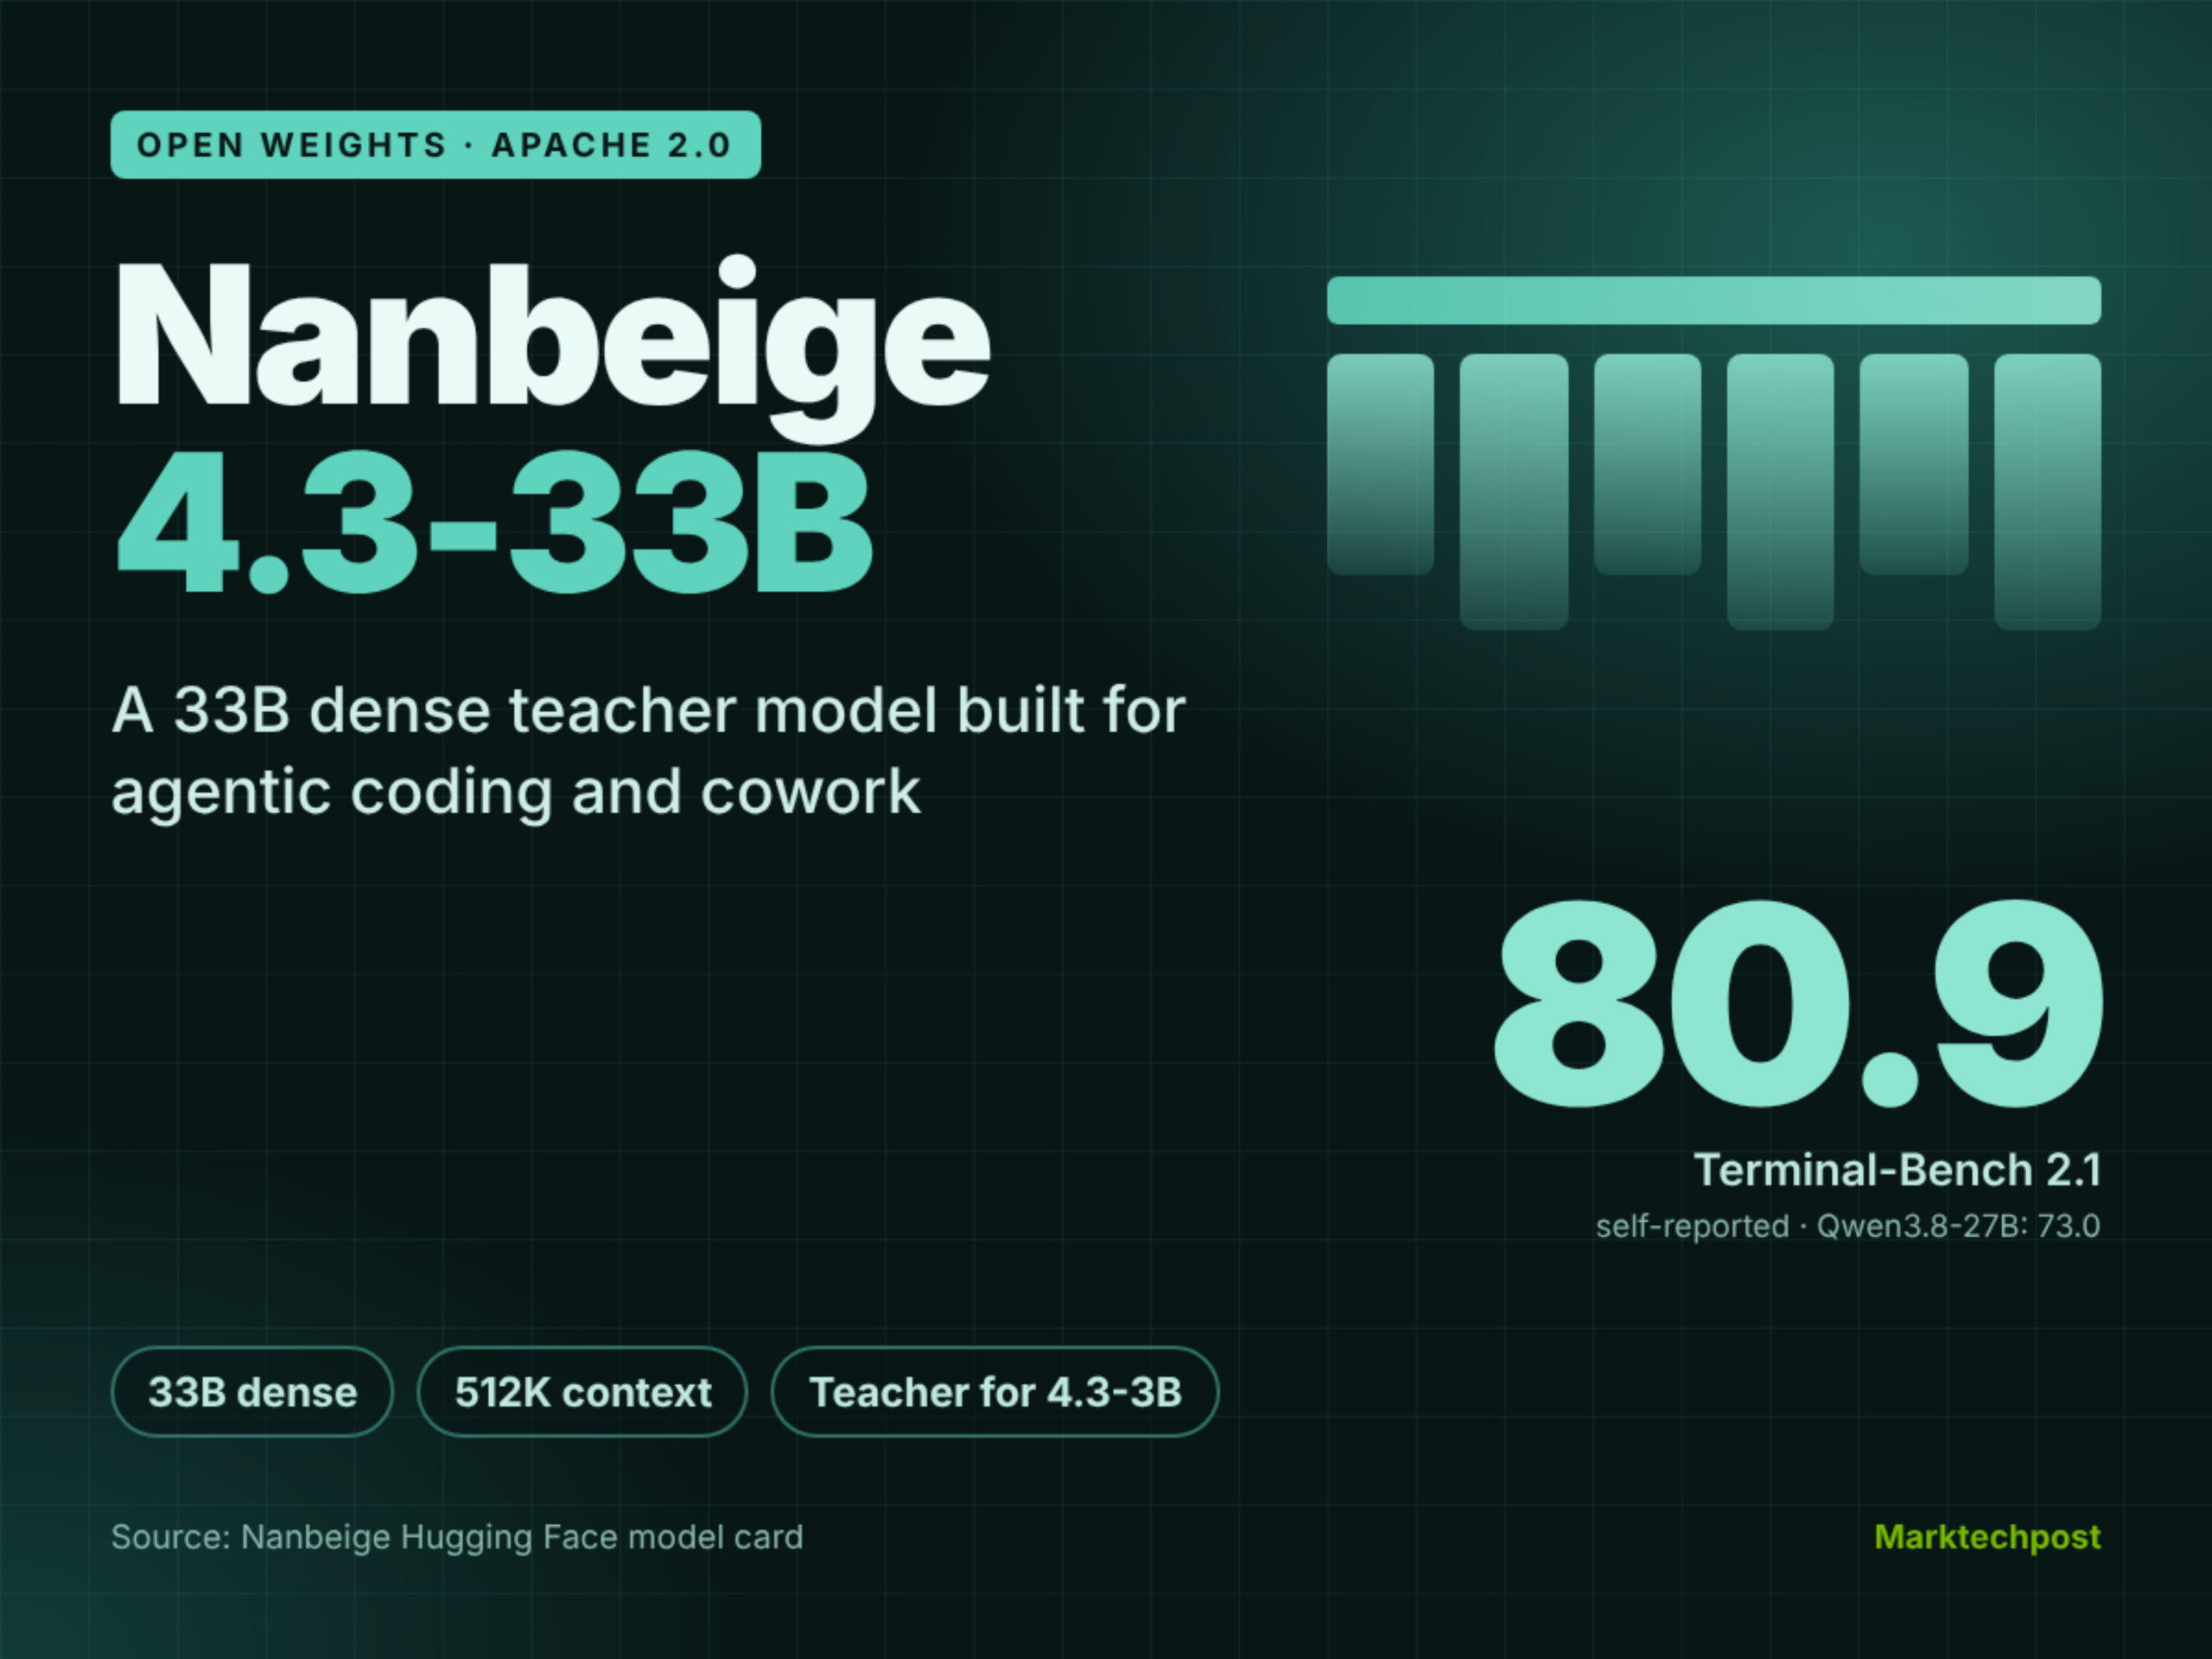
Le laboratoire Nanbeige LLM a publié Nanbeige4.3-33B sur Hugging Face sous licence Apache 2.0. Nanbeige4.3-33B est un modèle linguistique dense de 33 milliards de paramètres, conçu pour la rédaction de code de type « agentique » et les tâches de « collaboration » de type bureautique. Le laboratoire fait partie de la plateforme de recrutement BOSS Zhipin. Il a par ailleurs publié Nanbeige4.3-33B-Base pour un post-entraînement personnalisé. Le modèle d’IA prend en charge une fenêtre de contexte de 524 288 tokens. Dans le classement établi par le laboratoire lui-même, il arrive en tête dans 17 des 20 tests de performance par rapport à 3 modèles ouverts avoisinant les 30 milliards.
Nanbeige4.3-33B est le modèle « enseignant » phare de la série Nanbeige4.3. La stratégie affichée par le laboratoire consiste à développer d’abord un enseignant performant. Il prévoit ensuite de transposer les compétences d’agent dans des modèles plus petits, à commencer par Nanbeige4.3-3B.
Nanbeige4.3-33B est le modèle « enseignant » phare de la série Nanbeige4.3.
Le fichier `config.json` déclare une architecture standard « LlamaForCausalLM ». Il n’y a pas de routage par expert, de sorte que les 33 milliards de paramètres sont exécutés sur chaque token.
Le modèle de chat propose trois contrôles : `enable_thinkingtoggles`, qui active le raisonnement et est activé par défaut ; `preserve_thinking`, qui conserve le raisonnement des tours précédents. Nanbeige le recommande pour l’utilisation d’outils sur de multiples tours et pour les agents de code. Le paramètre `passingtools` active l’appel d’outils ; un format d’appel XML est recommandé.
Nanbeige a comparé ce modèle d’IA à Qwen3.8-27B, Muse-Glimmer-30B et Gemma4-31B. Chaque modèle a fonctionné à son niveau de performance maximal, avec des hyperparamètres et des harnais communs. Tous les scores mentionnés dans cette section sont fournis par les auteurs eux-mêmes.
Il perd 3 lignes sur 20. Qwen3.8-27B devance SWE-Bench Pro (61,7 contre 60,3) et GDPval (86,4 contre 84,8). Gemma4-31B devance GPQA Diamond dans le classement de Nanbeige, avec 91,3 contre 89,5.
En parallèle, le modèle « TheBase » surpasse le modèle « Gemma4-31B-Base » dans les 8 tâches évaluées. Citons par exemple les tests MMLU-Pro (66,9 contre 59,3) et GPQA (62,0 contre 41,5).
Le chapitre n’est pas clos, loin de là.
Sur le même sujet :
- L’économie numérique de l’Asie du Sud-Est devrait atteindre 368 milliards de dollars
- Le PDG d’Hugging Face met en garde contre les inexactitudes du documentaire de Netflix sur le piratage d’OpenAI | TechCrunch
- Google Cloud lance llm-d 1.0 avec un routage tenant compte du cache pour les flottes de TPU et de GPU
Couverture originale : MarkTechPost : MarkTechPost