L’écosystème de l’intelligence artificielle continue sa progression à un rythme soutenu.
Google Cloud lance llm-d 1.0 avec un routage tenant compte du cache pour les flottes de TPU et de GPU
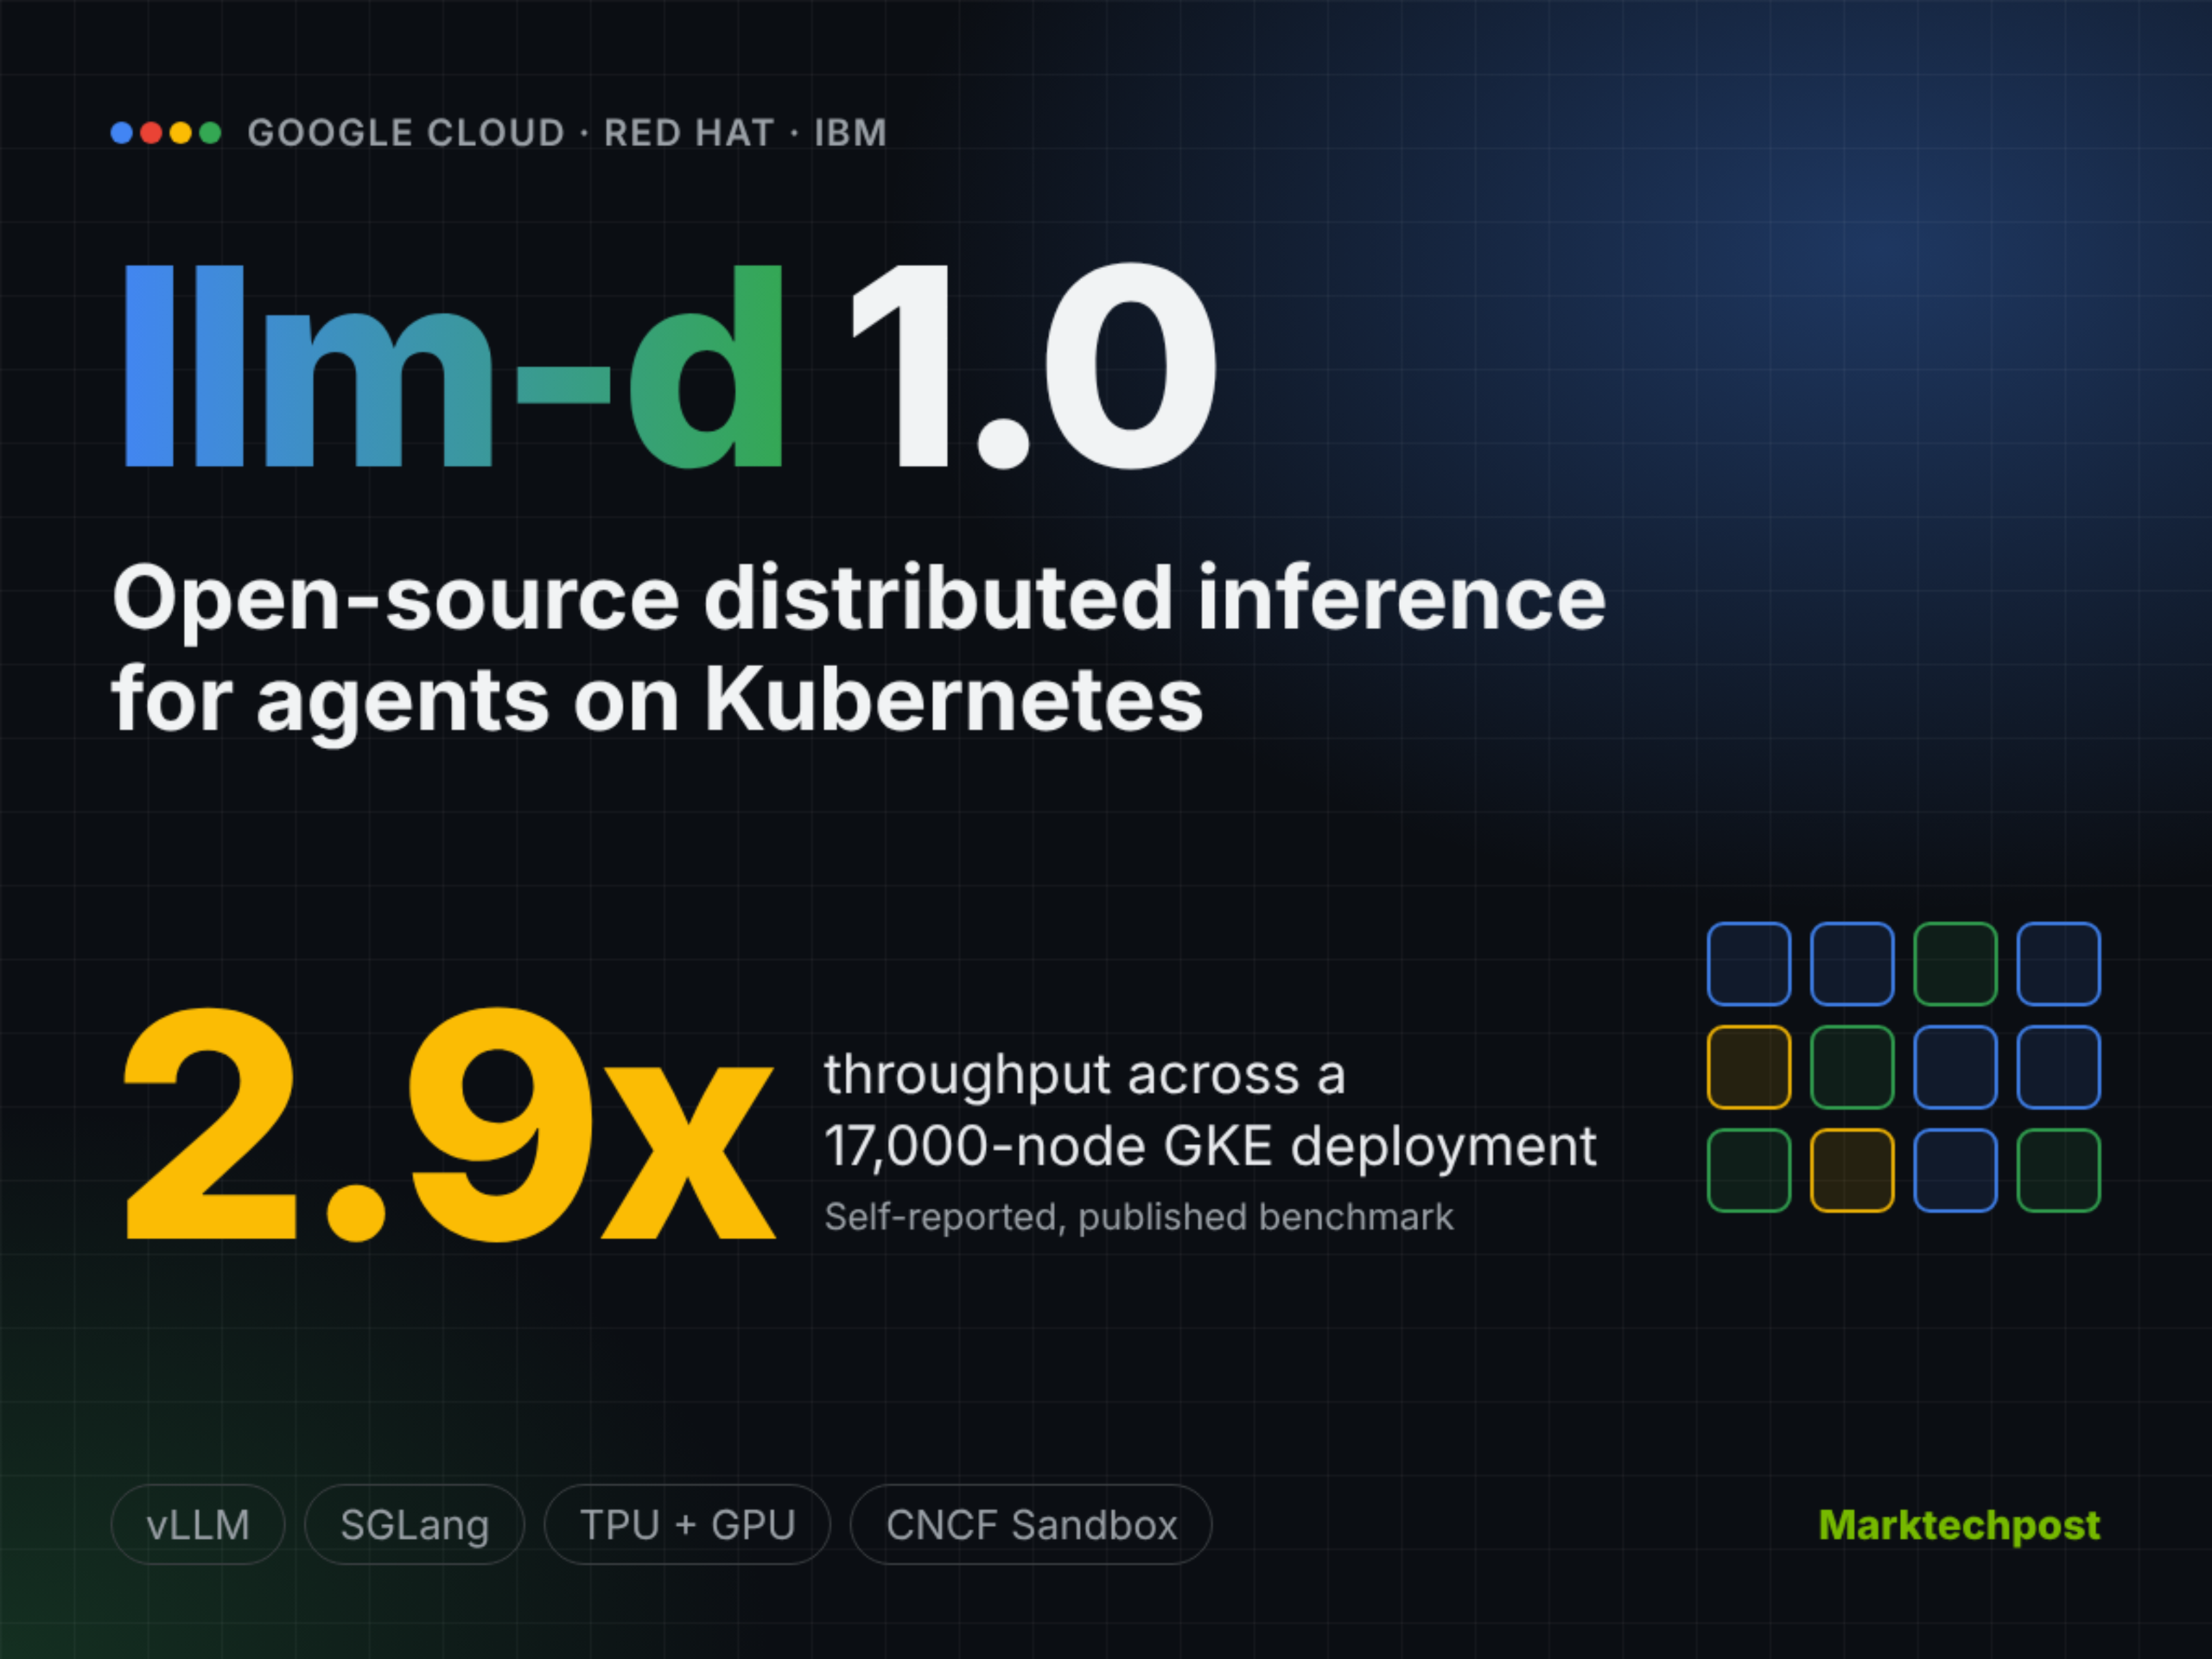
L’équipe de Google a publié llm-d 1.0, la première version stable de sa pile d’inférence distribuée. Cette couche open source, native de Kubernetes, transforme les serveurs de modèles vLLM ou SGLang en un pool coordonné. Elle a été présentée lors de la PyTorch Conference North America. Elle cible les agents auto-hébergés et les charges de travail de RL (apprentissage par renforcement), pour lesquels l’équilibrage de charge de type « round-robin » ne fonctionne pas.
llm-d a été fondé en 2025 par Red Hat, IBM, Google Cloud, CoreWeave et NVIDIA. Red Hat, IBM et Google en sont les principaux responsables. Le projet compte plus de 500 contributeurs issus de plus de 25 organisations. Il s’agit d’un projet CNCF Sandbox, accepté le 12 mars 2026, et distribué sous licence Apache 2.0.
Le projet compte plus de 500 contributeurs issus de plus de 25 organisations.
Le routage tenant compte des préfixes, le déchargement du cache KV, la désagrégation du préremplissage et du décodage, le parallélisme étendu et l’inférence par lots sont déjà disponibles. La version 1.0 vise à assurer leur fonctionnement fiable en production, ce qu’IBM appelle les « opérations du jour 2 ».
Fait intéressant, le routeur llm-d s’appuie sur l’extension d’inférence de l’API Kubernetes Gateway. Il identifie les répliques qui hébergent chaque préfixe mis en cache. Il évalue ensuite la charge et la latence prévue avant de sélectionner une réplique. Les agents appellent un point de terminaison, et chaque étape est traitée là où son contexte se trouve déjà.
Parallèlement, lorsque la mémoire de l’accélérateur est pleine, le cache KV est transféré vers la mémoire hôte, puis vers le SSD ou Managed Lustre. Pour ce faire, le dispositif utilise OffloadingConnector de vLLM, Mooncake ou HiCache de SGLang. Le préremplissage et le décodage s’exécutent dans des pools distincts, car le préremplissage est très gourmand en ressources de calcul, tandis que le décodage est limité par la mémoire.
Tous les chiffres ci-dessous ont été communiqués par Google et les utilisateurs de llm-d.
Il faudra attendre les retours concrets pour juger de l’impact réel.
Sur le même sujet :
- Inception lance le système de langage à grande échelle (LLM) « Mercury 3 Diffusion » avec un débit de 1 068 tokens par seconde
- NVIDIA open-source Run:ai sous licence Apache 2.0 pour l’orchestration des GPU sur Kubernetes
- NVIDIA lance Nemotron 3.5 Super VL, un modèle d’IA d’agent multimodal ouvert de 120 milliards de paramètres
Lire l’article complet sur MarkTechPost : MarkTechPost