
Le domaine de l’IA connaît encore aujourd’hui une évolution intéressante.
Au-delà des modèles du monde spécifiques à un domaine : JEPA-Anything utilise une seule recette pour sept domaines
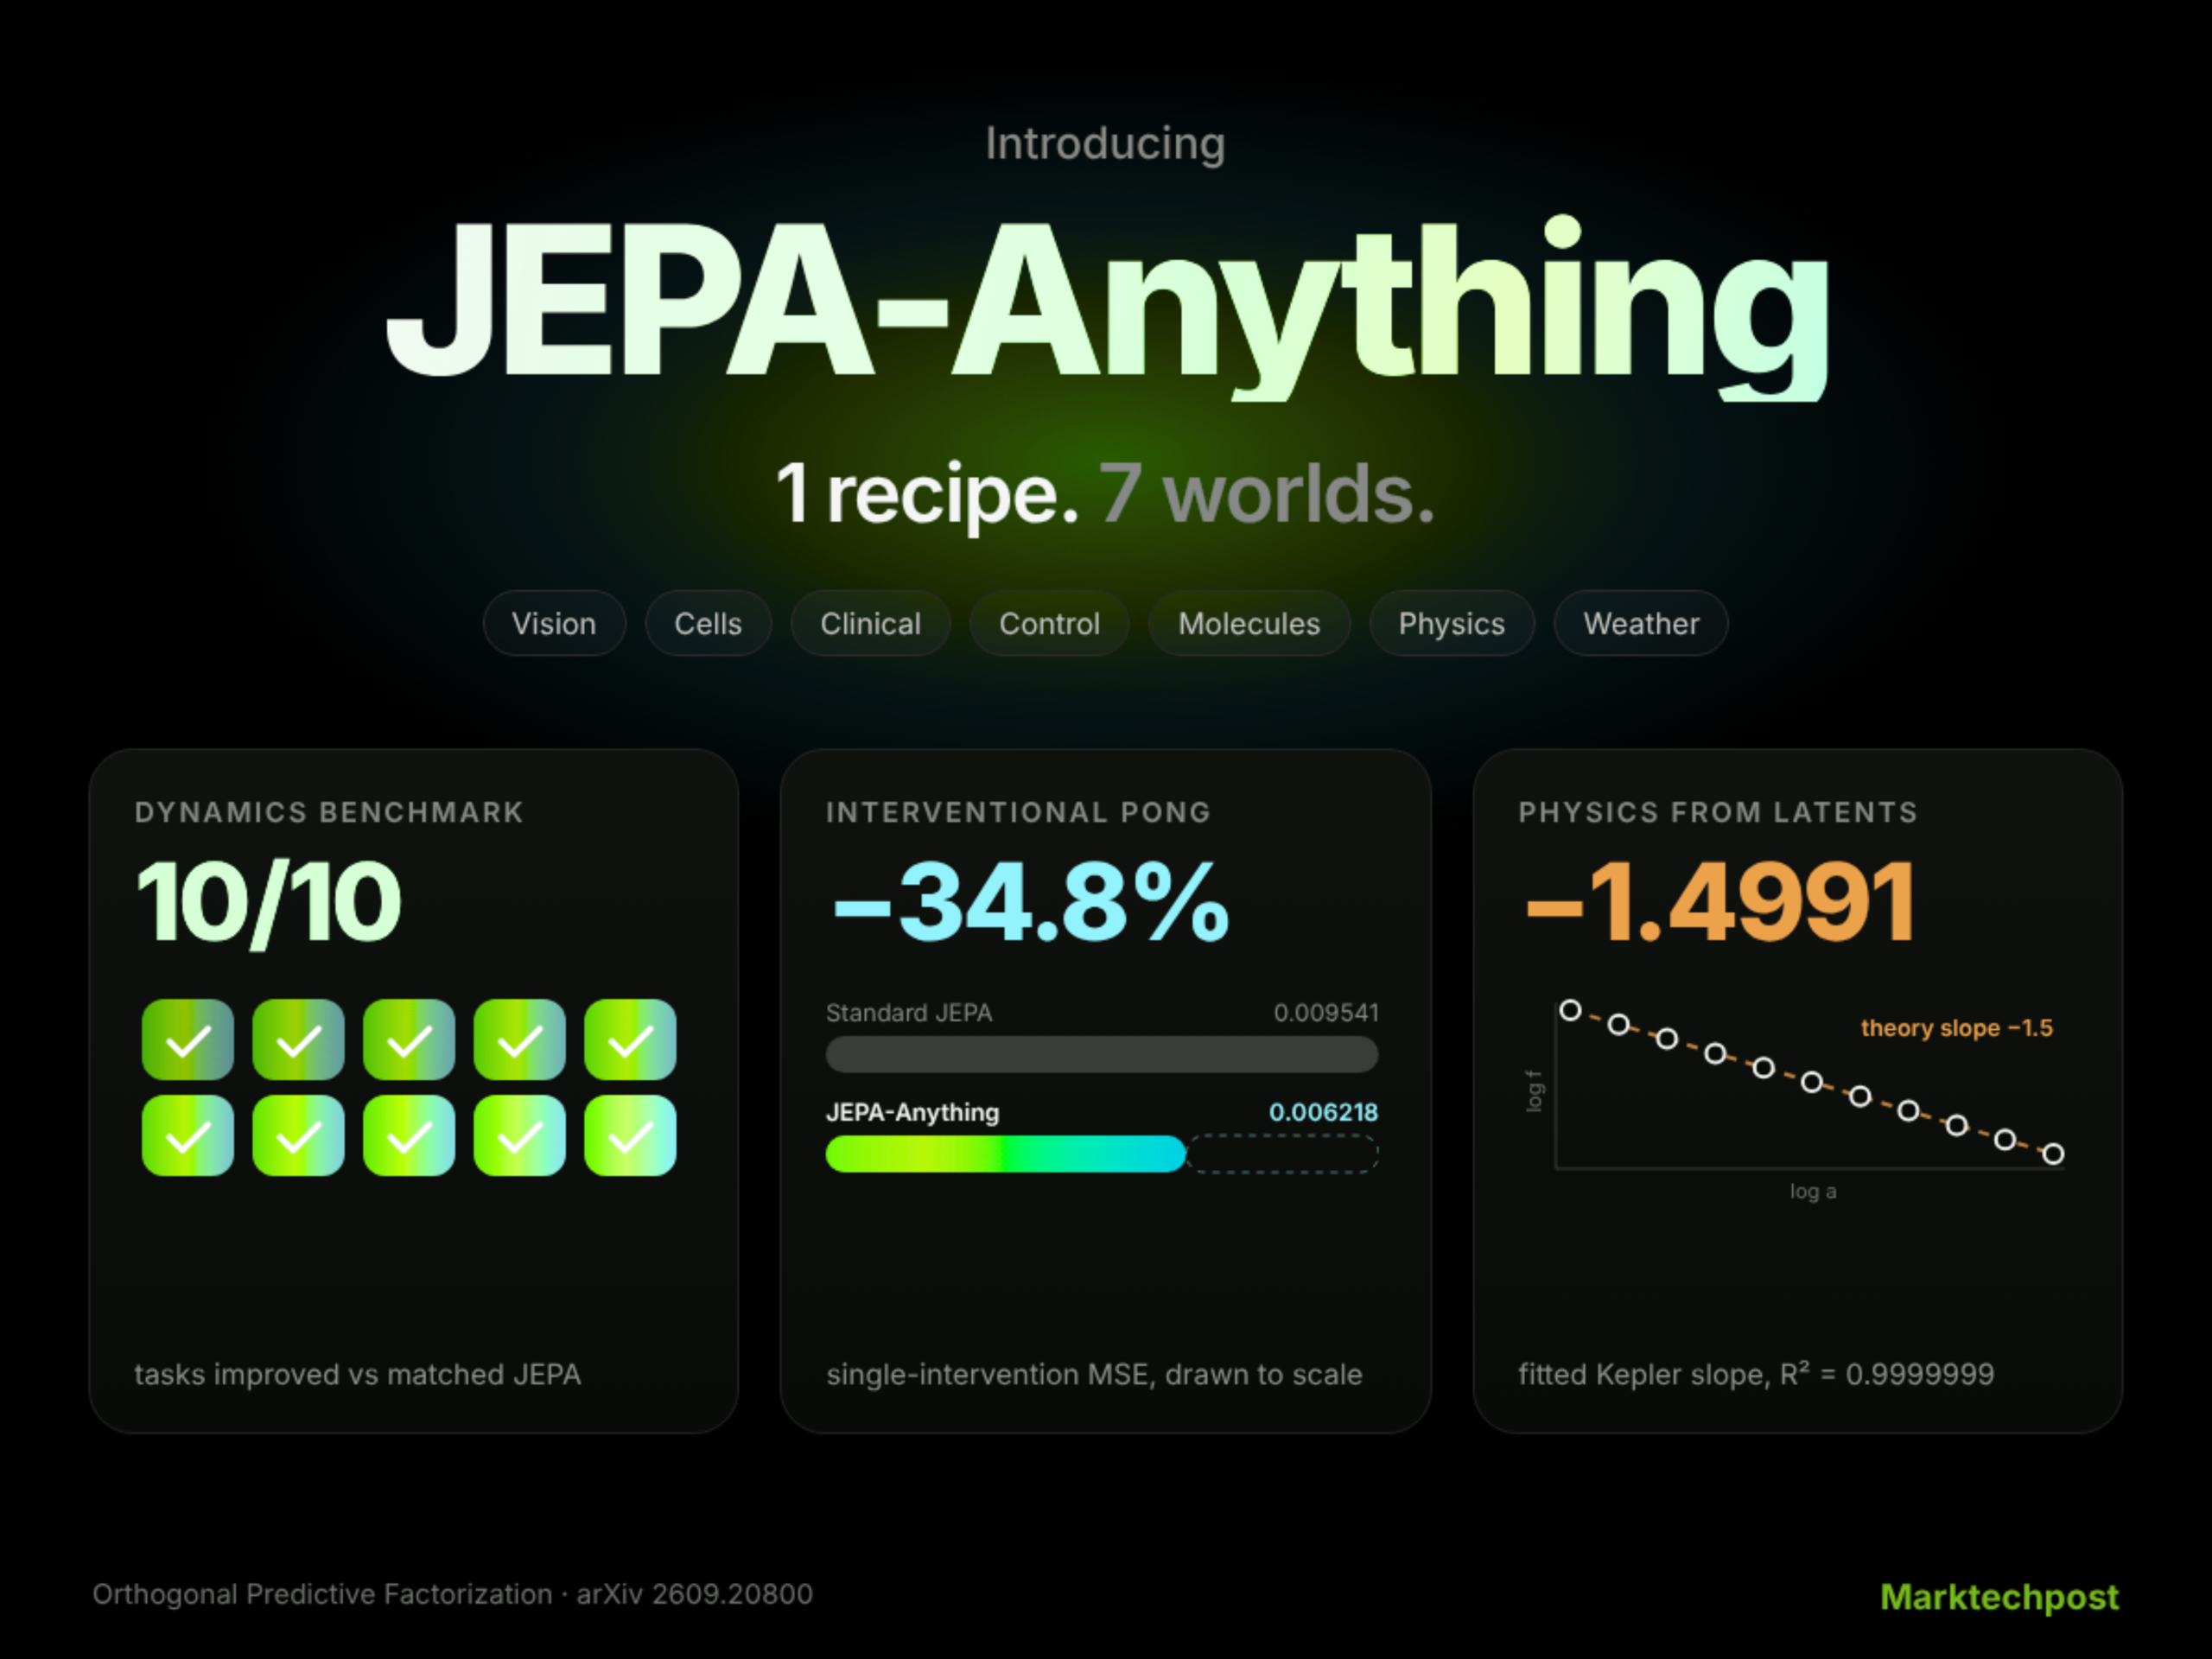
Des chercheurs des laboratoires PhAI, de l’Université chinoise de Hong Kong (CUHK), de l’université de Fudan, de Stanford, d’Oxford et de Princeton ont publié JEPA-Anything, un cadre indépendant du domaine permettant de construire des modèles du monde. Au lieu de concevoir un nouveau modèle prédictif pour chaque domaine, il applique une méthode d’apprentissage commune à des systèmes très différents. Il étend les architectures prédictives à encodage conjoint (JEPA) grâce à une méthode appelée « factorisation prédictive orthogonale » (OPF). L’équipe de exploration l’a testé dans sept secteurs : la vision, la biologie, les parcours cliniques, le contrôle, la dynamique moléculaire, les champs physiques et la météorologie.
Un JEPA standard, tel que l’I-JEPA ou le V-JEPA 2, utilise un codeur de contexte, un codeur cible EMA et un prédicteur. Le prédicteur produit un encodage cible monolithique. L’équipe de travaux de recherche qualifie cela de « problème d’allocation de capacité » : la structure à forte variance domine, et les modes les plus faibles reçoivent des gradients contradictoires.
Les adaptateurs de domaine gèrent la tokenisation et les encodeurs ; la bibliothèque `thecore` expose le noyau commun sous le nom `OrthogonalFactorProjection`.
À relever, l’OPF divise la cible latente de largeur d en K sous-espaces appris de largeur r, avec d = K × r. La plupart des expériences utilisent K = 4. Chaque facteur se voit attribuer un prédicteur dédié. Les prédictions des facteurs sont ensuite recombinées à l’aide de la pseudo-inverse de Moore-Penrose de la matrice de projection. On obtient ainsi un état latent complet destiné au décodage, à la planification ou au rollout.
Dans le même temps, la perte OPF est simplement ajoutée à la perte d’entraînement initiale de chaque domaine. Les adaptateurs de domaine gèrent la tokenisation et les encodeurs ; la bibliothèque `thecore` expose le noyau commun sous le nom `OrthogonalFactorProjection`.
L’orthogonalité est essentielle pour une synthèse stable. OnCITRIS Interventional Pong, un modèle multi-têtes sans contrainte et à capacité équilibrée, présentait un nombre de condition de 438,52. La version orthogonale a atteint 1,00005, avec un chevauchement des facteurs croisés proche de zéro.
Par ailleurs, groupe I, résultats finaux : sur les informations unicellulaires, le coefficient de regroupement PBMC « zero-shot » (AvgBIO) a atteint 0,7752 contre 0,7194 pour Cell-JEPA. Le coefficient de Pearson avec perturbation de Norman est passé de 0,787 à 0,814. Pour la prévision de plus de 1 000 événements cliniques à partir des données de la UK Biobank, la valeur moyenne du PRAUC était de 0,718, contre 0,711 pour le modèle JEPA standard apparié.
Les retombées concrètes se feront sentir dans les mois qui viennent.
Dans le même ordre d’idées :
- Les gens détestent vraiment l’IA, alors pourquoi ne s’en lassent-ils pas ?
- Une IA n’arrivait pas à battre les humains à StarCraft, alors elle a décidé de tricher
Information publiée en premier lieu par MarkTechPost : MarkTechPost