
Un acteur majeur du secteur vient de faire parler de lui.
Black Forest Labs lance FLUX 3 Action : un modèle d’action de la catégorie « 7B Open-Weights » qui surpasse le RoboLab-120
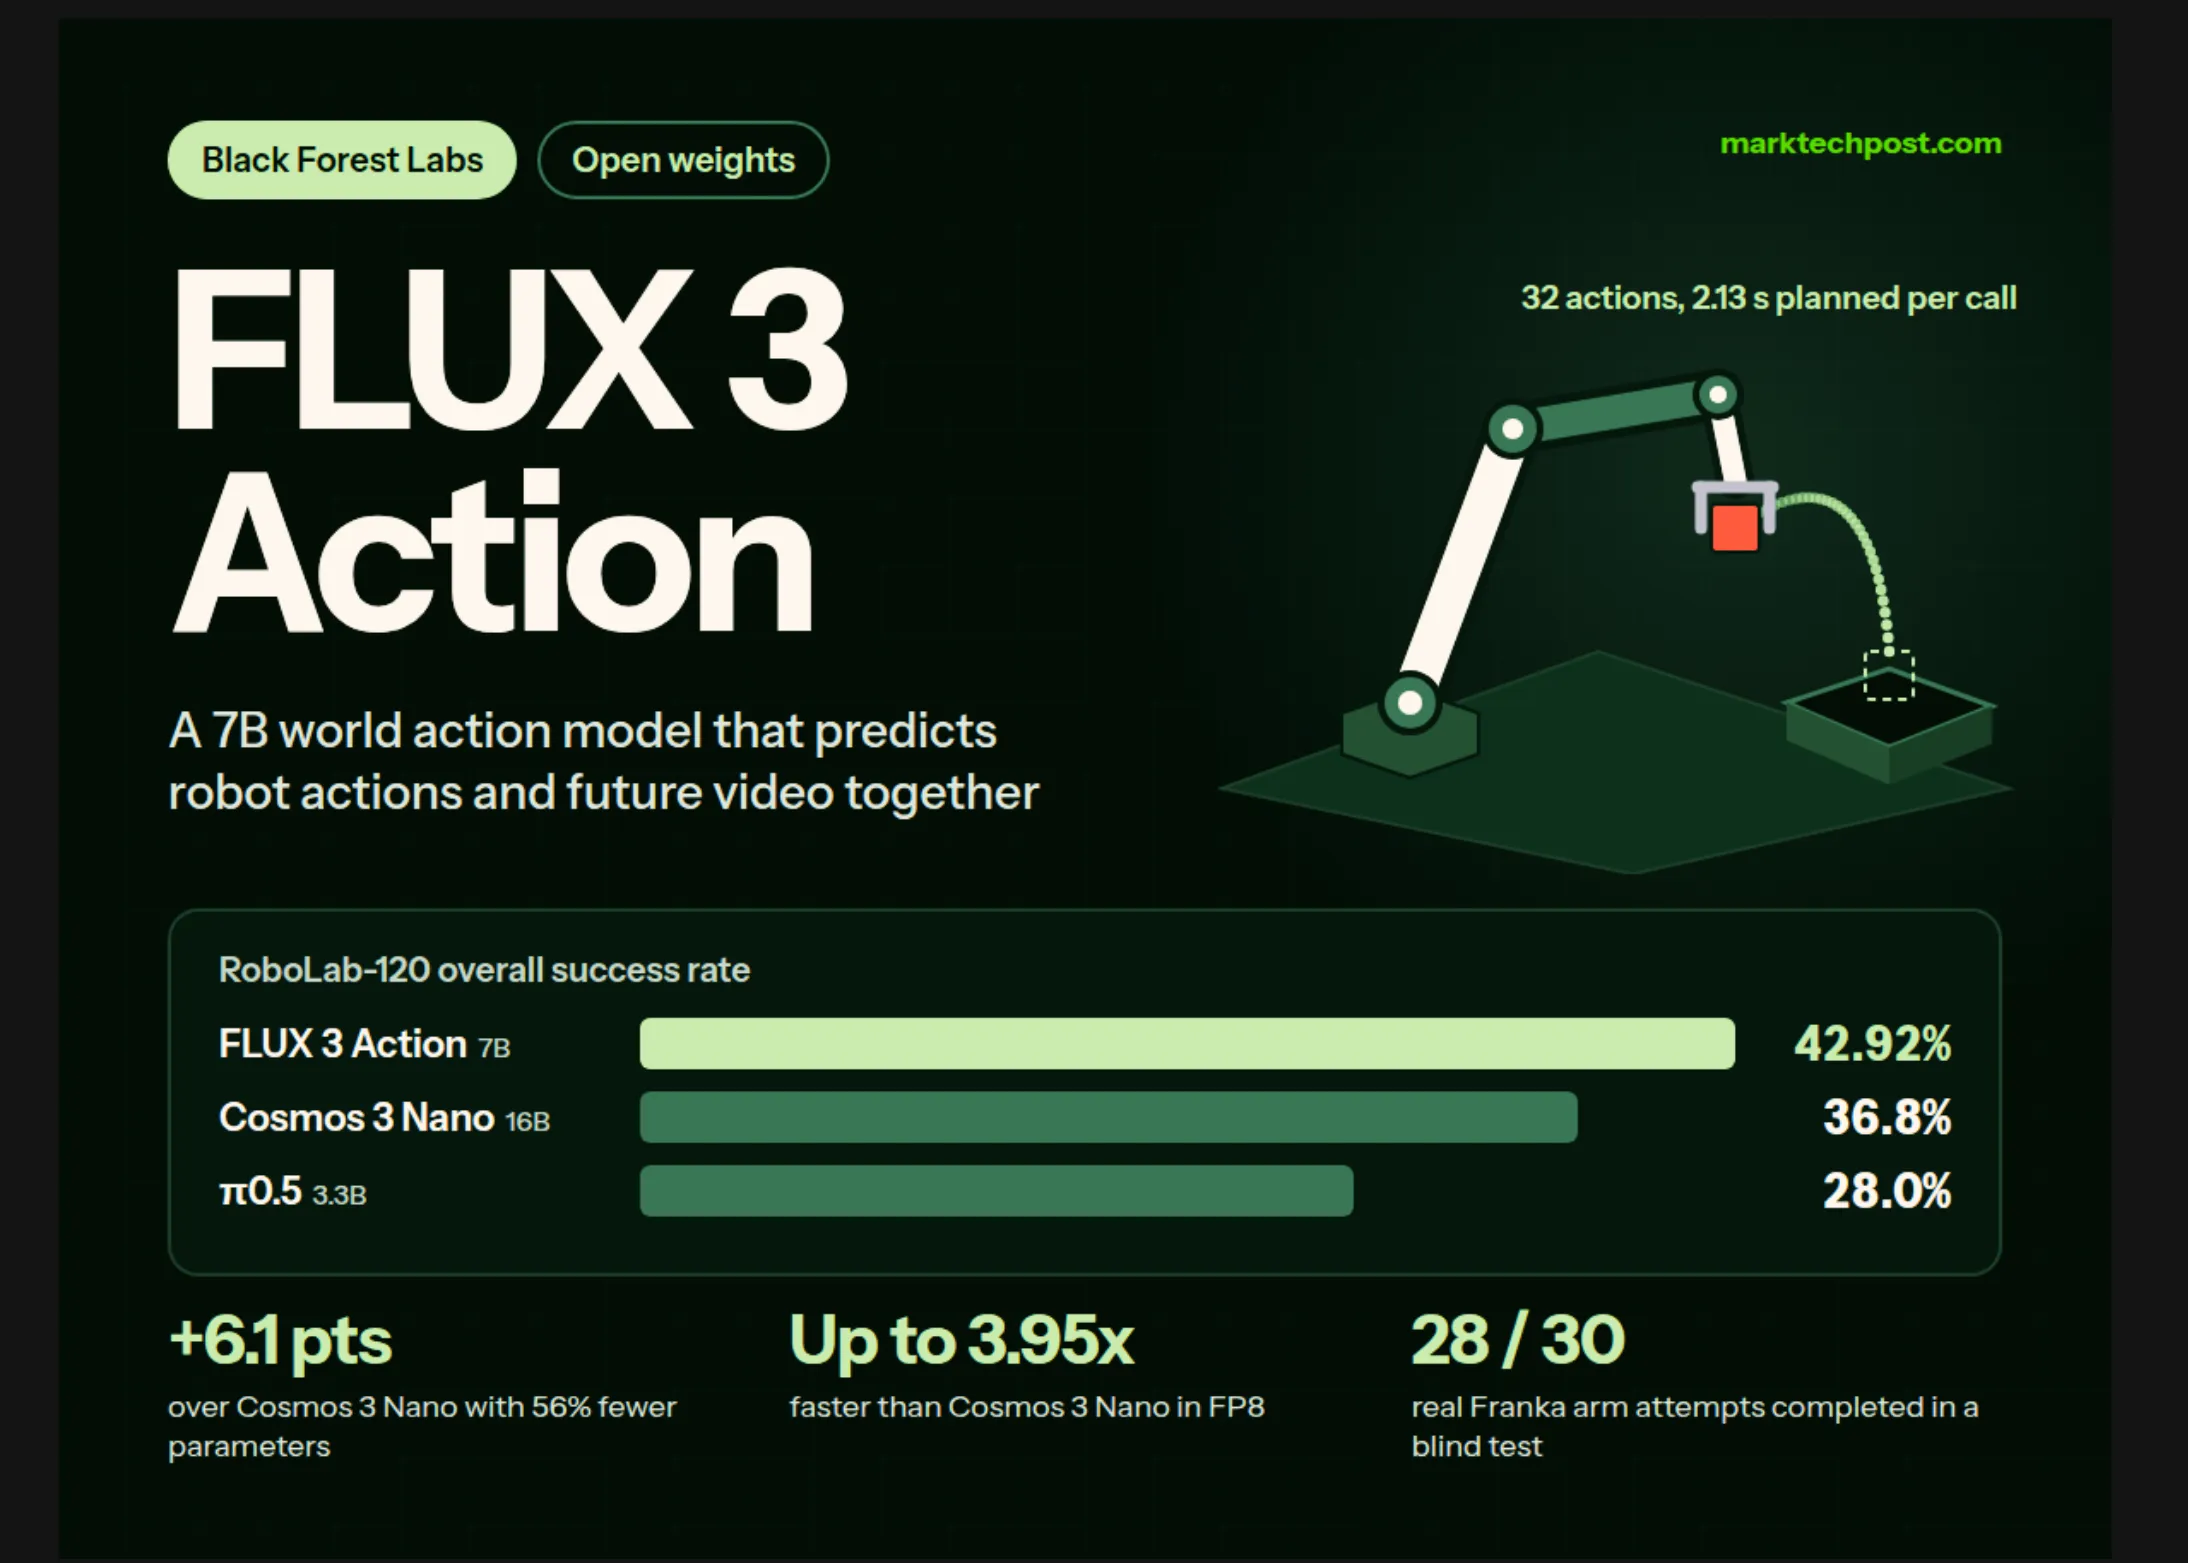
Black Forest Labs (BFL), le laboratoire à l’origine des modèles d’images FLUX, a lancé FLUX 3 Action. Il s’agit d’un modèle d’IA d’action mondial (WAM) à poids ouverts de 7 milliards de paramètres, destiné au contrôle des robots. Le modèle analyse les images de la caméra, l’état du robot et une instruction textuelle. Il prédit ensuite à la fois les images vidéo futures et la prochaine séquence d’actions. Au classement RoboLab-120, il occupe la première place avec un taux de réussite de 42,92 %.
Est-ce déployable ? Oui, sous certaines conditions. La politique DROID nécessite environ 32 Go de mémoire GPU en BF16 sur un H200. Elle prend en charge les cartes de 24 Go avec quantification FP8 et déchargement de l’encodeur de texte. La licence FLUX Kommunity autorise une utilisation non commerciale.
Il faut souligner, les politiques relatives aux robots ouverts imposent généralement un choix. Les WAM, comme le Cosmos 3 Nano de NVIDIA, sont en tête du classement RoboLab avec 36,8 %, cependant la prédiction vidéo est coûteuse. Les VLA, comme π0.5, sont rapides, mais n’atteignent que 28,0 %. Sur un B200, BFL a mesuré que Cosmos 3 Nano (FP8) nécessite environ 4,7 fois plus de temps de traitement que π0,5 (BF16) par seconde de mouvement du robot.
FLUX 3 Action conserve la prédiction conjointe de la vidéo et de l’action. BFL comble l’écart de vitesse en utilisant un réseau de base plus petit et en recourant à la distillation.
FLUX 3 Action est dérivé du modèle de base multimodal FLUX 3. L’apprentissage préalable a utilisé des éléments d’images, de vidéos et audio, les vidéos représentant plus de 95 % des tokens d’entraînement. Le texte, les vidéos et l’état du robot sont encodés sous forme de tokens. Les tokens « future » du modèle de base sont décodés en images vidéo, et ses tokens « action » en actions du robot.
Au cours de l’entraînement, les éléments de pré-entraînement mixtes (36,95 % des échantillons) ont été combinées à des vidéos alignées sur les actions (63,05 %). Les éléments d’action comprenaient des enregistrements de jeux, des vidéos égocentriques de mains humaines, des préhenseurs portatifs et des opérations à distance, couvrant 14 incarnations. La plupart des données robotiques utilisent un espace d’action commun de 50 dimensions pour l’effecteur terminal, appelé EE50.
Point notable, le pré-entraînement joue ici un rôle crucial. Sans lui, les performances de l’entraînement exclusivement sur DROID sont restées inférieures à 1 % sur RoboLab. Avec le pré-entraînement, ce même protocole a atteint 11,6 %.
Le contexte technologique évolue, et ce type d’annonce en témoigne.
Dans le même ordre d’idées :
- Groupe consultatif sur les mathématiques et l’intelligence artificielle
- NVIDIA présente SoL-Pi : des boucles de recherche automatique qui réduisent le trafic de jetons des agents de codage jusqu’à 49 %
- SpaceXAI lance Grok 4.7 : un système de base plus puissant au même prix que Grok 4.6, soit 2 $ ou 6 $
Lire l’article original sur MarkTechPost : MarkTechPost