
Une évolution notable vient d’être rendue publique dans le domaine.
SpaceXAI lance Grok 4.7 : un système de base plus puissant au même prix que Grok 4.6, soit 2 $ ou 6 $
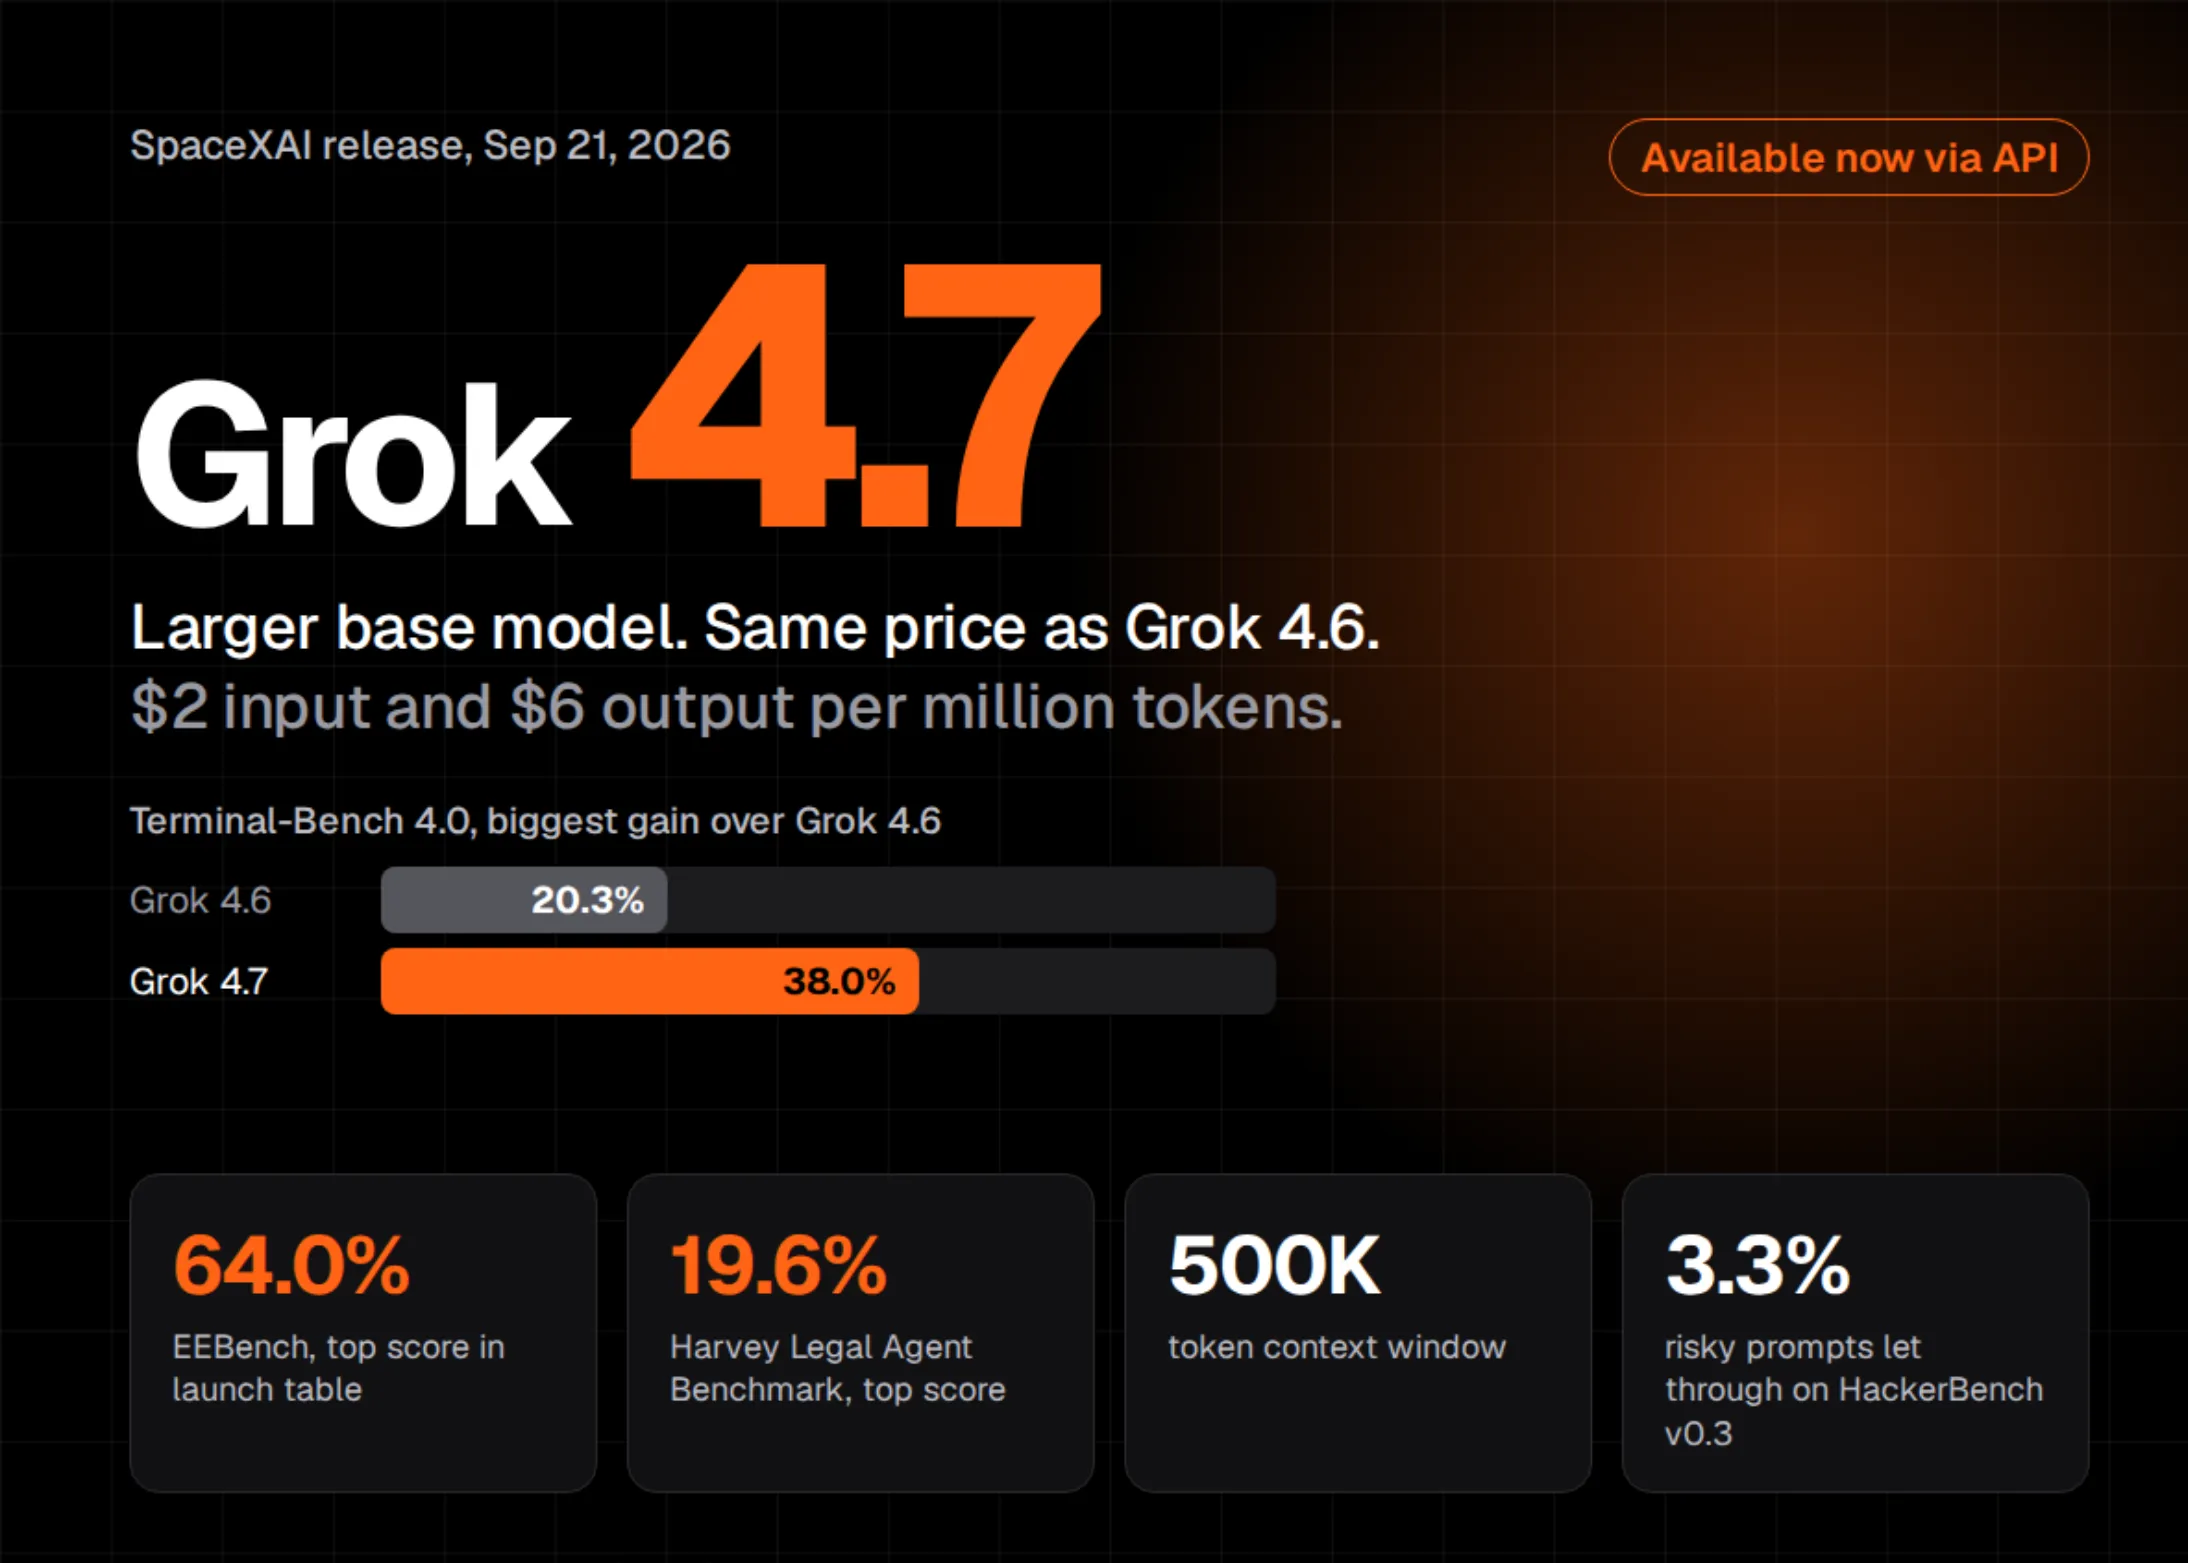
SpaceXAI a lancé Grok 4.7, son nouveau modèle d’IA phare dédié au codage, aux tâches agentiques et au travail intellectuel. Grok 4.7 s’appuie sur un modèle d’IA de base plus volumineux et un cycle d’apprentissage par renforcement plus long. Il est toujours proposé au même prix et avec la même vitesse que Grok 4.6.
En parallèle, peut-on le déployer ? Oui, sous forme de modèle hébergé. Vous pouvez dès aujourd’hui accéder à grok-4.7 via l’API xAI, Cursor, Grok Build, OpenRouter, Vercel et Cloudflare.
Le score EEBench a augmenté de 11 points pour atteindre 64,0 %, soit le meilleur résultat du tableau.
Le tableau de comparaison présente les performances de Grok 4.7 en mode « xHigh effort » par rapport à celles de Grok 4.6 en mode « High », de GPT-5.6 en mode « Sol Max » et de Fable 5.1 en mode « Max ». Le score DeepSWE de Grok 4.7 a été calculé en mode « high effort ». Tous les scores sont ceux communiqués par les éditeurs.
Sur ce point, grok 4.7 surpasse Grok 4.6 dans tous les tests. La progression la plus marquée concerne Terminal-Bench 4.0, passant de 20,3 % à 38,0 %. Le score EEBench a augmenté de 11 points pour atteindre 64,0 %, soit le meilleur résultat du tableau. Sur le benchmark de l’agent juridique de Harvey, Grok 4.7 a obtenu un score de 19,6 %, contre 6,7 % pour Fable 5.1 Max.
Grok 4.7 n’est pas en tête dans toutes les catégories. Fable 5.1 Max arrive en tête dans 4 des 7 tests de performance, avec notamment un score de 57,9 % au test Terminal-Bench. GPT-5.6 Sol Max détient le meilleur résultat au test DeepSWE v1.1, avec 72,7 %.
À relever, le prix constitue l’autre axe. Fable 5.1 Max coûte 5 fois plus cher en entrée et environ 8,3 fois plus cher en sortie. GPT-5.6 Sol Max coûte 2 fois plus cher en entrée et environ 3,3 fois plus cher en sortie. Sur le graphique « coût par tâche » de CursorBench 4.0, SpaceXAI place Grok 4.7 à la pointe du rapport prix-performance.
Sur GDPval, qui évalue les compétences professionnelles dans le domaine du travail intellectuel, Grok 4.7 xhigh a obtenu un score Elo de 1 695. Ce résultat est en hausse par rapport aux 1 605 points enregistrés par Grok 4.6 high. Fable 5.1 max arrive en tête avec 1 735, tandis que GPT-6 Astra max a obtenu un score de 1 542. SpaceXAI affirme également que Grok 4.7 est plus performant pour la création de documents et de présentations.
Notons par ailleurs, grok 4.7 intègre une toute inédite pile de mesures de sécurité. SpaceXAI le qualifie de modèle le plus performant qu’elle ait testé en matière de refus et de résistance au « jailbreak ». Il a obtenu le meilleur score au test de référence de biosécurité de LatchBio, avec 62,4 %.
En quelques mots :
- Sur le graphique « coût par tâche » de CursorBench 4.0, SpaceXAI place Grok 4.7 à la pointe du rapport prix-performance.
- Fable 5.1 max arrive en tête avec 1 735, tandis que GPT-6 Astra max a obtenu un score de 1 542.
- SpaceXAI le qualifie de modèle le plus performant qu’elle ait testé en matière de refus et de résistance au « jailbreak ».
Le chapitre n’est pas clos, loin de là.
Sur le même sujet :
- L’homme qui a conçu les magasins Apple ne croit pas au pari de la Silicon Valley sur le shopping basé sur l’IA | TechCrunch
- Le ralentissement de la superintelligence artificielle
Lire l’article complet sur MarkTechPost : MarkTechPost