L’intelligence artificielle reste au cœur de toutes les attentions.
Meta lance Muse Spark Open : un modèle MoE à poids ouvert de 816 milliards de paramètres avec un contexte d’un million
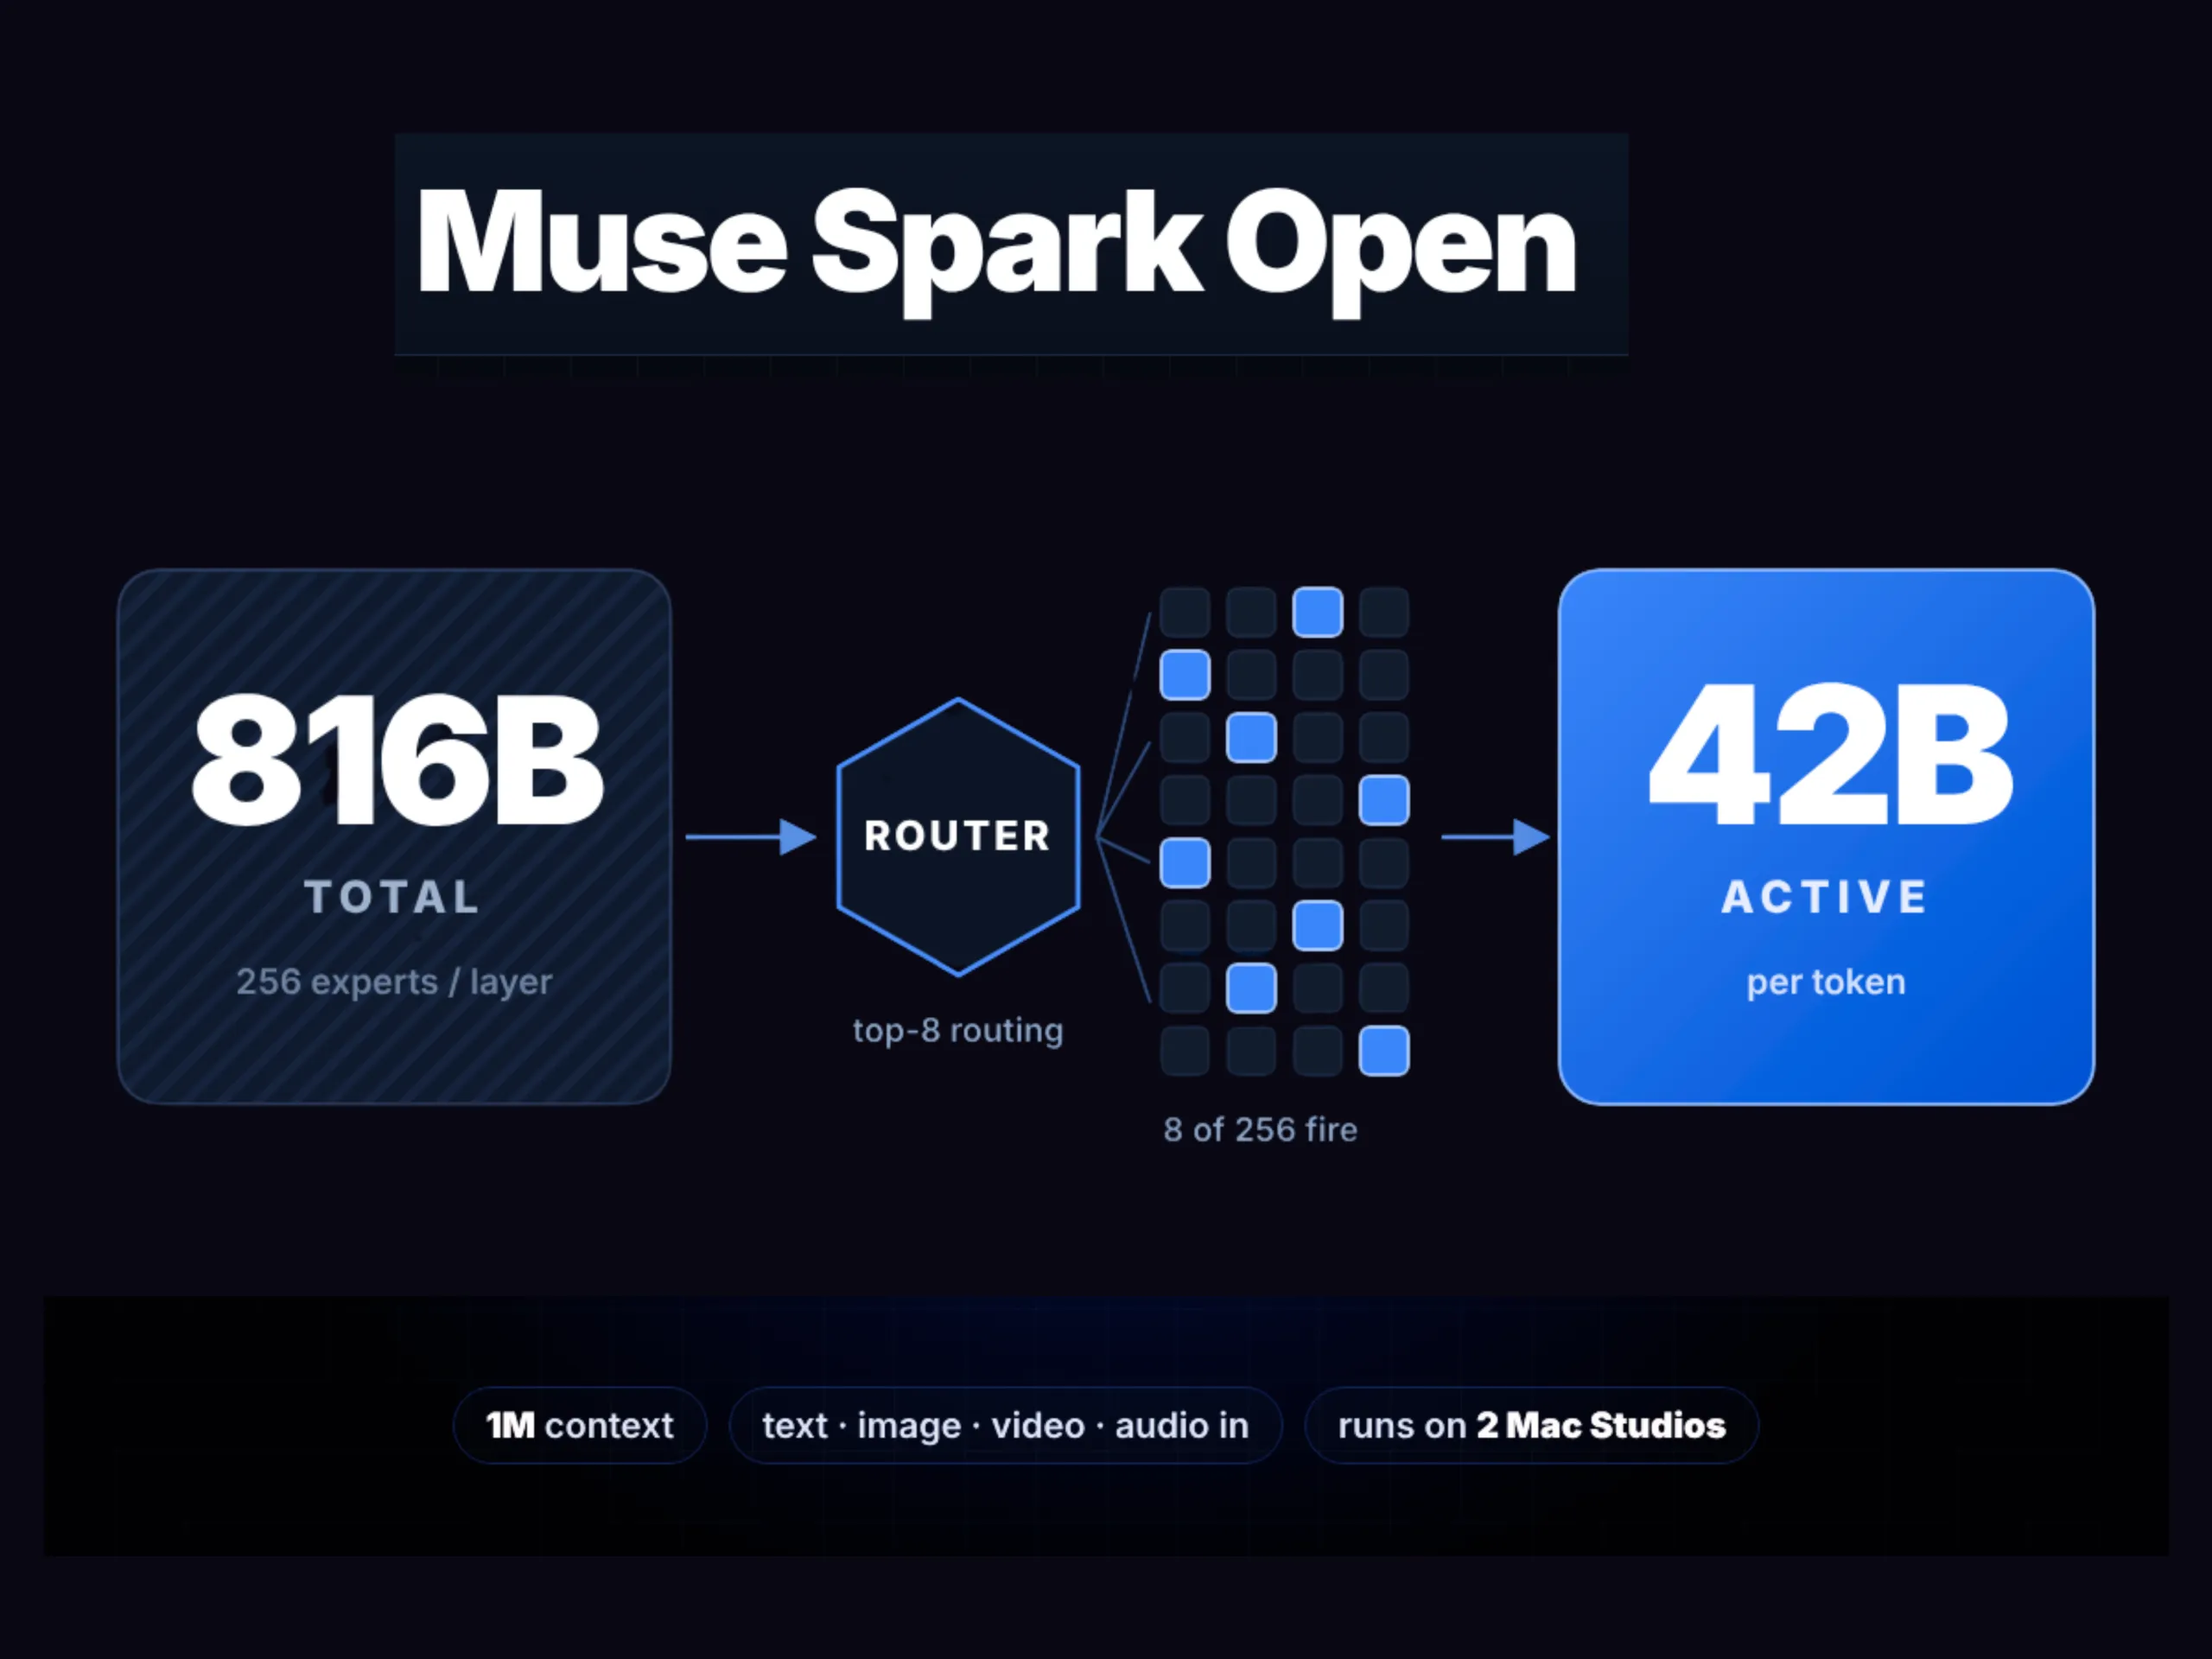
Meta Superintelligence Labs a lancé Muse Spark Open, la version à poids ouvert de son modèle Muse Spark. Muse Spark Open est un modèle de type « Mixture-of-Experts » comptant 816 milliards de paramètres, qui active 42 milliards de paramètres par token. Il accepte des entrées sous forme de texte, d’images, de vidéos et d’audio, renvoie du texte et dispose d’une fenêtre de contexte d’un million de tokens. L’équipe de Meta affirme qu’il s’agit du modèle américain à poids ouverts le plus performant à ce jour. Pour les programmeurs, la véritable nouveauté réside dans le déploiement : la version NVFP4 fonctionne sur deux Mac Studio équipés de puces Apple M5 Ultra.
Dans le même temps, muse Spark Open est un modèle MoE multimodal natif développé par Meta, conçu pour le codage et les tâches agentiques à long terme. Les poids sont disponibles aux formats BF16 et NVFP4 sur Hugging Face. La version ouverte a bénéficié d’un renforcement de la sécurité après l’entraînement. L’équipe de Meta affirme que cela le rend plus robuste sans qu’il soit nécessaire de recourir à des garde-fous au niveau du système.
Certains résultats des concurrents sont fournis par les entreprises elles-mêmes ; la méthodologie d’évaluation précise la source de chaque donnée.
La fiche technique du modèle d’IA répertorie 62 couches et une dimension cachée de 8 192. Chaque couche MoE contient 256 experts, et le routage « top-k » en active 8 par token. L’attention est de type « grouped-query », avec 128 têtes de requête et 16 têtes KV. Un encodeur de perception distinct, comptant 1,8 milliard de paramètres, traite les entrées visuelles. Le vocabulaire compte 202 048 tokens, et les données d’entraînement couvrent plus de 100 langues.
La profondeur de raisonnement est définie à l’aide du paramètre `reasoning_effort` : low, medium, high ou xhigh. La valeur par défaut est xhigh.
Meta le compare à Kimi K3, GLM 5.3, Qwen3.8-2.4T-A95B et d’autres modèles à leur capacité de raisonnement maximale. Ses meilleurs retombées concernent l’utilisation d’outils et la fiabilité des connaissances :
Le codage est son point faible. Sur Terminal-Bench 2.1 avec le harnais Terminus 2, il obtient un score de 76,4. Kimi K3 atteint 85,0, GLM 5.3 obtient 83,9 et Qwen3.8, 82,0. Son indice d’intelligence d’analyse artificielle est de 39. Il se classe de cette manière derrière GLM 5.3 (45), Kimi K3 (44) et Qwen 3.8 (40). Le titre de « modèle américain le plus performant » reste donc valable, mais les modèles ouverts chinois conservent la tête du classement général.
Notons par ailleurs, certains résultats des concurrents sont fournis par les entreprises elles-mêmes ; la méthodologie d’évaluation précise la source de chaque donnée.
Selon le guide des programmeurs de Meta, les poids des modèles BF16 s’élèvent à environ 1,6 To. NVFP4 ne quantifie que les experts et atteint environ 530 Go. La fiche technique du modèle recommande au moins 700 Go de VRAM pour NVFP4 et 2 To pour BF16.
Un dossier qu’il faudra continuer à observer dans les mois à venir.
Sur le même sujet :
- Google lance l’API Gemini 4 Argon avec une limite de sortie fixée à 1 million de jetons
- Découvrez Cloudflare Clef-omni : un modèle de décision multimodal de 30 milliards d’A3B pour l’audio, la vidéo, l’image et le texte
- Quand le test de sécurité est devenu une menace : la machine qui a trouvé le moyen de s’échapper toute seule
D’après MarkTechPost : MarkTechPost