Une évolution notable vient d’être rendue publique dans le domaine.
Perplexity et les chercheurs de NVIDIA présentent JOLT : une méthode d’apprentissage par renforcement conjointe enseignant-élève
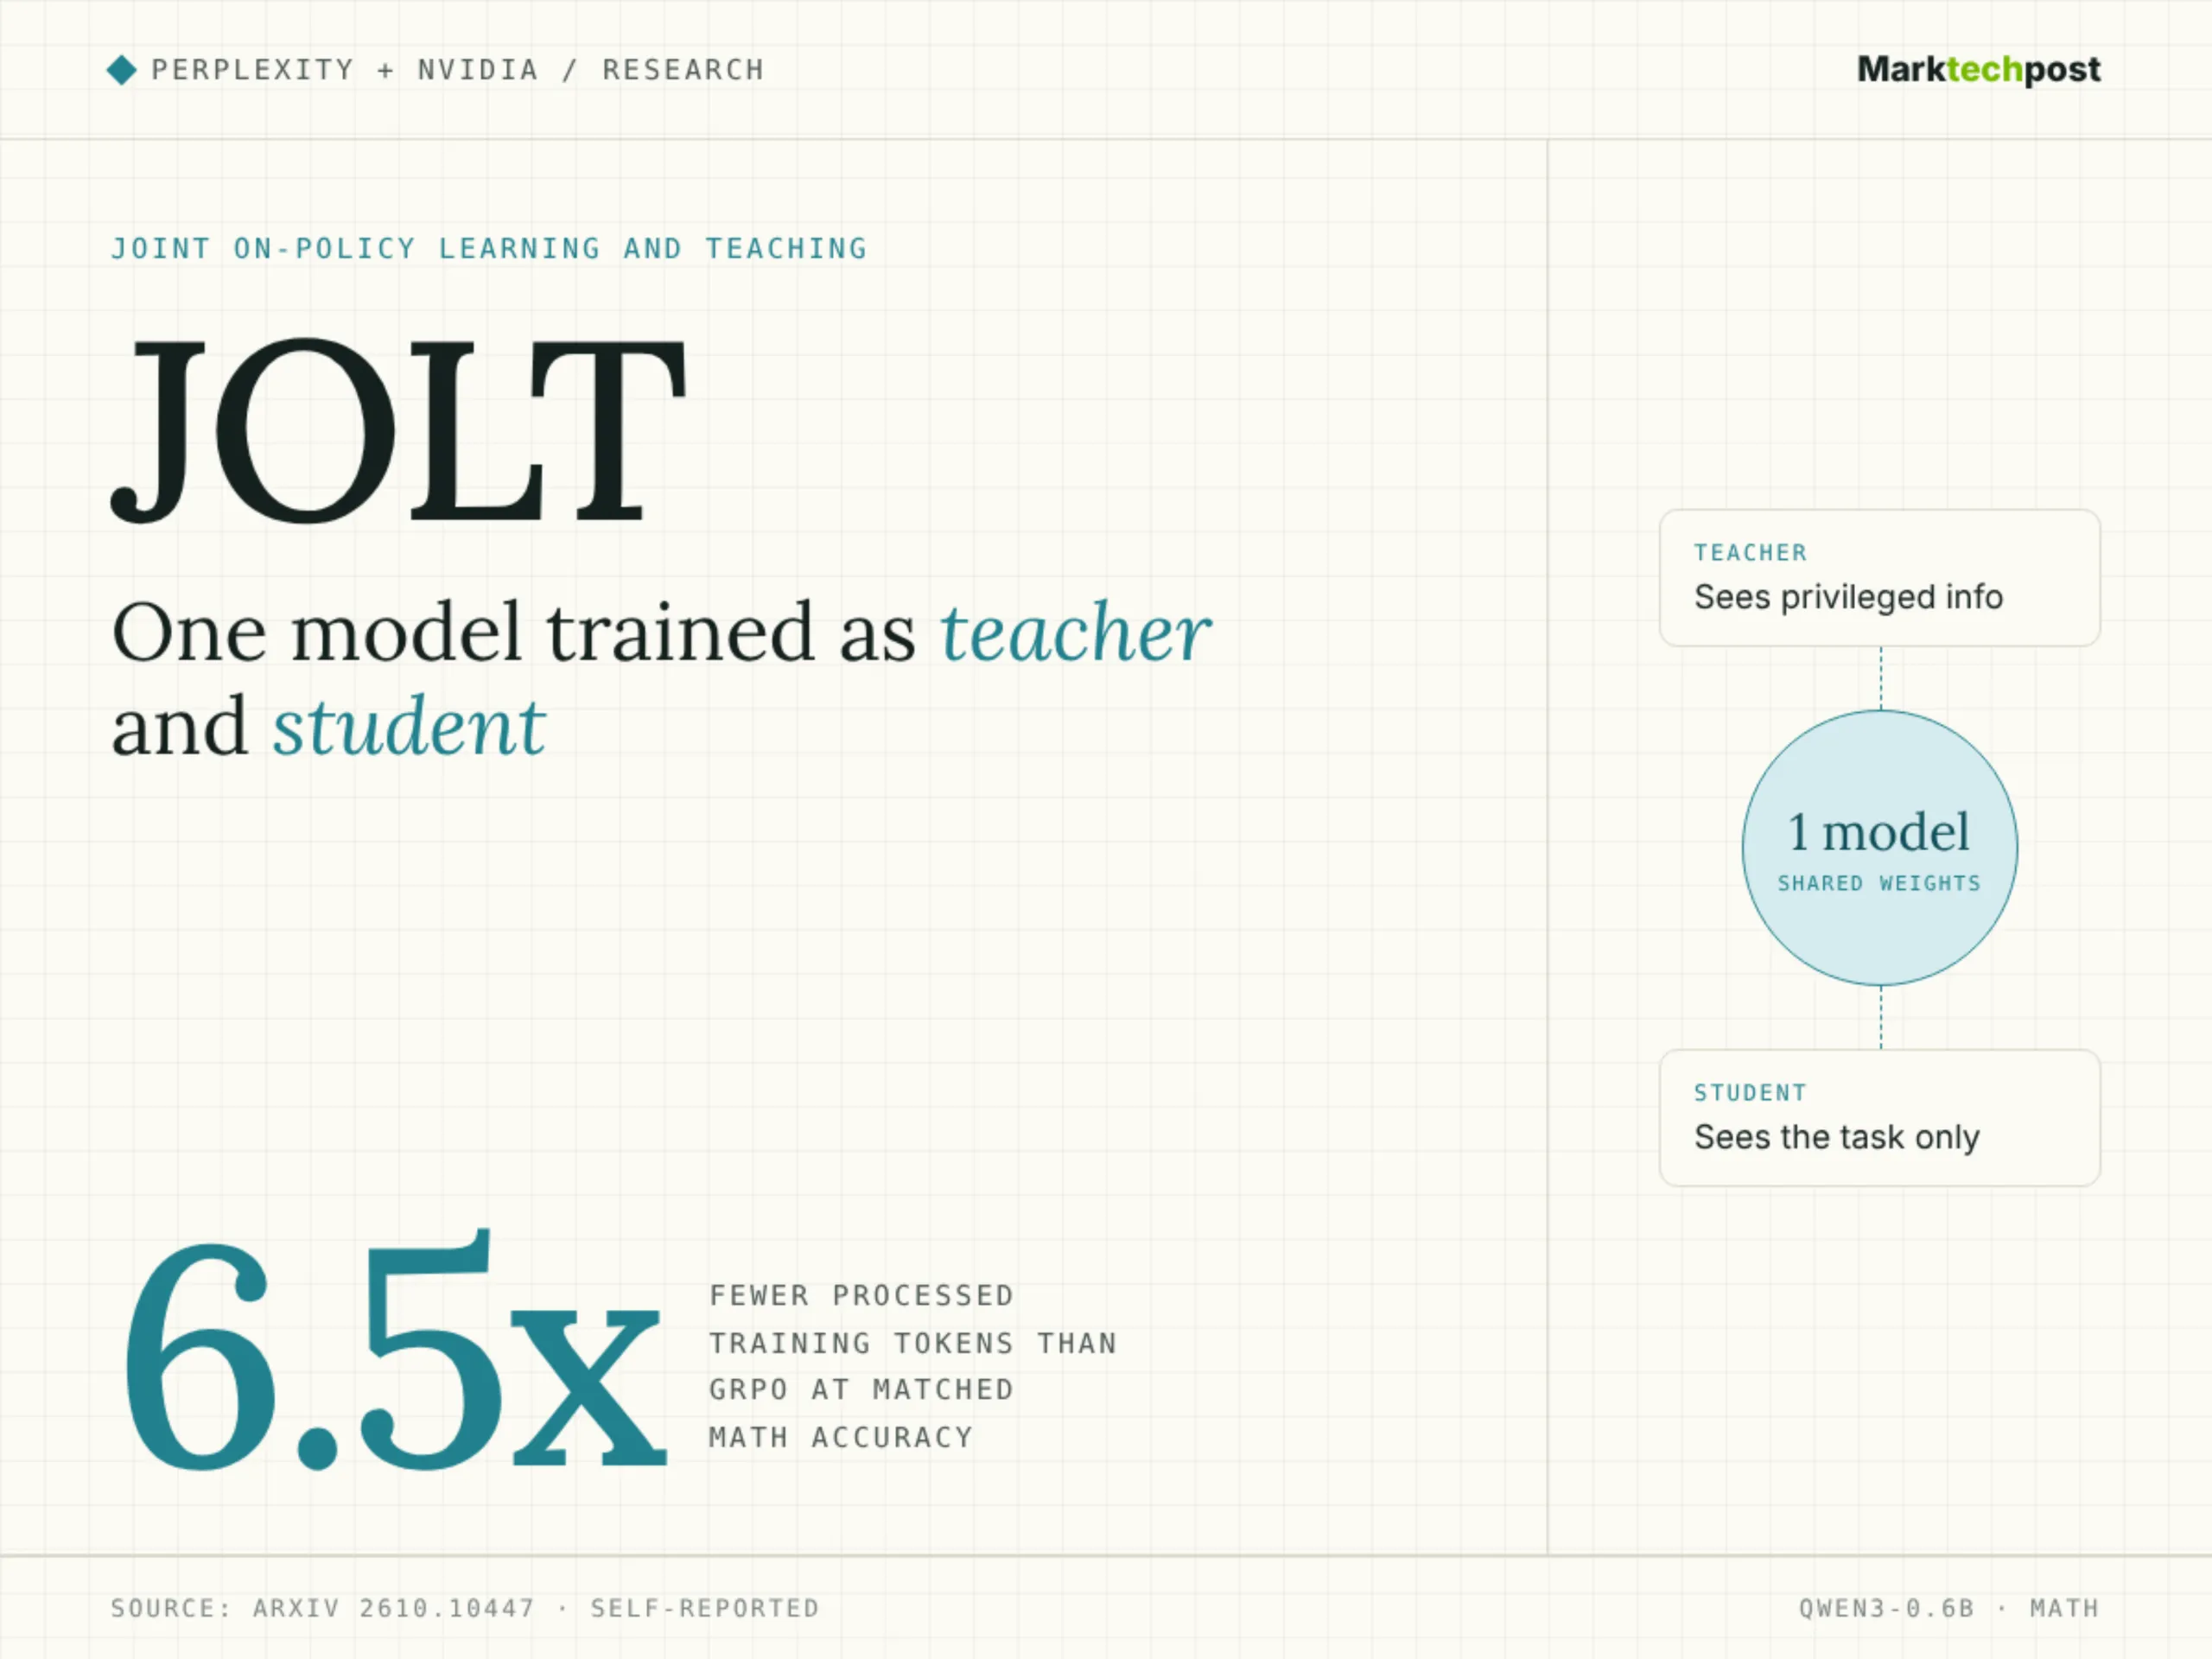
Perplexity, en collaboration avec l’équipe NVIDIA, a présenté JOLT, une nouvelle méthode de post-entraînement pour les modèles linguistiques. JOLT est l’acronyme de « Joint On-policy Learning and Teaching » (apprentissage et enseignement conjoints basés sur une politique). Cette méthode entraîne un seul modèle à remplir deux rôles. L’enseignant a accès à des informations privilégiées, contrairement à l’élève. Le changement essentiel réside dans le fait que l’enseignant est lui aussi formé, ce qui garantit la pertinence de ses retours d’information. En mathématiques, JOLT a égalé la précision de GRPO avec 6,5 fois moins de tokens d’entraînement traités. Pour les équipes qui utilisent l’apprentissage par renforcement (RL) après la phase d’entraînement, cela pose un véritable défi en termes de puissance de calcul.
Sur ce point, jOLT est une méthode d’auto-distillation développée par Perplexity et NVIDIA qui entraîne un seul modèle à la fois en tant que « professeur » et « élève ». Elle s’appuie sur l’On-Policy Self-Distillation (OPSD).
Dans la foulée, les méthodes d’apprentissage par renforcement basées sur les retombées (RL), telles que GRPO, attribuent une seule récompense par tentative. Ce signal est peu précis : il n’indique pas quels éléments ont contribué au succès. Dans le cadre de tâches agentiques de longue durée, les succès sont rares, ce qui ralentit l’apprentissage.
La distillation « on-policy » résout le problème de la parcimonie en faisant attribuer une note à chaque token de l’élève par un « enseignant » plus expérimenté. L’OPSD supprime ce rôle d’« enseignant » distinct. Le modèle d’IA lui-même endosse le rôle d’« enseignant » lorsqu’on lui fournit un contexte privilégié, tel qu’une solution vérifiée.
L’équipe de travaux de recherche estime que cela n’est pas suffisant. Un enseignant qui connaît la réponse peut emprunter des raccourcis que l’élève ne peut pas suivre. Ses conseils peuvent se situer hors de portée de l’élève. Dans cet article, on constate que les divergences entre enseignants et élèves de l’OPSD s’accentuent au cours de la formation MATH.
À relever, jOLT entraîne simultanément les deux rôles d’un même modèle partagé :
La recherche s’articule autour d’un « enseignant cohérent avec la récompense ». La mise à jour de sa distillation devrait aller dans le même sens que le gradient de récompense de l’élève. L’enseignant idéal privilégie les actions à fort avantage tout en restant proche de la politique de l’élève.
Il faut souligner, l’équipe de travaux de recherche a testé cinq scénarios, chacun avec un modèle de base et un type d’informations privilégiées différents :
Cette actualité s’inscrit dans une dynamique plus large qui mérite d’être suivie.
À lire également :
- Google Cloud lance llm-d 1.0 avec un routage tenant compte du cache pour les flottes de TPU et de GPU
- Améliorer Internet pour les agents d’IA pourrait le détériorer pour tous les autres utilisateurs
- Inception lance le système de langage à grande échelle (LLM) « Mercury 3 Diffusion » avec un débit de 1 068 tokens par seconde
Information publiée en premier lieu par MarkTechPost : MarkTechPost