Un développement récent dans le monde de l’IA attire l’attention.
Inception lance le système de langage à grande échelle (LLM) « Mercury 3 Diffusion » avec un débit de 1 068 tokens par seconde
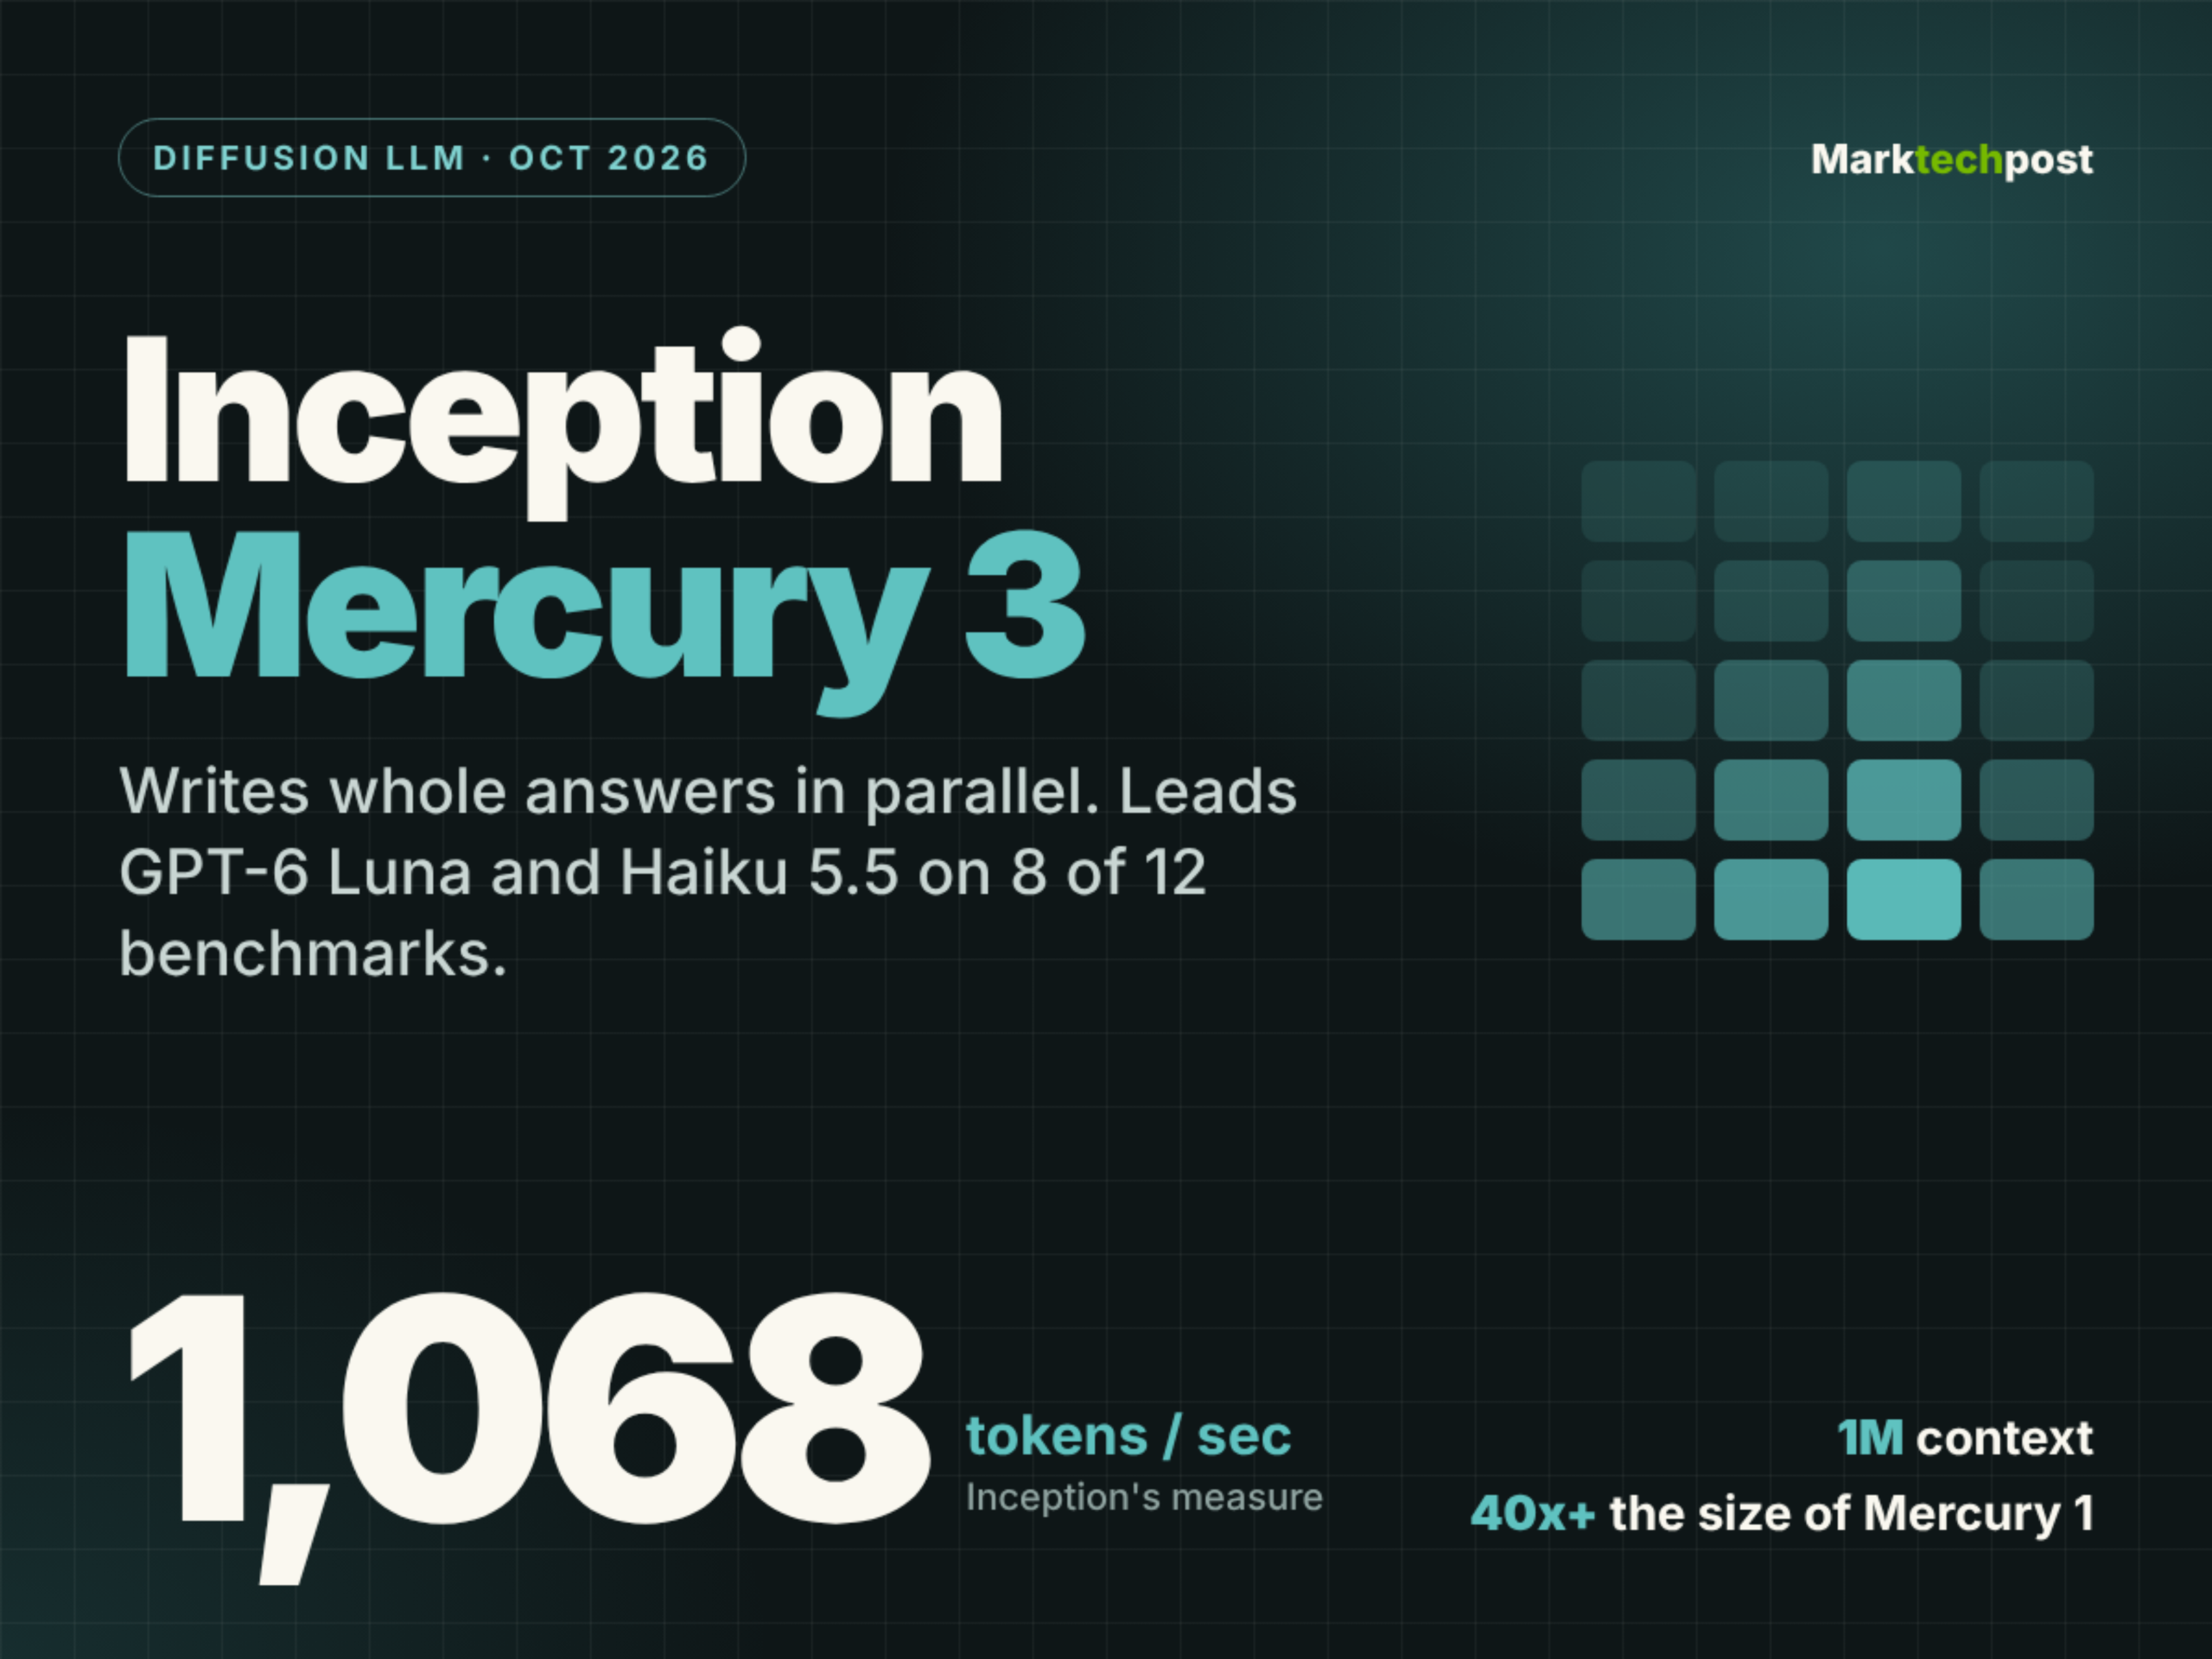
Inception a lancé Mercury 3, la toute dernière version de son modèle linguistique de diffusion. Mercury 3 est un LLM de diffusion développé par Inception qui génère des réponses en parallèle, et non token par token. Inception dévoilement un débit de 1 068 tokens par seconde sur des GPU NVIDIA, avec une fenêtre de contexte d’un million de tokens. Dans le tableau de référence d’Inception, il devance GPT-6 Luna et Claude Haiku 5.5 dans 8 des 12 tests. Pour les développeurs qui créent des agents, des bots vocaux et des outils de recherche, il s’agit d’un modèle axé sur la vitesse et offrant des scores compétitifs.
Mercury 3 est la quatrième version de Mercury développée par Inception, après Mercury 1, Mercury 2 et Mercury 2.5. Mercury 1 a été lancé en 2025. Mercury 2.5 a introduit un raisonnement paramétrable et une fenêtre de contexte de 260 000, selon l’annonce de introduction d’Inception.
La question restait de savoir si cette approche resterait valable à mesure que les modèles gagneraient en taille.
1/4 Aujourd’hui, nous lançons Mercury 3. Mercury 3 est de loin notre modèle le plus puissant et le LLM de diffusion le plus intelligent jamais lancé. Il surpasse GPT-6 Luna et Haiku 5.5 en termes de qualité, tout en fonctionnant à plus de 1 000 tok/sec. pic.twitter.com/TYevDl43Lm
En complément, les modèles autorégressifs génèrent les tokens les uns après les autres. Chaque nouveau token attend que le précédent soit généré. Un LLM de type « diffusion » part d’une ébauche de la réponse complète. Il affine ensuite chaque position au cours de plusieurs itérations menées en parallèle.
Il faut souligner, moins d’étapes séquentielles signifie un traitement plus rapide sur les mêmes GPU. La question restait de savoir si cette approche resterait valable à mesure que les modèles gagneraient en taille.
Dans ce cas précis, la réponse d’Inception est oui. Mercury 3 dispose de plus de 40 fois le nombre total de paramètres de Mercury 1 (mini). La qualité moyenne mesurée à l’aide des benchmarks standard a été multipliée par environ 3 entre ces deux modèles. La vitesse est restée supérieure à 1 000 tokens par seconde.
Parallèlement, l’équipe Inception représente ces données sous la forme d’une courbe « qualité contre taille » couvrant cinq générations de Mercury.
À suivre donc, dans un domaine qui n’a pas fini de nous surprendre.
Pour aller plus loin :
- Découvrez Drex Max : le modèle de décision multimodal de Nace AI destiné aux agents informatiques, avec un score de 67,59
- Anthropic annonce qu’elle consacre 5 % de ses actions à un « fonds d’intérêt général » | TechCrunch
- NVIDIA open-source Run:ai sous licence Apache 2.0 pour l’orchestration des GPU sur Kubernetes
Source originale : MarkTechPost : MarkTechPost