Voici une annonce qui mérite l’attention des observateurs du secteur.
NVIDIA lance Nemotron 3.5 Transcribe : un système MoE ouvert de 30 milliards de paramètres, capable de transcrire 40 langues et comptant environ 4 milliards de paramètres actifs
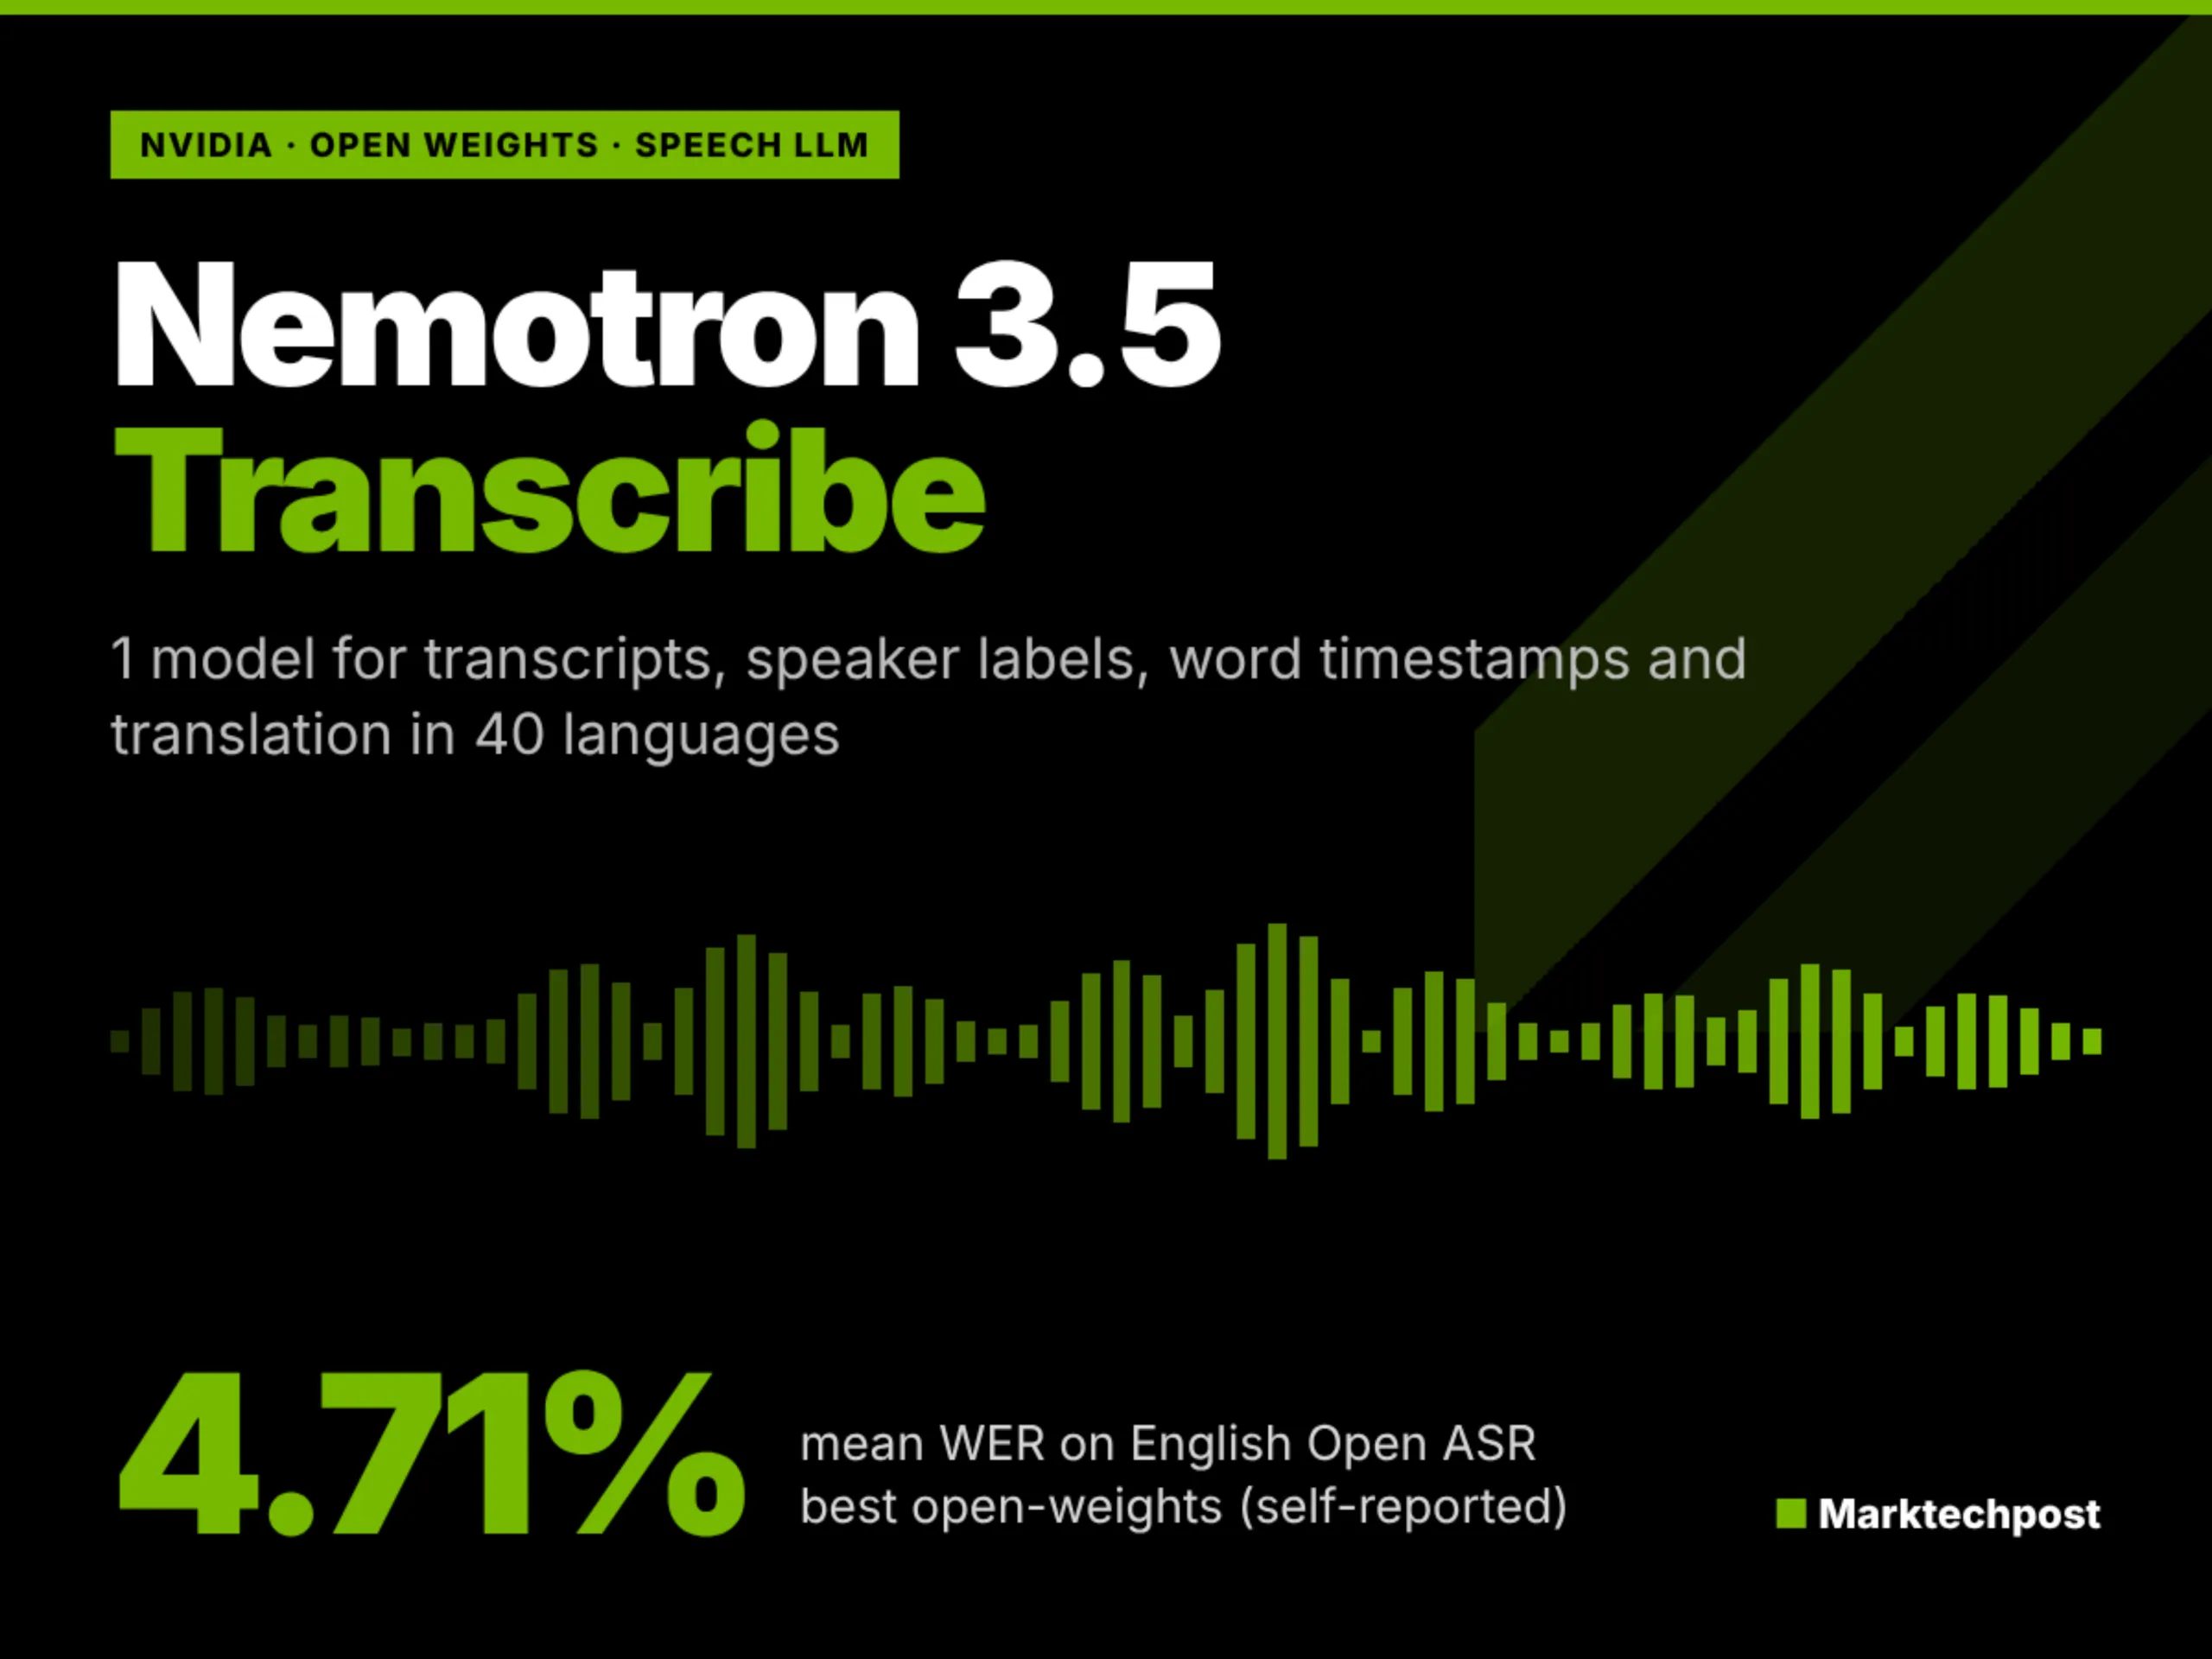
NVIDIA a lancé Nemotron 3.5 Transcribe, un modèle de langage de grande envergure (LLM) à poids ouverts, spécialement conçu pour la transcription. Un seul système prend en charge 40 langues et des enregistrements d’une durée maximale d’une heure. Une instruction textuelle permet de choisir le style de sortie pour chaque requête. Les options disponibles comprennent la transcription mot pour mot, la forme écrite, l’attribution à un locuteur, la sortie contextuelle et la traduction. Pour les développeurs, ce modèle d’IA peut remplacer les outils distincts de reconnaissance vocale (ASR), de diarisation et d’alignement.
En complément, nemotron 3.5 Transcribe est un modèle linguistique enrichi par la parole (SALM) développé par NVIDIA qui transforme les fichiers audio et les instructions en texte. Un encodeur audio transmet des représentations vectorielles à un décodeur LLM, ce qui permet d’effectuer la transcription à la demande. Le rapport de exploration technique de NVIDIA souligne qu’il n’existe pas de transcription unique et correcte. Les chiffres, les éléments de remplissage et les termes propres au domaine dépendent du public auquel s’adresse le résultat. NVIDIA présente ce système comme un spécialiste de la transcription, et non comme un assistant polyvalent.
Le rapport de exploration technique de NVIDIA souligne qu’il n’existe pas de transcription unique et correcte.
Le nom du modèle d’IA est 30B-A4B, mais le point de contrôle contient environ 34 milliards de paramètres. Ce surcroît de poids provient du module MTP de 1,3 milliard de paramètres et des composants audio.
L’entraînement a consisté en une phase de réglage fin supervisée sur 256 GPU H100 pendant 28 500 pas. Une brève phase d’apprentissage par renforcement a suivi : 400 mises à jour GSPO avec une récompense égale à 1 moins le WER. Le modèle a traité environ 1,72 million d’heures d’audio uniques, soit 6,5 millions d’heures en comptant les répétitions.
Dans le même temps, tous les chiffres ci-dessous ont été communiqués par NVIDIA dans son rapport technique.
À noter également, les poids sont fournis aux formats BF16, FP8, NVFP4 et GGUF. Le modèle d’IA préliminaire ADFlash2 est facultatif. La licence OpenMDW-1.1 autorise une utilisation commerciale.
Point notable, les environnements d’exécution comprennent vLLM 0.32.0 avec le plugin vocal theNeMo, Transformers et SGLang-Omni 0.2.0. vLLM propose une API compatible avec OpenAI.
La vitesse principale du système NVIDIA provient de son NIM « Nemotron Transcribe ». Grâce à NVFP4 et DFlash2, une carte RTX PRO 6000 Blackwell Server Edition transcrit 2 238 secondes d’audio par seconde. Elle traite un extrait de 30 secondes en 0,13 seconde. Il y a toutefois un bémol : ces optimisations ne sont pas encore open source. NVIDIA s’attend à ce que le chemin vLLM soit environ deux fois plus lent le jour de la sortie. Sur un H100 en BF16 avec MTP2, NVIDIA estime le nombre de RTFx à environ 410.
À suivre donc, dans un domaine qui n’a pas fini de nous surprendre.
Dans le même ordre d’idées :
- Retell utilise les modèles d’OpenAI pour prendre en charge 100 millions d’appels par mois
- OpenAI renforce son partenariat avec Oracle afin d’intégrer ses applications à ChatGPT
Lire l’article original sur MarkTechPost : MarkTechPost